Las herramientas de rastreo no son intercambiables
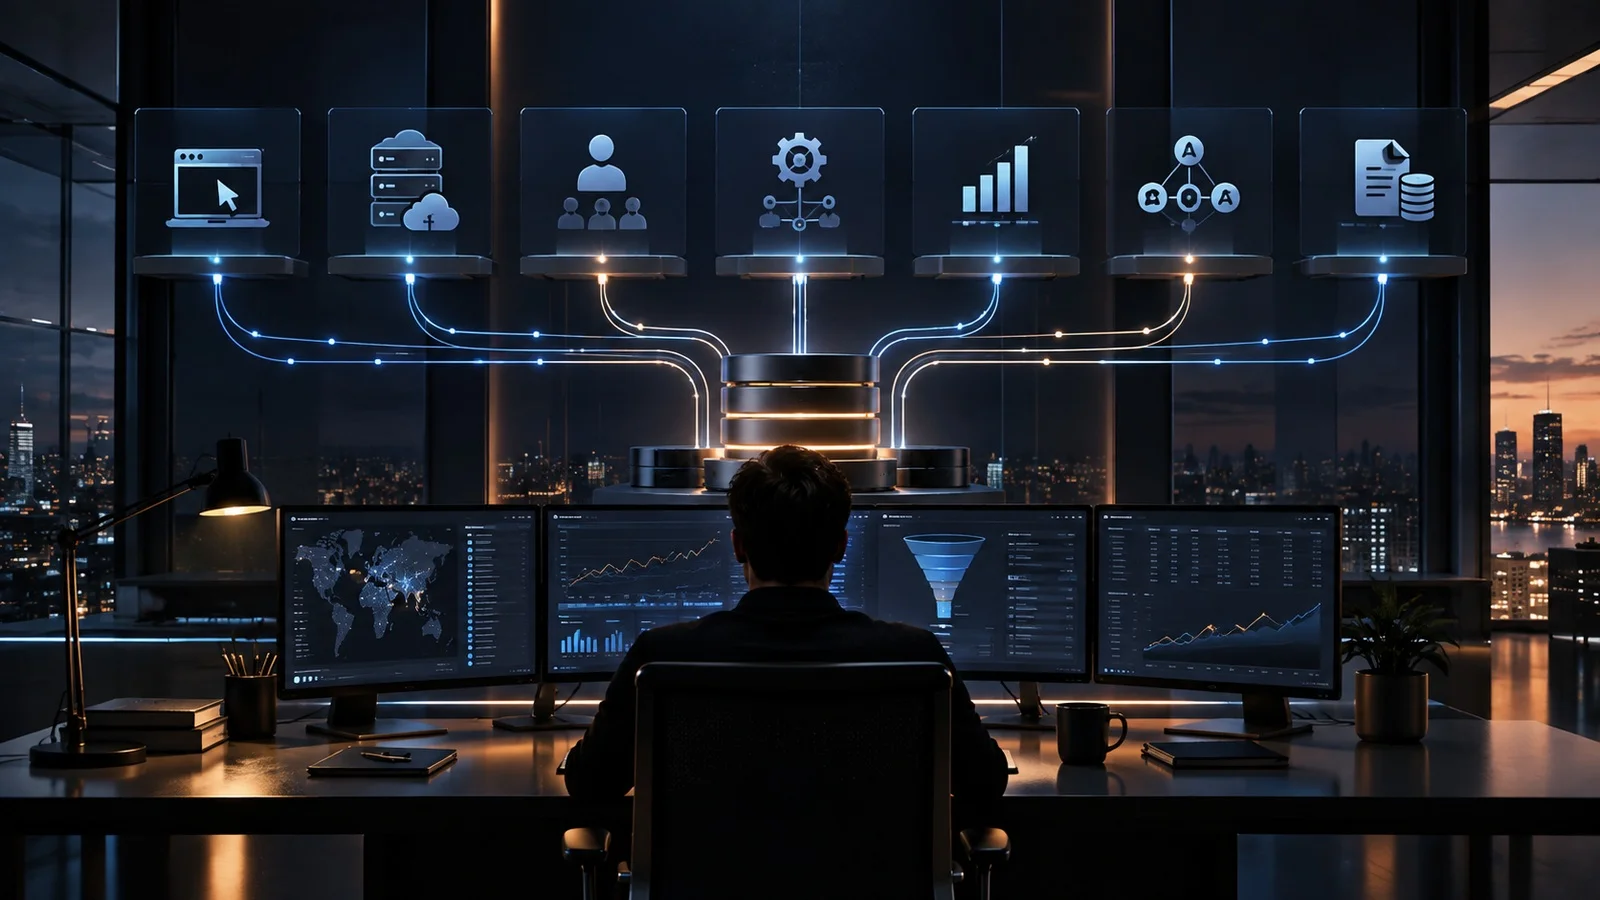
Un stack moderno de medios pagados puede contener:
- un gestor de etiquetas web;
- un gestor de etiquetas del lado del servidor;
- analytics;
- un data warehouse;
- Google Ads Data Manager;
- Meta Conversions API;
- integraciones de CRM;
- APIs de plataformas;
- herramientas de consentimiento.
Los equipos con frecuencia describen todo esto como “rastreo”.
Eso oculta la arquitectura.
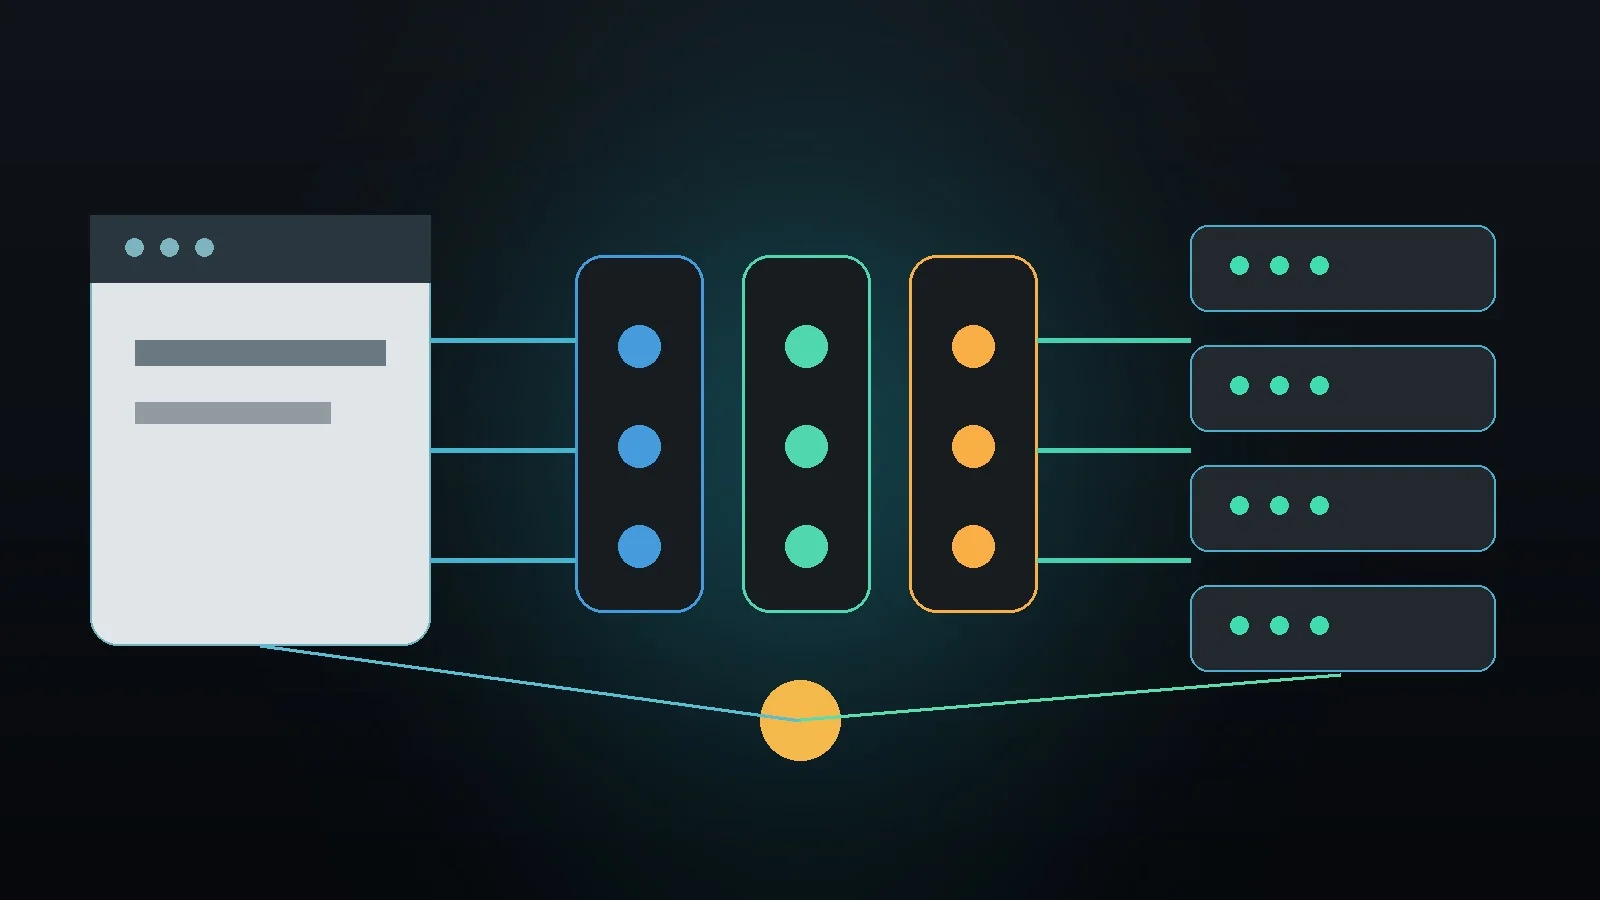
Cada capa cumple una función diferente.
Un stack de medición robusto debe responder claramente a cuatro preguntas:
¿Dónde se crea el evento?
¿Dónde se transforma?
¿Dónde se almacena como verdad de negocio?
¿Dónde se activa para publicidad?
Si esas responsabilidades no están claras, el equipo puede producir informes de plataforma con apariencia precisa que son difíciles de reconciliar con la realidad.
Capa 1: el navegador captura contexto
El navegador sigue siendo una superficie de medición importante.
Puede observar vistas de página, interacciones del usuario, datos de referencia, identificadores de clic, estado de consentimiento y contexto de sesión cercanos al usuario.
Google Tag Manager es útil porque separa gran parte de esa instrumentación de las versiones de la aplicación.
Sin embargo, el navegador no debe convertirse en la única autoridad para los resultados de negocio.
Un evento de compra disparado desde una página de agradecimiento puede bloquearse, duplicarse por recargas o dispararse antes de un reembolso posterior.
Un envío de formulario no sabe si el lead se calificó.
El navegador es más fuerte en contexto de interacción.
Los sistemas de backend son más fuertes en estado de negocio.
Esa distinción debe moldear el stack.
Capa 2: GTM es una capa de orquestación, no una base de datos
Un gestor de etiquetas web decide qué recopilar y cuándo enviar.
No es un almacenamiento duradero de verdad de negocio.
Eso parece obvio y con frecuencia se incumple.
A veces, los equipos incorporan lógica de negocio directamente en las variables del gestor de etiquetas porque es más rápido que modificar la aplicación.
Unos meses después, el contenedor contiene:
- cálculos de margen;
- clasificación de productos;
- puntuación de leads;
- excepciones de consentimiento;
- lógica de estado del cliente.
El sistema de medición ahora está ejecutando reglas de negocio dentro de una herramienta diseñada principalmente para instrumentación.
Mantenga GTM enfocado en la orquestación.
Si un valor importa para finanzas o pujas de campaña, la fuente preferida normalmente debe ser el sistema que posee ese valor.
Capa 3: el etiquetado del lado del servidor es una frontera de procesamiento
El Tag Manager del lado del servidor de Google mueve el procesamiento de eventos del navegador del usuario a un contenedor de servidor controlado por la organización.
La documentación de Google describe clients que reciben datos de entrada, los transforman en eventos y los ponen a disposición de las etiquetas del lado del servidor. Las transformaciones también pueden controlar qué parámetros de evento se exponen a las etiquetas posteriores, agregar valores o excluir campos sensibles.
Eso hace que el etiquetado del lado del servidor sea poderoso.
Eso también significa que el contenedor de servidor se convierte en infraestructura que requiere mantenimiento.
Las notas de versión del lado del servidor de Google siguieron trayendo actualizaciones de seguridad y de runtime en 2026, incluidas imágenes base actualizadas. Las implementaciones con alto tráfico pueden requerir varias instancias de Cloud Run para redundancia.
Un contenedor de servidor no es “configurar y olvidar”.
Es una aplicación.
Lo que el etiquetado del lado del servidor no hace
A veces, el etiquetado del lado del servidor se vende como una solución universal de rastreo.
No lo es.
No hace lo siguiente:
- crea consentimiento;
- corrige un evento de negocio incorrecto;
- sabe si los ingresos son rentables;
- deduplica eventos automáticamente en todas las plataformas;
- reemplaza datos de CRM;
- comprueba incrementalidad;
- garantiza la precisión de la atribución.
Le brinda a la organización una capa de procesamiento controlada.
Esa capa puede mejorar la gobernanza de datos, la resiliencia y el enrutamiento.
La calidad del evento aún depende del diseño upstream.
Capa 4: Data Manager es una capa de activación
Google Ads Data Manager debe entenderse de forma diferente del Tag Manager.
Data Manager fue diseñado para conectar fuentes de datos first-party con los productos de publicidad de Google para activación y medición.
Los cambios de Google en 2026 hacen que este rol sea más importante.
A partir de abril de 2026, Google unificó Enhanced Conversions for web y leads en una única configuración a nivel de cuenta que puede aceptar datos proporcionados por el usuario mediante etiquetas de sitio, Data Manager y conexiones de API.
A partir del 15 de junio de 2026, Google dirigió las importaciones de conversiones offline y las cargas de Enhanced Conversions for leads a la Data Manager API, bloqueando la antigua ruta de carga de la Google Ads API para la mayoría de las implementaciones.
Esto no es meramente una migración técnica.
Esto señala la arquitectura preferida de Google: conexión de datos de negocio mediante una capa de datos dedicada, en lugar de tratar cada conversión offline como una tarea de API de la cuenta de anuncios.
Para los equipos que importan resultados de CRM, Data Manager ahora pertenece a la conversación sobre el stack de medición.
Capa 5: las APIs de plataformas son contratos de destino
La Meta Conversions API, las APIs de Google y otros endpoints de plataformas son mecanismos de activación específicos de destino.
Definen:
- campos obligatorios;
- identificadores;
- formatos de evento;
- autenticación;
- comportamiento de deduplicación;
- latencia aceptada;
- respuestas de error.
El modelo de evento interno no debe diseñarse en torno a un único destino.
Construya primero un evento canónico.
Después, cree adaptadores para cada plataforma.
Esto evita que el esquema de Meta se convierta en el esquema de negocio de la empresa.
Una compra canónica puede contener:
- ID del evento;
- ID del pedido;
- hora del evento;
- valor;
- moneda;
- estado del cliente;
- IDs de productos;
- estado de consentimiento;
- información de origen.
El adaptador de Meta puede transformarla en la estructura de la Conversions API.
El adaptador de Google puede transformarla en la carga de conversión apropiada.
El data warehouse puede preservar la versión nativa de negocio.
Esa separación hace que los cambios de plataforma sean menos disruptivos.
Capa 6: el data warehouse es la capa de reconciliación
Un stack de medición necesita algún lugar para comparar sistemas.
Esto no tiene que ser un data warehouse corporativo gigantesco.
Pero necesita un lugar donde el equipo pueda responder:
- cuántos pedidos ocurrieron realmente;
- qué ingresos se realizaron;
- qué eventos se enviaron a cada plataforma;
- qué se rechazó;
- qué llegó tarde;
- qué clientes eran nuevos;
- qué leads se calificaron;
- qué campañas recibieron crédito.
Sin reconciliación, el equipo evalúa el rastreo mirando el destino que intenta validar.
Esto es circular.
Si Meta reporta 1.200 compras, Meta no puede ser el único sistema usado para decidir si ocurrieron 1.200 compras.
Incorpore identificadores a la arquitectura
La reconciliación depende de identificadores estables.
Ejemplos importantes incluyen:
- ID de la transacción;
- ID del lead;
- ID del evento;
- ID del cliente;
- identificadores de clic;
- ID del producto.
Siempre que sea posible, el identificador debe ser generado por el sistema que posee el evento.
Una compra no debe recibir un ID aleatorio exclusivo del navegador si el sistema de comercio ya tiene un ID de pedido.
Un lead no debe convertirse en un nuevo evento cada vez que cambia una etapa del CRM si el mismo lead puede referenciarse de forma consistente.
Los identificadores estables permiten la deduplicación, la depuración y las actualizaciones del ciclo de vida.
El consentimiento debe viajar con el evento
El consentimiento no es una decoración de la interfaz de usuario.
El sistema de medición debe saber el estado de privacidad bajo el cual se procesa un evento.
Como mínimo, los equipos deben entender:
- para qué se otorgó el consentimiento;
- qué región aplica;
- qué identificadores pueden usarse;
- qué destinos pueden recibir el evento;
- si el consentimiento cambió posteriormente;
- qué datos deben eliminarse o restringirse.
El procesamiento del lado del servidor puede facilitar la gobernanza porque los datos pueden transformarse antes de enviarse al exterior.
Las transformaciones del Tag Manager de Google, por ejemplo, pueden controlar qué parámetros se exponen a etiquetas específicas.
Ese poder aumenta la responsabilidad.
Un pipeline de servidor oculto debe ser más auditable que un pipeline de navegador, no menos.
El monitoreo debe diseñarse antes del lanzamiento
Los incidentes de rastreo con frecuencia se descubren a través del rendimiento de las campañas.
El CPA de repente se duplica.
El equipo de medios investiga.
Horas después, alguien nota que los eventos de compra se detuvieron.
Esto está invertido.
El stack de medición debe automonitorearse.
Los monitores útiles incluyen:
- volumen de eventos versus línea base;
- tasa de éxito por destino;
- errores de API;
- tasa de deduplicación;
- latencia;
- identificadores ausentes;
- variación de valor;
- proporción entre navegador y servidor;
- volumen de importación de resultados del CRM;
- salud del contenedor de servidor;
- credenciales expiradas.
La severidad debe reflejar el impacto en el negocio.
Una caída del 5% en un evento de diagnóstico puede ser de baja prioridad.
Una caída del 40% en los eventos primarios de compra es un incidente.
Modo de falla: comprar rastreo del lado del servidor antes de corregir el diseño del evento
Un equipo ve pérdida de atribución y decide implementar el etiquetado del lado del servidor.
El evento de compra existente ya está incorrecto.
Se dispara antes de la confirmación del pago.
La infraestructura del lado del servidor ahora envía el evento incorrecto de forma más confiable.
Esta es una falla clásica de medición.
La calidad de la infraestructura no puede reparar la calidad semántica.
Defina primero el evento de negocio.
Después, mejore el transporte.
Modo de falla: rutas duplicadas sin responsable
Un stack moderno común contiene varias rutas superpuestas:
- el navegador envía la conversión de Google Ads;
- el navegador envía a GA4;
- el servidor envía a GA4;
- el servidor envía a Google Ads;
- la integración de ecommerce envía otra compra;
- Data Manager importa resultados offline.
Cualquiera de las rutas puede ser válida.
En conjunto, exigen deduplicación y responsabilidad claras.
Documente cada ruta.
Para cada conversión primaria, el equipo debe ser capaz de trazar el camino del evento de negocio hasta el destino.
Si nadie puede hacerlo, el stack es demasiado opaco.
Modo de falla: medir el stack de medición con afirmaciones de lift de la plataforma
Los proveedores y las plataformas con frecuencia publican afirmaciones de lift de conversión para el rastreo mejorado.
Esos resultados pueden justificar pruebas.
No deben sustituir la validación interna.
La evaluación correcta es:
- ¿Mejoró la tasa de coincidencia?
- ¿Aparecieron eventos válidos que antes faltaban?
- ¿Mejoró la reconciliación con la verdad de negocio?
- ¿Mejoró el rendimiento de las pujas sin inflar duplicados?
- ¿El nuevo sistema redujo las fallas operativas?
- ¿Mejoró la gobernanza de privacidad?
Más conversiones atribuidas no significan automáticamente una mejor medición.
Una mejor correspondencia con resultados reales de negocio lo es.
Elija la arquitectura más simple que sobreviva a su complejidad
No toda empresa necesita un data warehouse, GTM del lado del servidor, APIs directas y una capa de identidad dedicada.
Un pequeño negocio de ecommerce con una única tienda y rastreo de compras estándar puede atenderse mejor con:
- una capa de datos limpia;
- GTM web;
- Enhanced Conversions;
- integraciones nativas de la plataforma;
- IDs de transacción confiables;
- reconciliación básica.
Un negocio de generación de leads en varios mercados con un ciclo de ventas de 60 días puede necesitar:
- instrumentación web;
- procesamiento en el servidor;
- modelo de eventos de CRM;
- Data Manager API;
- APIs de plataformas;
- reconciliación en el data warehouse;
- monitoreo.
La prueba no es sofisticación.
La prueba es si la arquitectura hace que el resultado de negocio sea más observable y más confiable.
La infraestructura de medición debe reducir la ambigüedad
El stack de medición existe porque los sistemas de medios pagados toman decisiones financieras a partir de datos.
Su trabajo no es maximizar el número de eventos.
Su trabajo es crear un camino controlado desde el comportamiento del cliente hasta la verdad de negocio y la activación publicitaria.
GTM, el etiquetado del lado del servidor, Data Manager y las APIs de plataformas son herramientas dentro de ese camino.
La arquitectura es el acuerdo que le dice a cada herramienta qué posee.