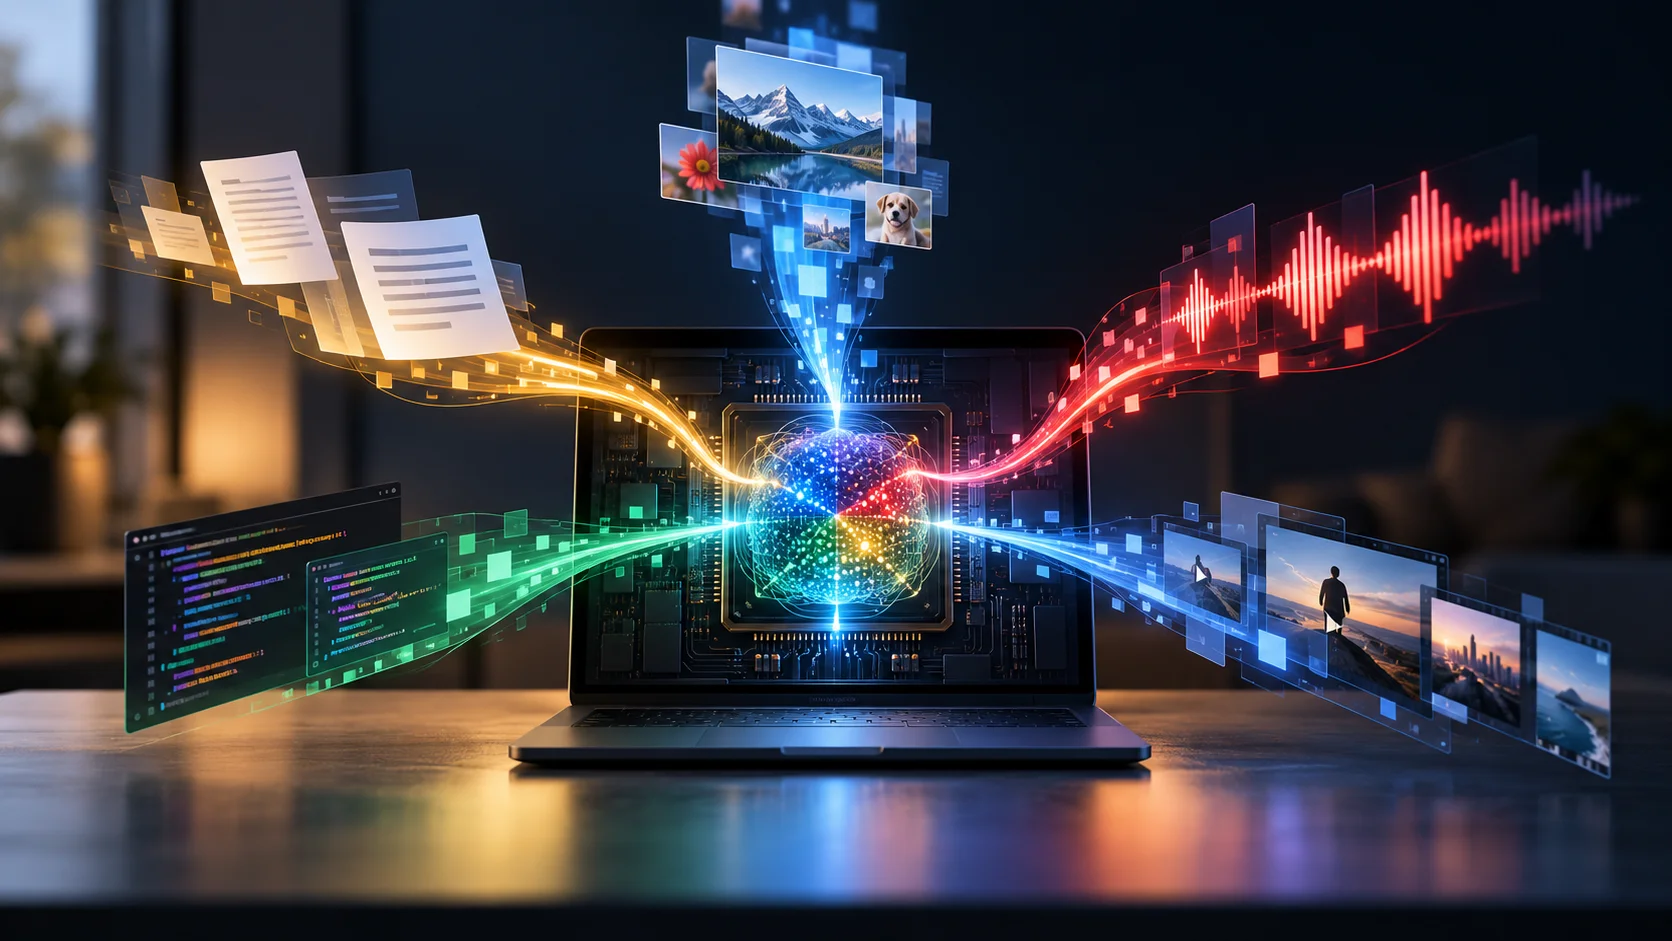
O Google DeepMind lançou nesta terça-feira (6) o EmbeddingGemma 2, seu primeiro modelo aberto de embeddings nativamente multimodal voltado à execução local. Com até 740 milhões de parâmetros, ele reúne texto, código, imagens, vídeo e áudio em um mesmo espaço vetorial, permitindo realizar buscas entre diferentes tipos de conteúdo diretamente em celulares, computadores e outros dispositivos.
Na prática, a tecnologia permite encontrar uma imagem usando uma descrição em texto, localizar um momento específico de um vídeo a partir de uma consulta ou relacionar arquivos de formatos diferentes sem depender do processamento em nuvem. O Google também demonstrou buscas em mídias armazenadas localmente que funcionam sem conexão com a internet.
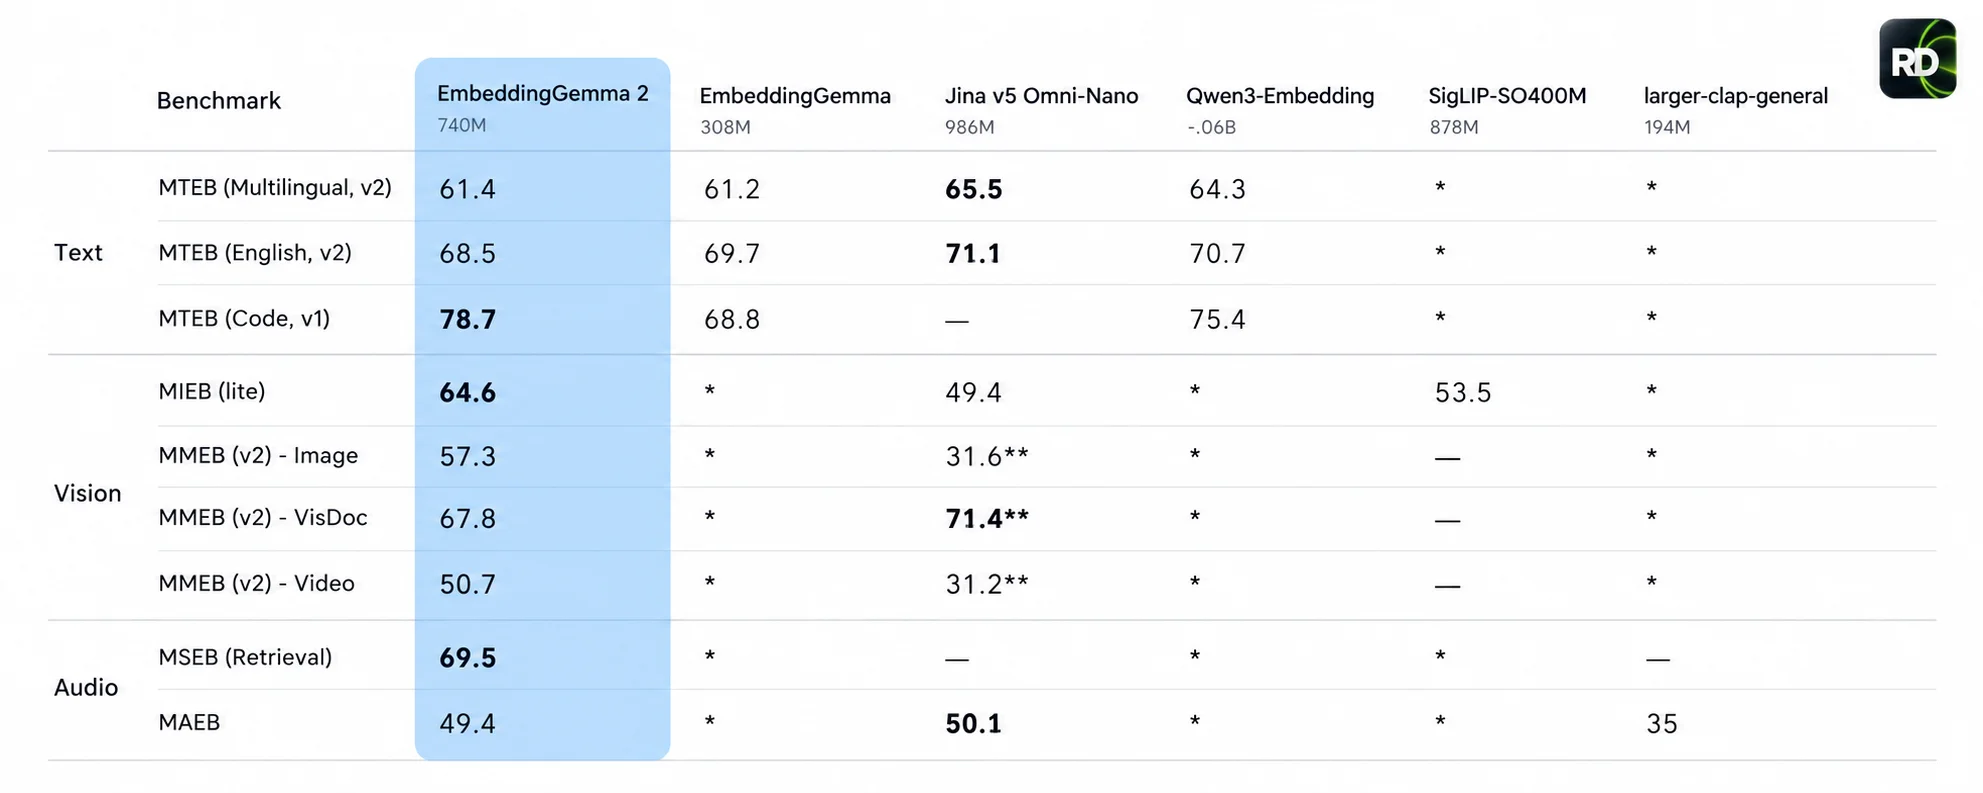
O modelo foi desenvolvido para reduzir a necessidade de combinar sistemas separados de reconhecimento de imagem, transcrição de áudio e geração de embeddings. Segundo o Google, o EmbeddingGemma 2 apresenta desempenho competitivo para seu tamanho e amplia as capacidades da geração anterior para tarefas envolvendo código, visão, vídeo e áudio.
Arquitetura permite carregar apenas os recursos necessários
O EmbeddingGemma 2 usa uma arquitetura modular. A configuração destinada a texto e código possui 270 milhões de parâmetros; ao adicionar visão, chega a 440 milhões; com texto e áudio, a 570 milhões; e a versão multimodal completa utiliza 740 milhões. Todas projetam o conteúdo para um mesmo espaço vetorial de 768 dimensões.
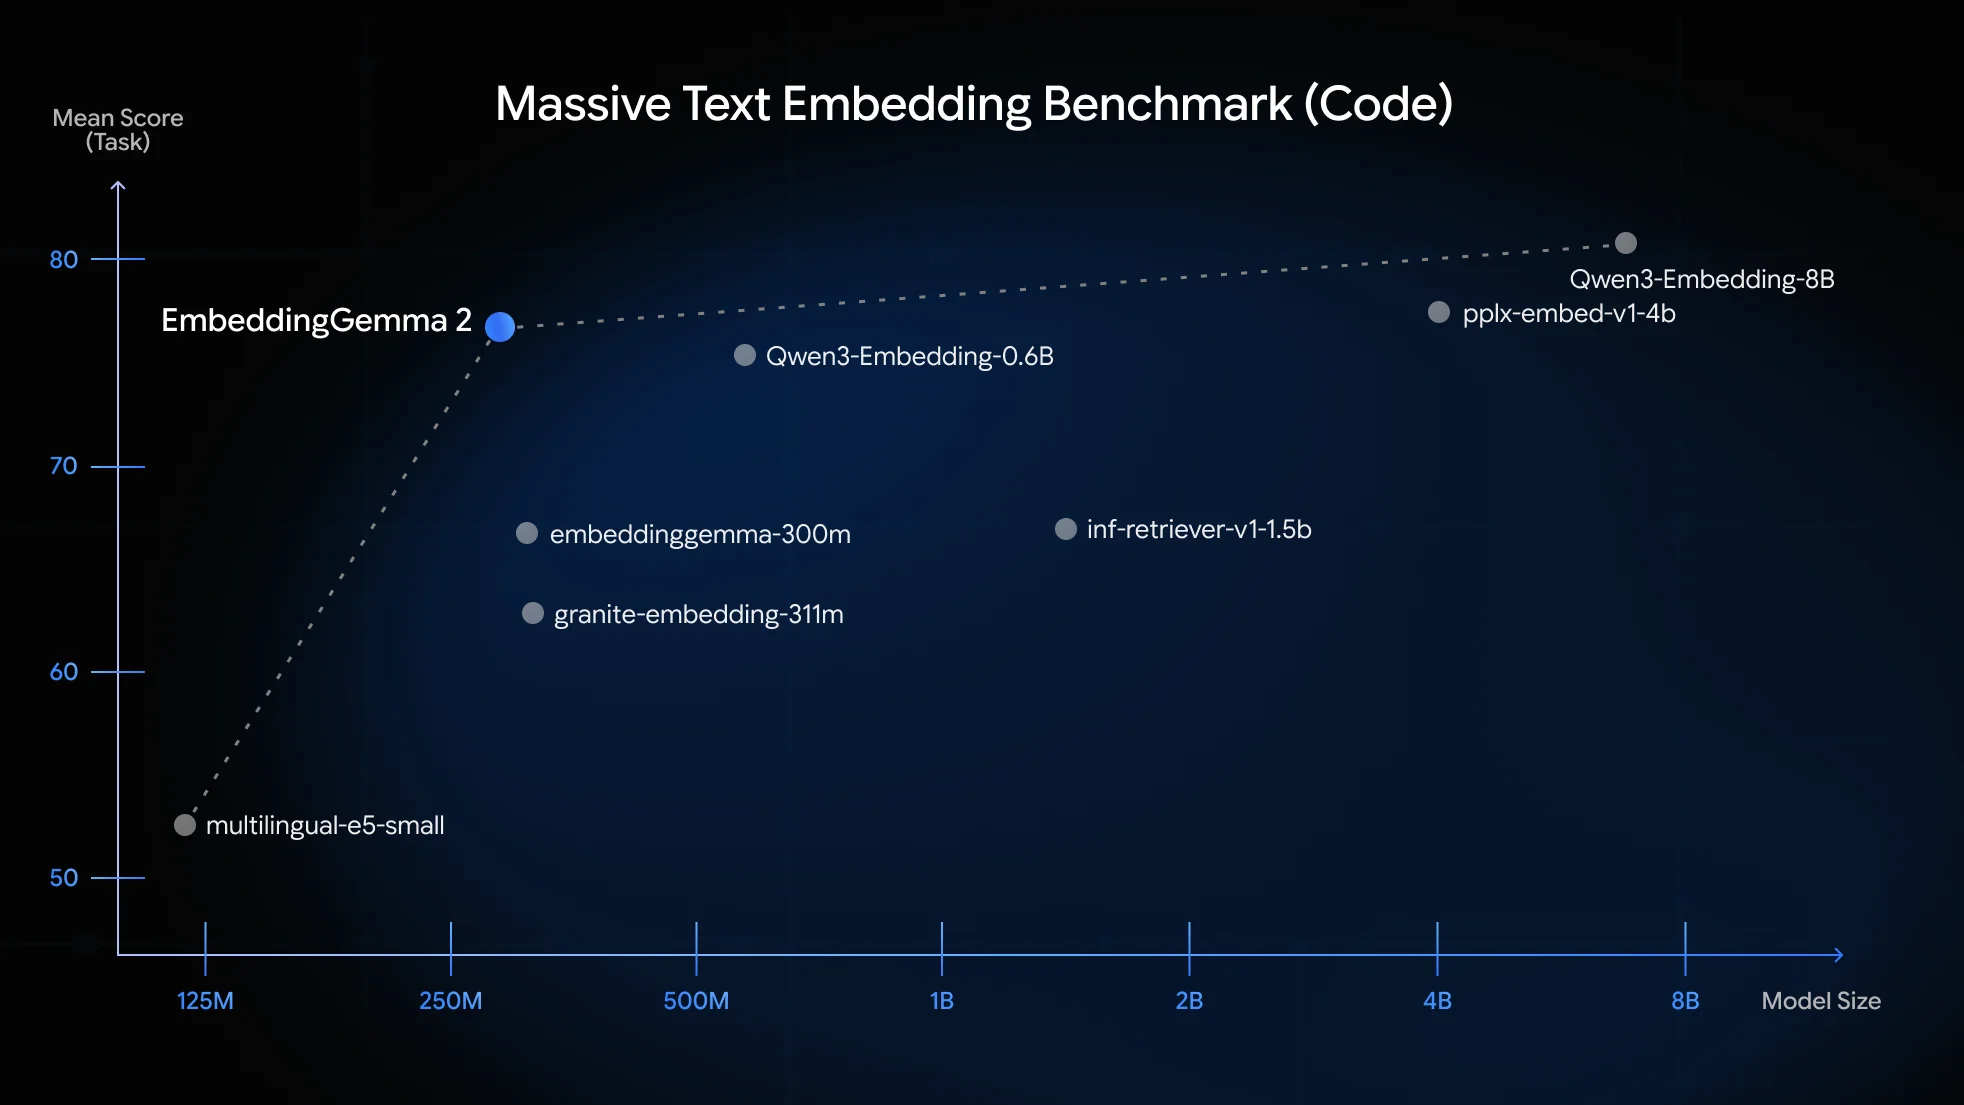
Em código, o modelo registrou 78,7 pontos no MTEB Code. O Google afirma que o desempenho representa uma melhora de 14% sobre a geração anterior. Como essa tarefa utiliza apenas texto e código, o benchmark pode ser executado com a configuração de 270 milhões de parâmetros, sem carregar os módulos de visão e áudio.
A arquitetura modular também reduz o consumo de memória. Em medições divulgadas pelo Google, a configuração apenas para texto utiliza cerca de 191 MB de RAM ativa, enquanto o modelo multimodal completo exige aproximadamente 567 MB em um Pixel 11 Pro.
O sistema ainda permite reduzir o tamanho dos vetores armazenados. Com 256 dimensões, o espaço necessário cai para um terço do utilizado pela configuração padrão de 768 dimensões, mantendo aproximadamente 95% da qualidade original nas avaliações de recuperação de imagem, vídeo e fala feitas pelo Google.
Outra aplicação é o RAG local, no qual documentos, imagens e outros arquivos podem ser recuperados no próprio dispositivo antes de serem enviados a um modelo generativo. Como o EmbeddingGemma 2 é baseado no Gemma 4 e compartilha componentes da arquitetura com essa família, os modelos podem ser combinados com menor sobreposição de recursos.
O Google também demonstrou o modelo em recursos de busca instantânea de fotos e vídeos e em uma ferramenta capaz de encontrar momentos específicos dentro de gravações locais. A empresa pretende levar essas capacidades ao ML Kit para Android nas próximas semanas, com suporte a aceleração por NPU em dispositivos compatíveis.
O EmbeddingGemma 2 foi disponibilizado sob licença Apache 2.0, com pesos acessíveis para desenvolvedores e suporte a ferramentas como Hugging Face Transformers, sentence-transformers, MLX, Ollama e LiteRT.