Google DeepMind lanzó este martes (6) el EmbeddingGemma 2, su primer modelo abierto de embeddings nativamente multimodal orientado a la ejecución local. Con hasta 740 millones de parámetros, reúne texto, código, imágenes, video y audio en un mismo espacio vectorial, lo que permite realizar búsquedas entre distintos tipos de contenido directamente en teléfonos móviles, computadoras y otros dispositivos.
En la práctica, la tecnología permite encontrar una imagen usando una descripción en texto, localizar un momento específico de un video a partir de una consulta o relacionar archivos de formatos diferentes sin depender del procesamiento en la nube. Google también demostró búsquedas en medios almacenados localmente que funcionan sin conexión a internet.
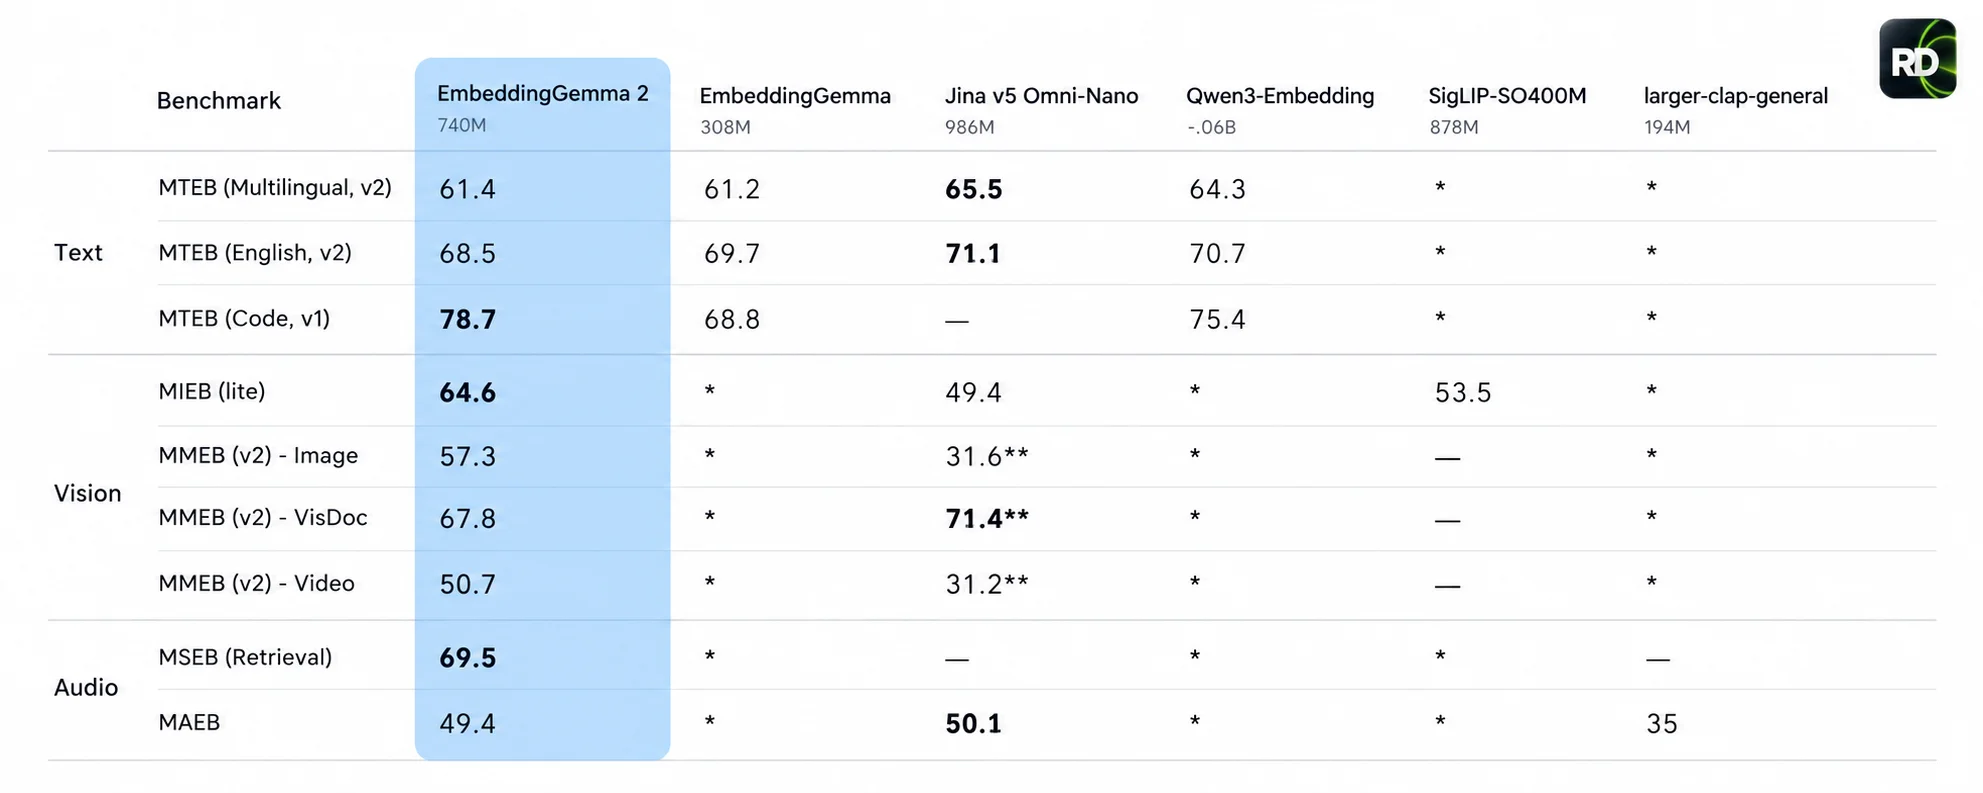
El modelo fue desarrollado para reducir la necesidad de combinar sistemas separados de reconocimiento de imágenes, transcripción de audio y generación de embeddings. Según Google, EmbeddingGemma 2 presenta un rendimiento competitivo para su tamaño y amplía las capacidades de la generación anterior para tareas que involucran código, visión, video y audio.
La arquitectura permite cargar solo los recursos necesarios
EmbeddingGemma 2 usa una arquitectura modular. La configuración destinada a texto y código tiene 270 millones de parámetros; al añadir visión, llega a 440 millones; con texto y audio, a 570 millones; y la versión multimodal completa utiliza 740 millones. Todas proyectan el contenido a un mismo espacio vectorial de 768 dimensiones.
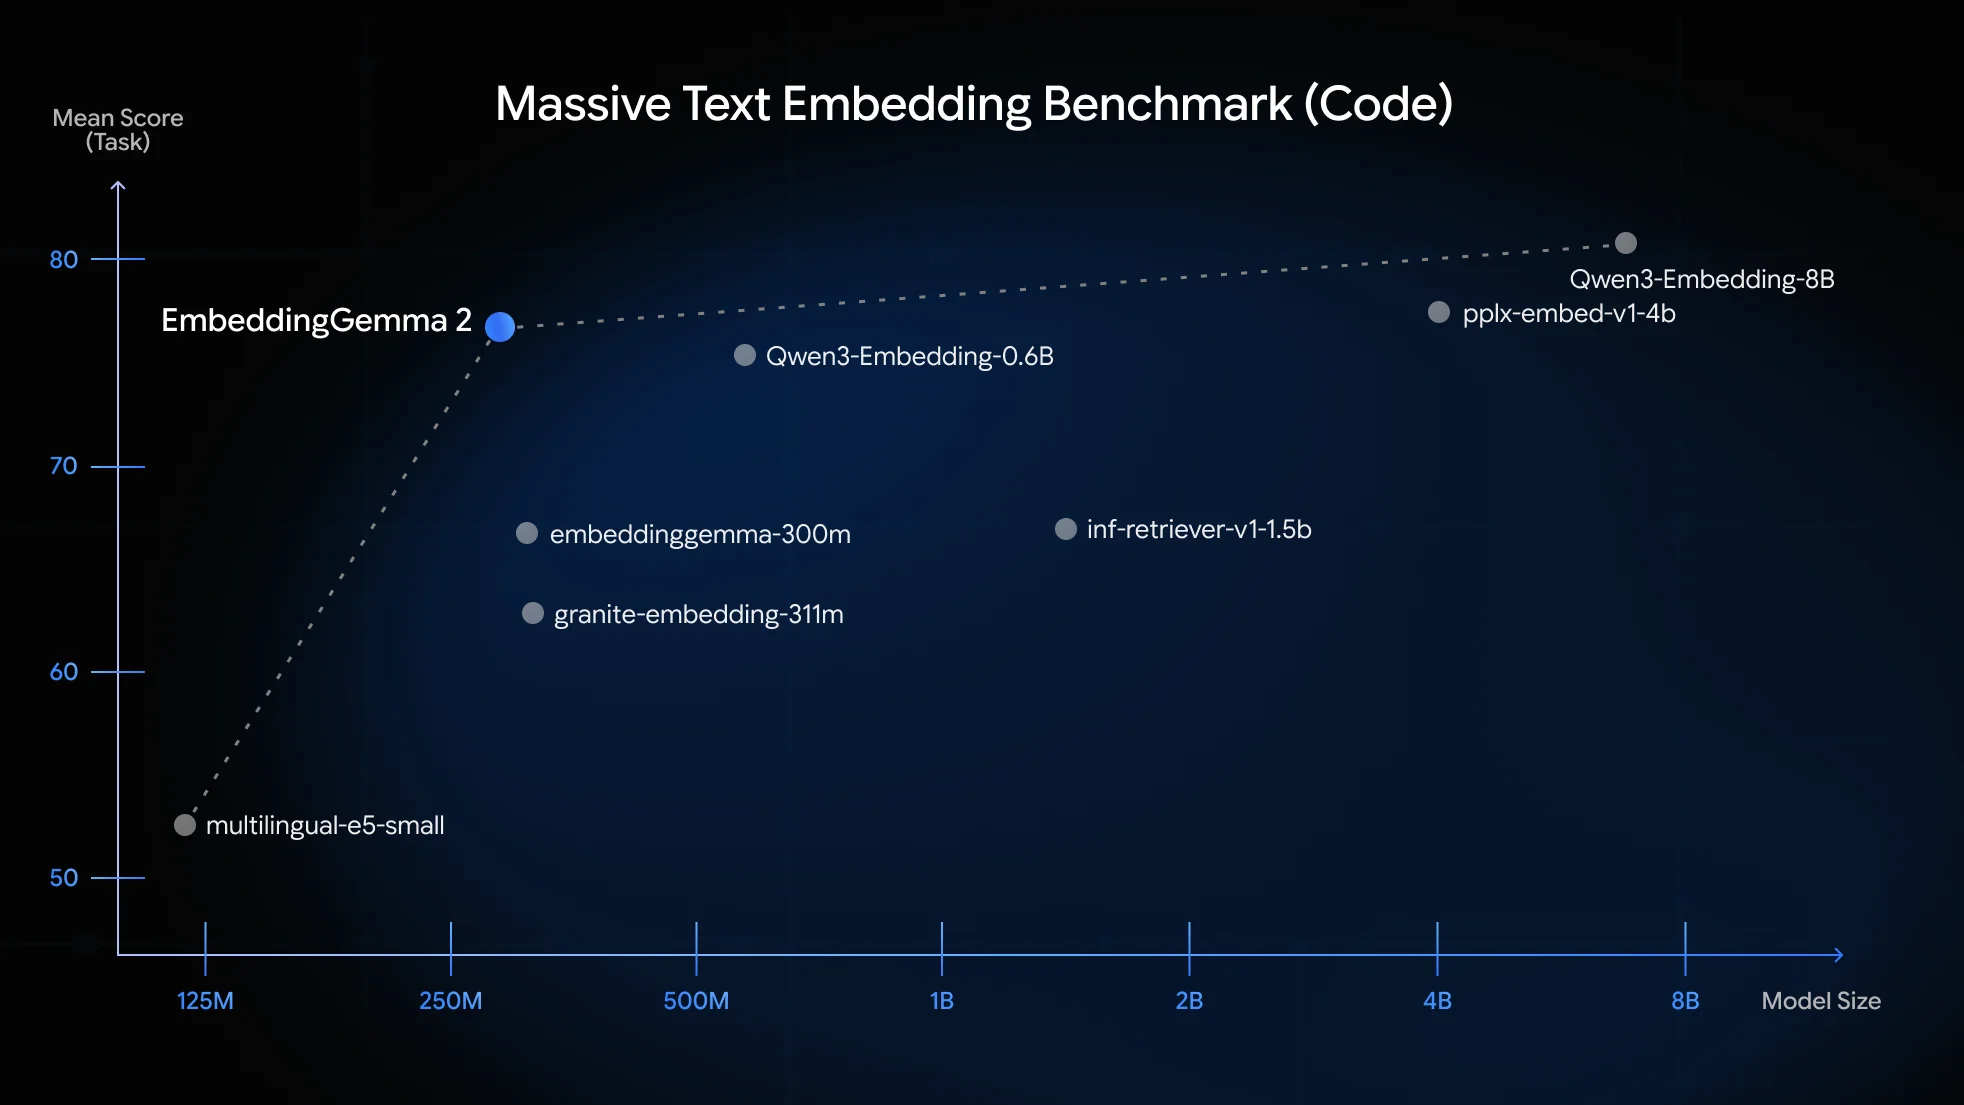
En código, el modelo registró 78,7 puntos en MTEB Code. Google afirma que el rendimiento representa una mejora del 14% sobre la generación anterior. Como esta tarea utiliza solo texto y código, el benchmark puede ejecutarse con la configuración de 270 millones de parámetros, sin cargar los módulos de visión y audio.
La arquitectura modular también reduce el consumo de memoria. En mediciones divulgadas por Google, la configuración solo para texto utiliza alrededor de 191 MB de RAM activa, mientras que el modelo multimodal completo exige aproximadamente 567 MB en un Pixel 11 Pro.
El sistema también permite reducir el tamaño de los vectores almacenados. Con 256 dimensiones, el espacio necesario cae a un tercio del utilizado por la configuración estándar de 768 dimensiones, manteniendo aproximadamente 95% de la calidad original en las evaluaciones de recuperación de imagen, video y voz realizadas por Google.
Otra aplicación es el RAG local, en el que documentos, imágenes y otros archivos pueden recuperarse en el propio dispositivo antes de enviarse a un modelo generativo. Como EmbeddingGemma 2 se basa en Gemma 4 y comparte componentes de la arquitectura con esa familia, los modelos pueden combinarse con menor superposición de recursos.
Google también demostró el modelo en funciones de búsqueda instantánea de fotos y videos y en una herramienta capaz de encontrar momentos específicos dentro de grabaciones locales. La empresa pretende llevar estas capacidades al ML Kit para Android en las próximas semanas, con soporte para aceleración por NPU en dispositivos compatibles.
EmbeddingGemma 2 se puso a disposición bajo licencia Apache 2.0, con pesos accesibles para desarrolladores y soporte para herramientas como Hugging Face Transformers, sentence-transformers, MLX, Ollama y LiteRT.