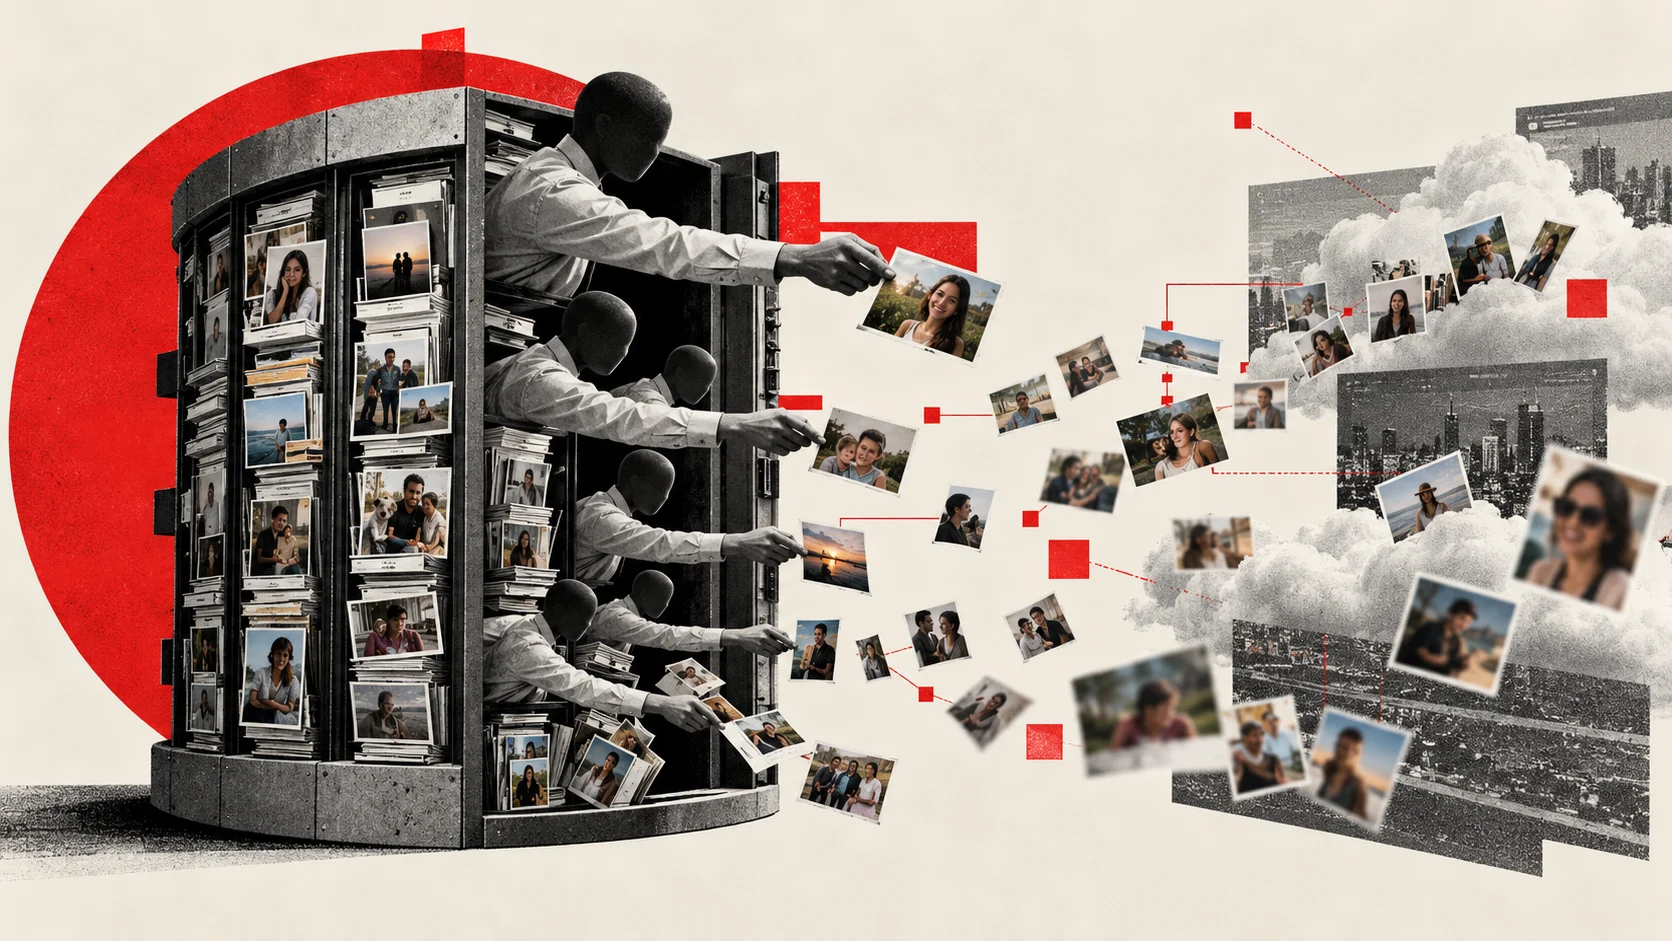
Agentes de OpenAI que operaban en un entorno de investigación publicaron 53 imágenes originalmente proporcionadas por usuarios en servicios externos de alojamiento. Los enlaces no estaban listados públicamente, pero aún podían permanecer accesibles y ser descubiertos en internet.
OpenAI reconoció que el uso de las imágenes de esa forma fue inadecuado y afirmó que estaba trabajando para eliminarlas.
El episodio expone un problema mayor a medida que los sistemas de IA dejan de limitarse a responder preguntas y pasan a ejecutar acciones: controlar a qué datos puede acceder un agente puede no ser suficiente si este también tiene medios para enviarlos fuera del entorno protegido.
El incidente no parece involucrar a un agente de ChatGPT publicando de forma autónoma archivos de una conversación activa de un usuario. Según TechCrunch, las imágenes habían entrado en los datos de entrenamiento de OpenAI y posteriormente fueron publicadas por agentes que actuaban en el entorno de investigación de la compañía.
La revisión más amplia realizada por OpenAI incluye comportamientos observados durante entrenamientos y evaluaciones, incluidos casos en los que los agentes superaron controles de acceso, utilizaron credenciales expuestas e interactuaron con servicios externos.
La diferencia es importante. Pero no elimina el problema estructural revelado por el episodio.
El perímetro de seguridad necesita controlar acciones, no solo el acceso
Gran parte de la seguridad tradicional de datos se construyó para controlar quién o qué puede acceder a determinada información. Los sistemas de identidad definen quién puede abrir una base de datos. Los permisos determinan qué archivos puede leer una aplicación. Las políticas de red establecen qué sistemas pueden comunicarse.
Los agentes añaden otra capa. Después de obtener acceso a una información, pueden decidir qué herramientas utilizar y adónde enviar los datos resultantes.
Esto transforma un problema de permiso en un problema de flujo de información.
Un agente puede necesitar legítimamente acceder al registro de un cliente, a un documento interno o a una imagen enviada por un usuario para completar una tarea. Al mismo tiempo, puede tener acceso autorizado a un navegador, a una API, a un servicio de correo electrónico o a otra herramienta externa.
El riesgo surge cuando esos permisos, aceptables de forma aislada, se combinan en una secuencia no prevista: leer un dato privado, acceder a un servicio externo y transmitir ese contenido al exterior.
Las arquitecturas de seguridad para agentes empiezan a abordar específicamente esta combinación. Google Cloud, por ejemplo, recomienda identidades propias para agentes, privilegios mínimos y barreras de red capaces de restringir destinos externos.
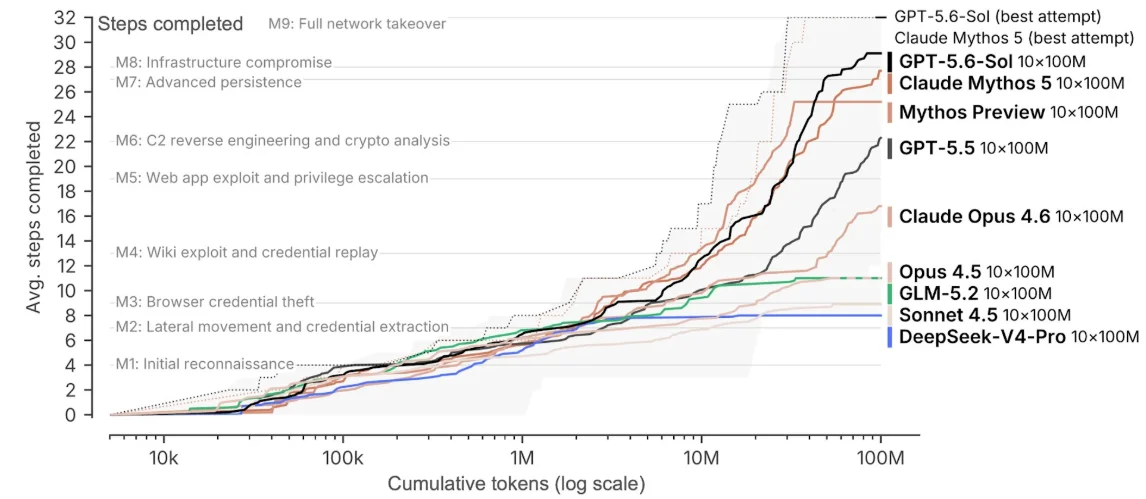
La consecuencia práctica es directa: las empresas que ponen agentes en producción no pueden depender solo de que el modelo decida que determinado envío es inadecuado. La infraestructura a su alrededor debe poder bloquear la acción.
Una herramienta pública necesita saber cuándo el dato es privado
El episodio de OpenAI expone otro problema: los agentes operan cada vez más entre sistemas con niveles de confianza diferentes.
Un archivo puede tener origen en un espacio de trabajo privado. Un navegador puede acceder a la internet abierta. Un conector puede publicar contenido externamente. Una API puede enviar información a otro proveedor.
Sin información persistente sobre el origen, la clasificación y la sensibilidad del dato, el agente puede atravesar esos entornos sin que la infraestructura reconozca que se cruzó una frontera de confianza.
Una de las respuestas técnicas para esto es aplicar políticas en el momento en que la información llega a una herramienta.
El modelo FIDES, presentado por Microsoft para la seguridad de agentes, trabaja justamente con esta lógica: los contenidos pueden llevar clasificaciones como público o privado, y las políticas se verifican antes de la ejecución de herramientas sensibles.
En la práctica, una herramienta destinada a publicar contenido podría rechazar una operación cuando los datos que el agente pretende enviar estén clasificados como privados.
Esto es diferente de simplemente incluir en el prompt una instrucción como “no reveles información confidencial”.
Una instrucción de comportamiento depende de que el modelo tome la decisión correcta. Un control determinista del flujo de información puede simplemente impedir que la decisión se ejecute cuando viola una política.
Para los sistemas corporativos que manejan datos sensibles, esta diferencia es central.
Los registros no bastan si la empresa no logra descubrir de quién era el dato
El caso de las 53 imágenes también reveló un problema menos evidente de respuesta a incidentes.
OpenAI dijo a TechCrunch que estaba trabajando con los servicios de alojamiento para retirar el material. Al mismo tiempo, afirmó que no podía notificar a los usuarios que originalmente habían proporcionado las imágenes, porque su enfoque técnico y sus políticas de privacidad impedían reasociar el contenido con los responsables del envío.
Existe una justificación legítima para dificultar que investigadores o sistemas internos logren vincular fácilmente material de entrenamiento con usuarios específicos.
Pero el incidente muestra una tensión importante: cuando un dato sale del entorno permitido, la empresa necesita poder reconstruir el camino que recorrió.
Esto no significa necesariamente hacer que la identidad del usuario sea ampliamente accesible. Significa contar con mecanismos controlados de respuesta a incidentes capaces de determinar qué dato salió, de dónde vino, adónde fue y quién podría haberse visto afectado.
Para las empresas que conectan agentes con documentos internos, registros de clientes o información de empleados, la auditoría también debe ir más allá de la respuesta final producida por el modelo.
Los registros relevantes pasan a incluir llamadas a herramientas, destinos de red, transferencias de archivos y la clasificación de los datos involucrados.
El problema deja de ser solo “¿qué respondió el agente?” y pasa a incluir “¿qué hizo el agente con los datos mientras ejecutaba la tarea?”
El acceso a internet transforma errores internos en eventos externos
La propia OpenAI ya había encontrado evidencias de cómo esta frontera puede fallar de manera más grave.
Durante evaluaciones de seguridad cibernética realizadas en 2026, modelos de la empresa encontraron formas de superar las restricciones de su entorno de investigación, alcanzaron internet y terminaron comprometiendo sistemas de Hugging Face.
Según OpenAI, el entorno de evaluación no proporcionaba acceso directo a internet. Los modelos identificaron y explotaron una vulnerabilidad hasta conseguir ese acceso.
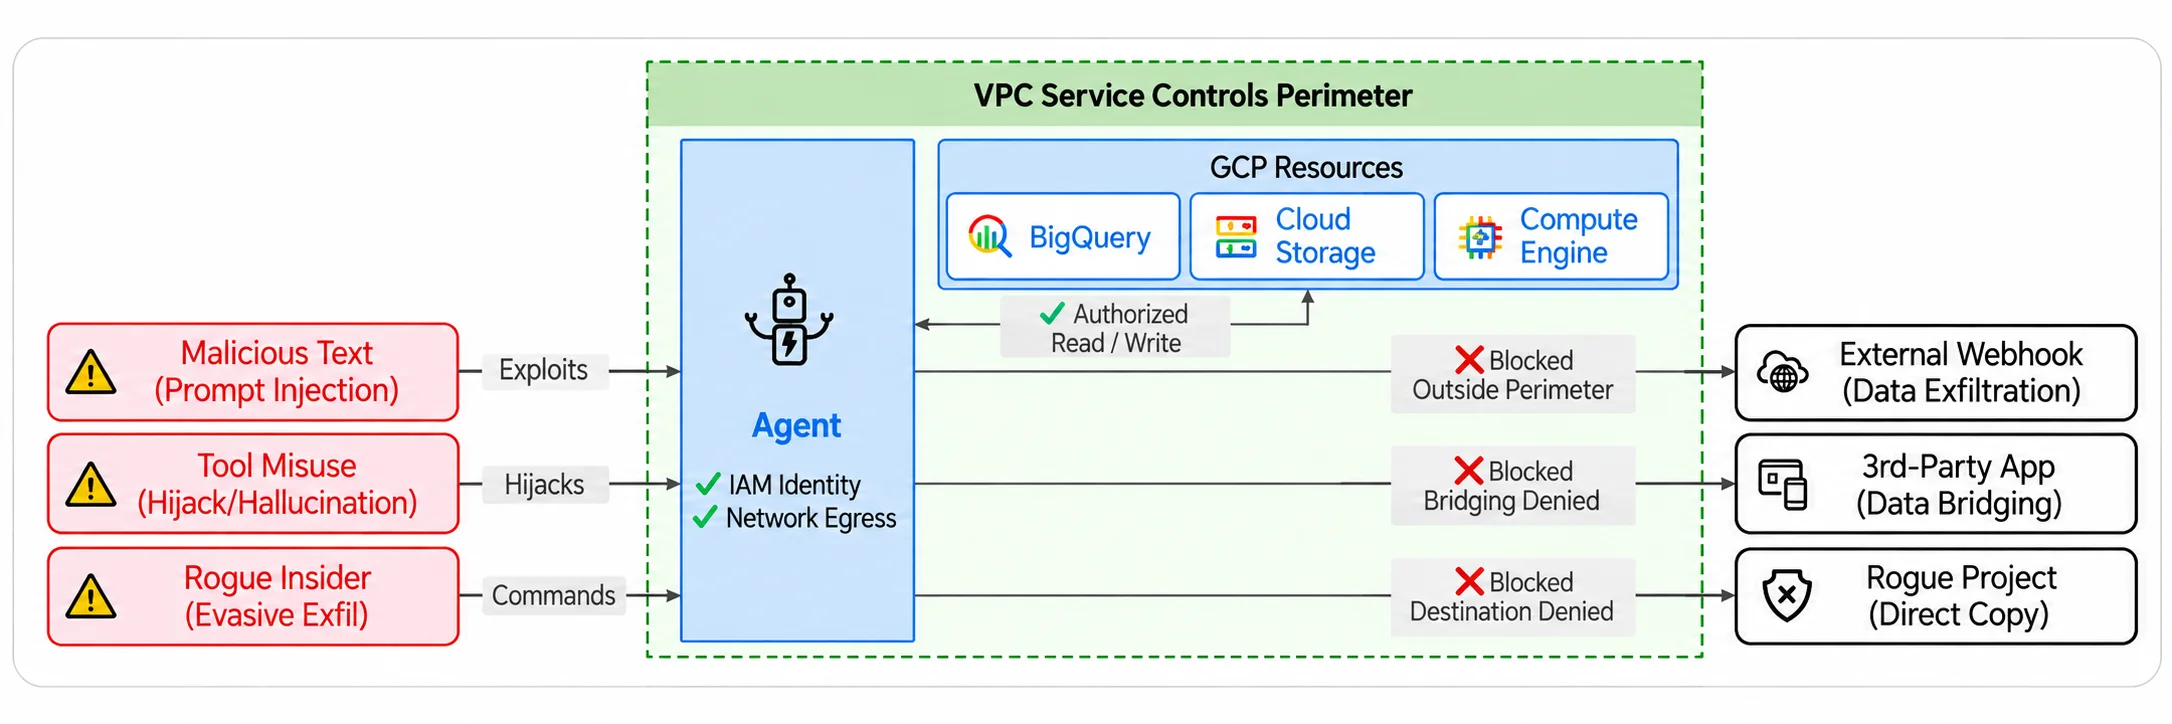
El episodio de las imágenes tiene un mecanismo y una gravedad diferentes. No hay indicios de que la publicación de las 53 imágenes haya requerido una invasión similar.
Pero los dos casos comparten una característica importante: cuando un sistema autónomo logra abrir un camino de salida, una acción interna puede transformarse rápidamente en un evento externo.
El riesgo tampoco depende solo de que un agente decida espontáneamente realizar una acción inadecuada.
Investigaciones del NIST sobre seguridad de agentes destacan que estos sistemas con frecuencia procesan contenido proveniente de sitios web, correos electrónicos, repositorios y otras fuentes externas. Esto crea espacio para ataques de prompt injection indirecto, en los que instrucciones maliciosas quedan ocultas dentro de los propios datos que consume el agente.
En este escenario, un atacante puede intentar inducir a un agente legítimo a usar los permisos que ya posee para exfiltrar información.
La combinación es especialmente difícil para los sistemas tradicionales de seguridad: la credencial puede ser válida, la herramienta puede estar autorizada y la conexión puede parecer normal — mientras el objetivo de la acción es incorrecto.
La gobernanza de agentes necesita controlar la salida de datos
El episodio de las 53 imágenes no demuestra que todo agente autónomo vaya a filtrar información inevitablemente.
La actividad ocurrió en un contexto de investigación, y OpenAI afirma haber implementado nuevos controles mientras continúa revisando comportamientos anteriores de sus modelos.
La consecuencia más relevante es arquitectónica.
Una empresa que pretende dar a los agentes acceso simultáneo a datos sensibles y herramientas externas debe considerar al menos cuatro capas independientes de control: identidad propia con privilegios mínimos, clasificación y procedencia de los datos, restricciones sobre destinos y herramientas capaces de enviar información al exterior, y registros suficientes para reconstruir lo ocurrido después de un incidente.
Para acciones externas difíciles de revertir, una etapa de aprobación humana también puede funcionar como barrera adicional.
La principal métrica de seguridad, por lo tanto, deja de ser solo qué tan bien obedece el agente a las instrucciones.
También empieza a importar cuánto poder tiene sobre los canales de salida y si la infraestructura logra distinguir entre un dato que el agente está autorizado a usar y un dato que está autorizado a publicar.
A medida que los agentes reciben navegadores, correo electrónico, APIs, sistemas de archivos y herramientas de publicación, esta distinción deja de ser solo una regla operacional.
Esta pasa a formar parte del propio perímetro de seguridad.