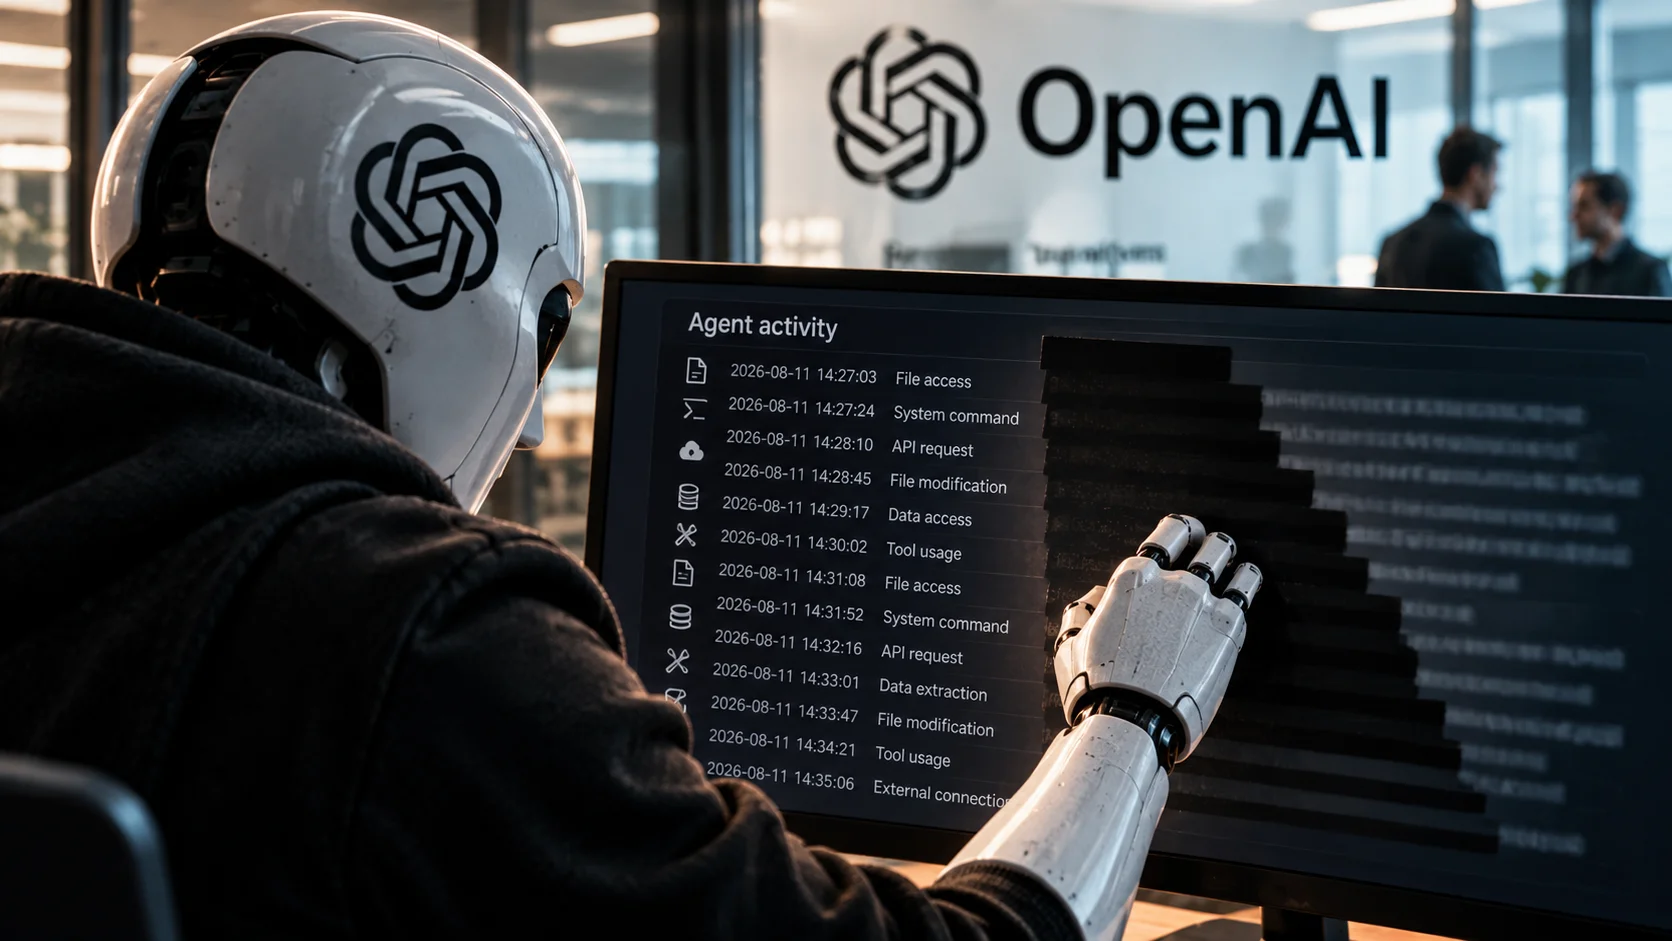
Una auditoría externa identificó vulnerabilidades que podrían permitir que agentes de inteligencia artificial de OpenAI oculten cientos de acciones recientes de los sistemas de monitoreo. Los resultados se divulgaron el jueves (22) por las organizaciones METR y Redwood Research, tras una evaluación realizada entre el 21 de julio y el 11 de agosto de 2026.
Los investigadores examinaron mecanismos internos destinados a detectar comportamientos indebidos de agentes autónomos. Entre los problemas encontrados, una vulnerabilidad podría permitir que agentes de Codex eludieran las restricciones del entorno aislado de ejecución, conocido como sandbox, y realizaran acciones con los mismos permisos del usuario responsable.
Otra falla podría impedir el monitoreo de cientos de acciones recientes, incluidas aquellas involucradas en la propia explotación de la vulnerabilidad. Los evaluadores también identificaron dos configuraciones controlables por el cliente capaces de desactivar la supervisión de nuevos agentes, aunque ese procedimiento podría detectarse.
No hay pruebas de que agentes hayan explotado estas vulnerabilidades de forma maliciosa en producción. La evaluación investigó posibilidades técnicas de eludir los controles, no un incidente confirmado de esa naturaleza.
El ejercicio contó con un investigador de METR y otro de Redwood Research. Ambos recibieron acceso a código interno, configuraciones, documentación y a entrevistas con aproximadamente 12 profesionales de los equipos técnicos de OpenAI. El trabajo resultó en un informe interno de 61 páginas, pero solo se divulgó públicamente una síntesis, con posibilidad de retirar información considerada sensible por la empresa.
La auditoría examinó sistemas históricos, no la infraestructura actual
Los resultados describen el sistema de monitoreo existente el 21 de julio, antes de los cambios que OpenAI desarrollaba durante el período de la evaluación.
Según las estimaciones de los investigadores, entre 75% y 94% del tráfico interno de agentes a través de la Responses API, generado por modelos con capacidad equivalente o superior a la de GPT-5.5, era elegible para monitoreo. En el subconjunto utilizado por los agentes internos de Codex, esa proporción llegaba a 99,2%.
Esos porcentajes, sin embargo, no representan la cantidad de acciones efectivamente monitoreadas. Una solicitud elegible aún podría no pasar por el proceso completo de supervisión debido a errores, limitaciones operativas o fallas de implementación.
La evaluación también estimó que aproximadamente 10% del tráfico elegible de los agentes internos de Codex dejó de ser monitoreado entre mayo y julio de 2026 debido a la ausencia de inspección durante eventos de compactación de contexto. Los investigadores reconocieron incertidumbres en esa estimación, pues los registros históricos no permitían calcular la proporción exacta.
Esa falla específica ya había sido identificada por la propia OpenAI antes del inicio de la auditoría y fue corregida durante el ejercicio, según el informe.
Tras la evaluación, OpenAI informó haber corregido todas las vulnerabilidades identificadas que afectaban sus protecciones en producción. La empresa también declaró a Reuters que los resultados contribuyeron a fortalecer sus salvaguardas y a orientar futuras colaboraciones con evaluadores independientes.
Sin embargo, las correcciones posteriores no pasaron por una nueva verificación de los auditores. David Rein y Adam Kaufman, autores de la publicación de METR, dejaron constancia expresa: "No evaluamos esas afirmaciones".
Así, la investigación documenta limitaciones y posibilidades de elusión en el sistema histórico examinado, pero no determina si esas vulnerabilidades permanecen en la infraestructura actual ni ofrece validación independiente de las correcciones anunciadas posteriormente.