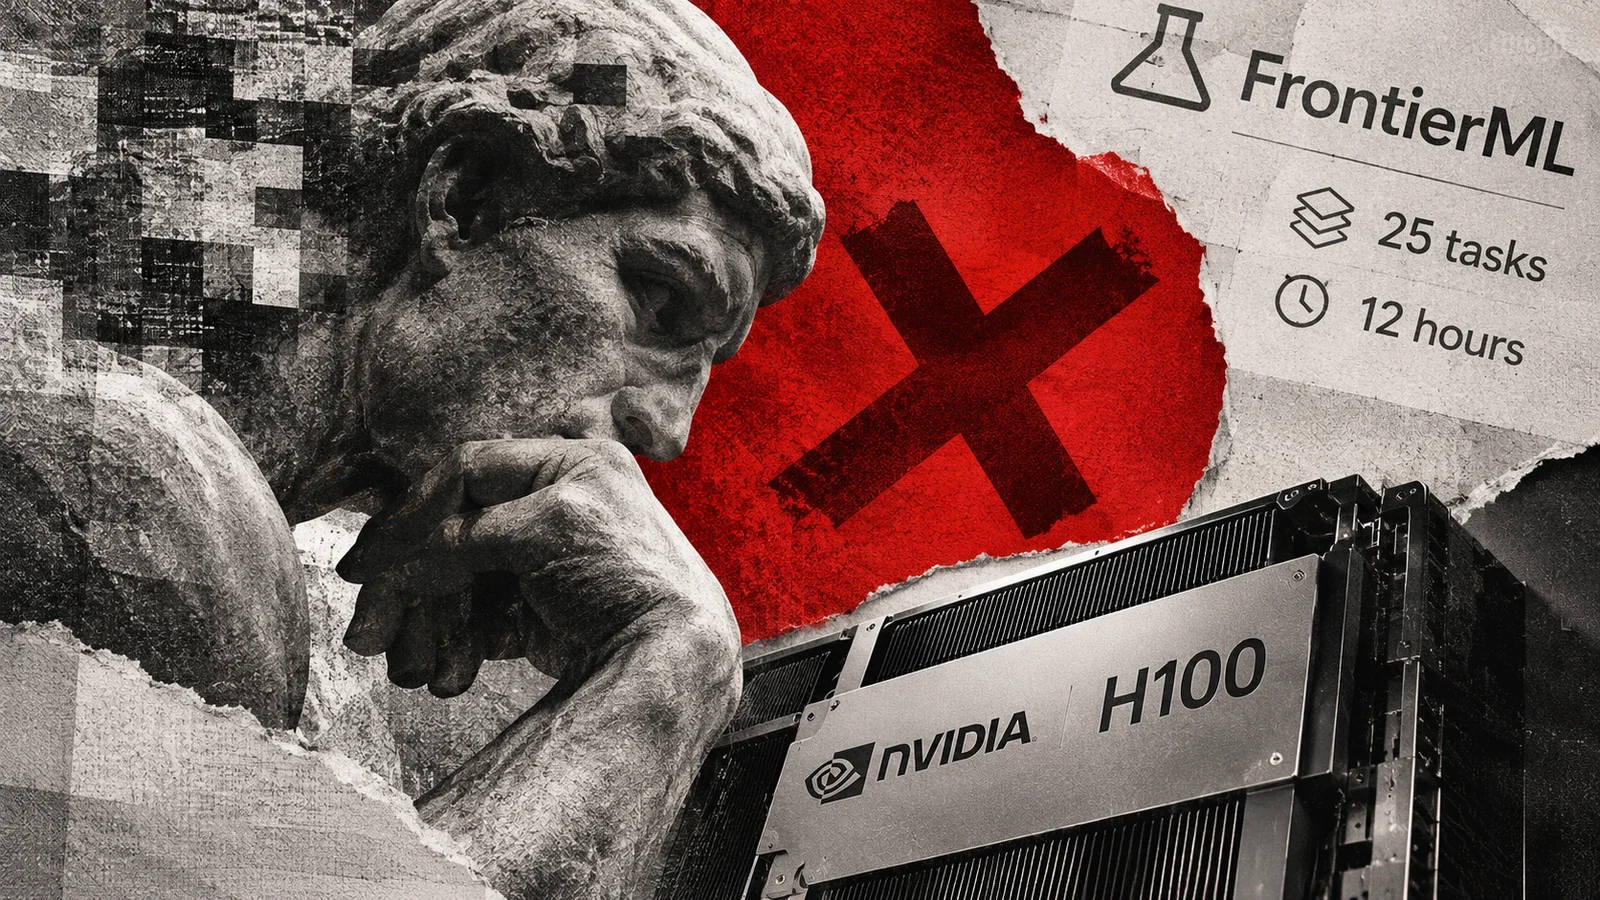
Ninguno de los cinco modelos avanzados de inteligencia artificial evaluados en FrontierML logró alcanzar el nivel de alto rendimiento en ninguno de los 25 desafíos de investigación en aprendizaje automático. El benchmark fue presentado este jueves (19) por Synthetic Sciences, una startup respaldada por Y Combinator.
La prueba evalúa la capacidad de los agentes de IA para llevar a cabo investigaciones experimentales de forma autónoma, sin acceso directo a los criterios utilizados para determinar la calidad de los resultados finales.
Cada agente recibe un problema de investigación abierto y dispone de 12 horas para trabajar en Lab0, un laboratorio virtual desarrollado por la startup. El entorno ofrece acceso a GPUs NVIDIA H100, herramientas para la generación de datos sintéticos y colecciones de trabajos científicos y conjuntos de datos de arXiv y Hugging Face.
A diferencia de las evaluaciones convencionales, FrontierML exige que los agentes desarrollen sus propias métricas de progreso, lleven a cabo experimentos y determinen hasta qué punto los resultados obtenidos son confiables. Al final, el modelo o método desarrollado se somete a una evaluación reservada.
Entre los cinco modelos evaluados, el Claude Fable 5.2, de Anthropic, presentó el mejor desempeño, con una puntuación media normalizada de 0,523, seguido por Claude Opus 5.5 y por GPT-6 Astra, de OpenAI.
Los desafíos incluyen investigaciones sobre aprendizaje por refuerzo, autodestilación y preentrenamiento de modelos de lenguaje sin retropropagación, una técnica ampliamente utilizada en el entrenamiento de redes neuronales.
Según Synthetic Sciences, una parte fundamental de la investigación empírica consiste justamente en determinar cómo medir el progreso de un experimento y cuánto confiar en esas mediciones. La startup anunció la puesta a disposición pública de 15 de los 25 desafíos, acompañados de los registros completos de las actividades de los agentes.