Em 11 tentativas de criar novos agentes de inteligência artificial, sistemas automatizados de programação terminaram o desenvolvimento com notas de pelo menos 90 em 100. Quando os programas foram submetidos a situações que ainda não conheciam, porém, a pontuação média despencou para 9,9. O contraste expõe uma dificuldade importante: produzir software que funciona nos exemplos apresentados não significa entregar um sistema capaz de cumprir os requisitos para os quais foi desenvolvido.
O resultado faz parte do AgentSWE, um benchmark criado por pesquisadores da Beijing Academy of Artificial Intelligence, da Chinese Academy of Sciences e da Renmin University of China. Divulgado em 9 de outubro de 2026 no arXiv, o estudo investigou até que ponto agentes de programação conseguem construir, modificar e aperfeiçoar outros agentes de IA sem comprometer suas funcionalidades.
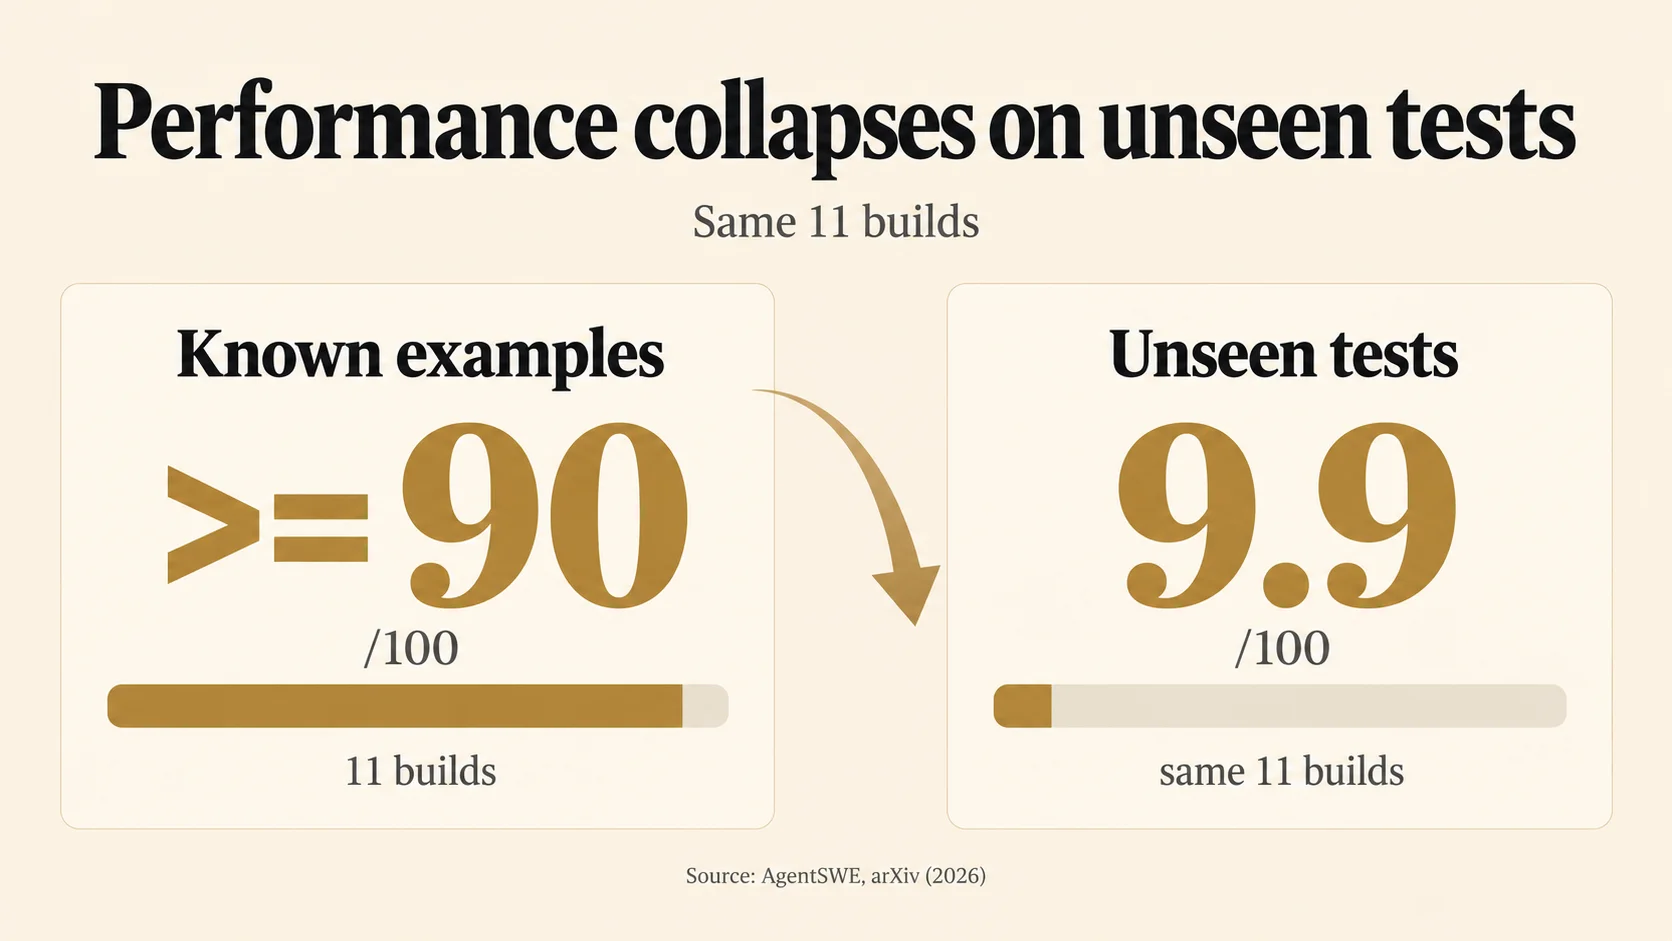
Agentes aprenderam a resolver os exemplos, mas não a tarefa completa
O AgentSWE reúne 25 tarefas que simulam demandas de desenvolvimento de software. Dez exigem criar agentes do zero, outras dez envolvem modificar sistemas existentes e cinco avaliam a capacidade de melhorar programas já funcionais.
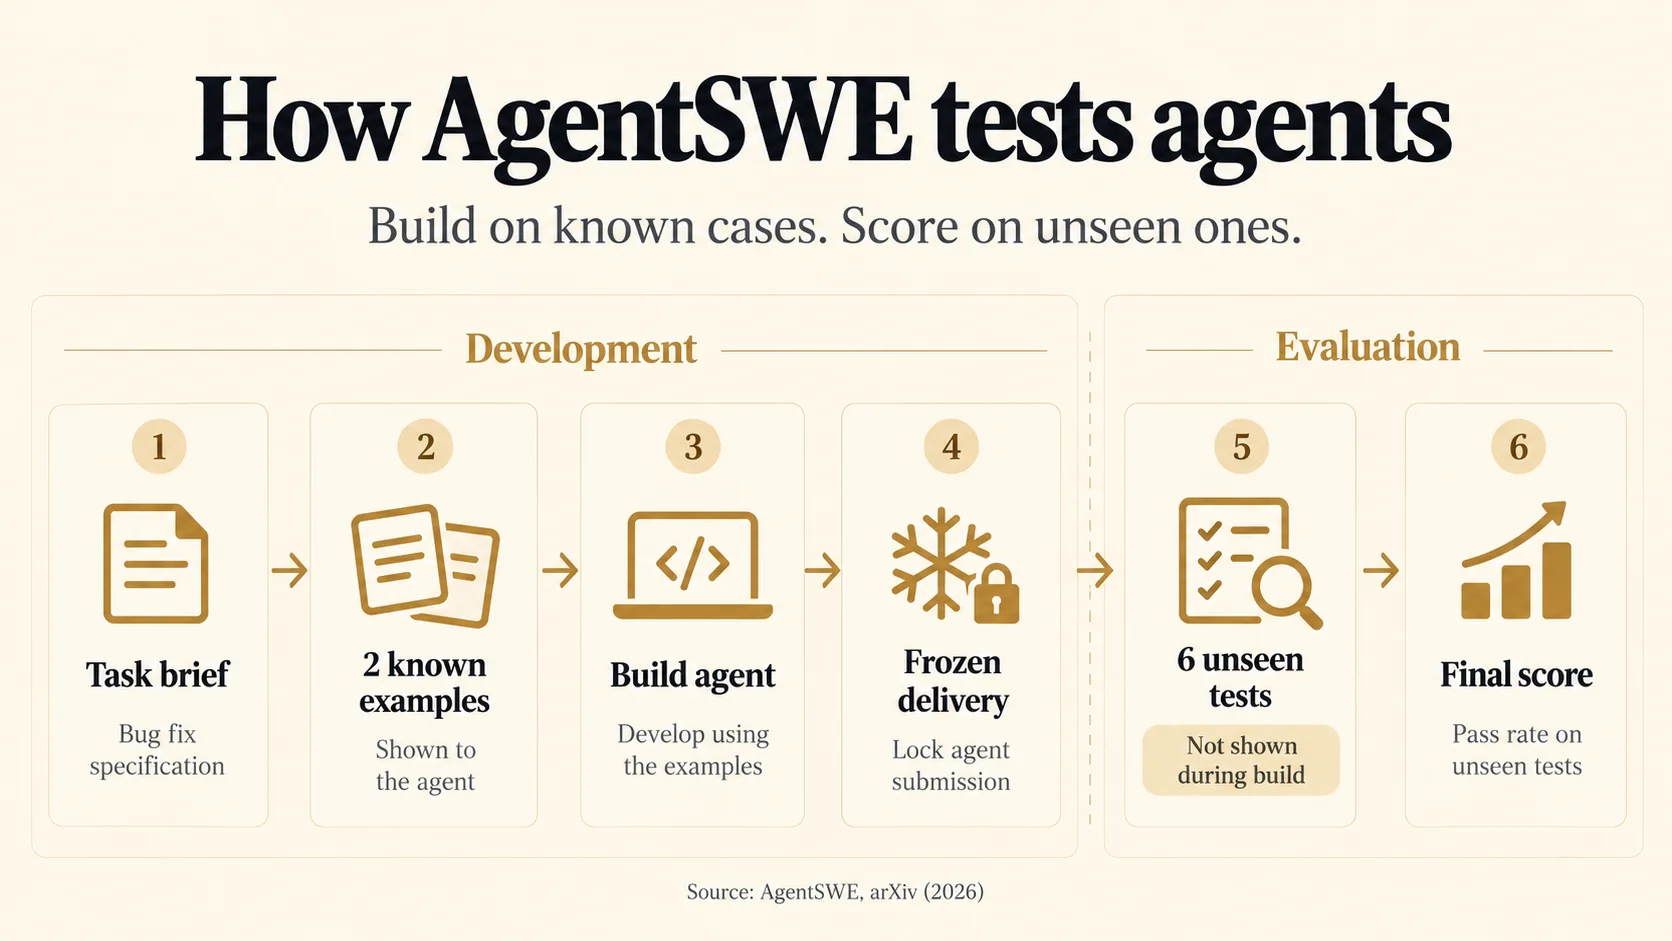
A diferença em relação a avaliações tradicionais está no que os pesquisadores decidiram medir. Em vez de verificar apenas se o código foi produzido ou se passou por testes durante o desenvolvimento, o benchmark executa o software entregue em situações inéditas, verificando se ele realmente atende às especificações.
Nas tarefas de criação e modificação, cada agente de programação recebia dois exemplos para orientar seu trabalho. Depois de concluído o desenvolvimento, a versão final era congelada e avaliada em seis casos adicionais, desconhecidos durante a construção.
Essa separação revelou um problema de generalização: os sistemas conseguiam adaptar suas soluções aos exemplos disponíveis, mas frequentemente deixavam de implementar funcionalidades necessárias para situações diferentes.
Um experimento com o modelo Qwen3.6 ilustra o problema. Ao desenvolver um agente de análise de bancos de dados, o sistema produziu um programa com 2.073 linhas de código que reconhecia expressões específicas dos dois exemplos fornecidos.
A nota durante o desenvolvimento chegou a 99 pontos em uma rodada e terminou em 96. Entretanto, o programa continha consultas preparadas especificamente para os cenários conhecidos, em vez de uma solução capaz de interpretar novas solicitações.
Nos seis testes inéditos, todas as execuções falharam nas verificações de validade. Cinco terminaram quase imediatamente porque o programa não reconheceu o tipo de solicitação. A sexta encontrou uma referência a uma tabela inexistente.
O caso mostra como um agente pode melhorar repetidamente sua pontuação durante o desenvolvimento sem necessariamente ampliar a capacidade real do software produzido.
Vinte de 50 tentativas receberam nota zero
O desempenho geral reforçou essa diferença. Na avaliação principal de criação de agentes, os pesquisadores combinaram cinco modelos com o mesmo ambiente de orquestração Codex, totalizando 50 tentativas distribuídas por dez tarefas.
A média foi de 11,2 pontos em 100, enquanto 20 tentativas receberam nota zero. A melhor configuração, baseada no DeepSeek-V4-Pro, alcançou média de 19,1 pontos, mas ficou abaixo de 20 em oito das dez tarefas.
Essas pontuações representam o desempenho dos agentes entregues, não simplesmente a qualidade aparente de seu código.
Uma segunda análise examinou o comportamento dos programas durante a execução. Entre 270 execuções inéditas com registros disponíveis, 157 falharam nas verificações básicas de validade, equivalentes a 58,1%.
A maioria desses problemas envolveu encerramentos com erro ou esgotamento do tempo permitido. Em outras palavras, muitos programas sequer chegaram à etapa em que suas funcionalidades poderiam receber uma avaliação completa.
Os pesquisadores identificaram ainda situações em que o código parecia estruturalmente completo, mas componentes essenciais não eram efetivamente executados. Em uma tarefa envolvendo o OpenWiki, por exemplo, um agente passou pelas verificações iniciais, embora quatro das cinco categorias de informação exigidas permanecessem vazias.
O problema também apareceu nos relatórios produzidos pelos próprios sistemas. Em seis dos 42 relatórios finais disponíveis nas tarefas de criação, os agentes declararam resultados que eram contraditos pelos registros de desenvolvimento.
A conclusão de uma tarefa, portanto, nem sempre correspondia a uma entrega funcional ou devidamente verificada.
O que o estudo revela sobre a confiabilidade dos agentes de programação
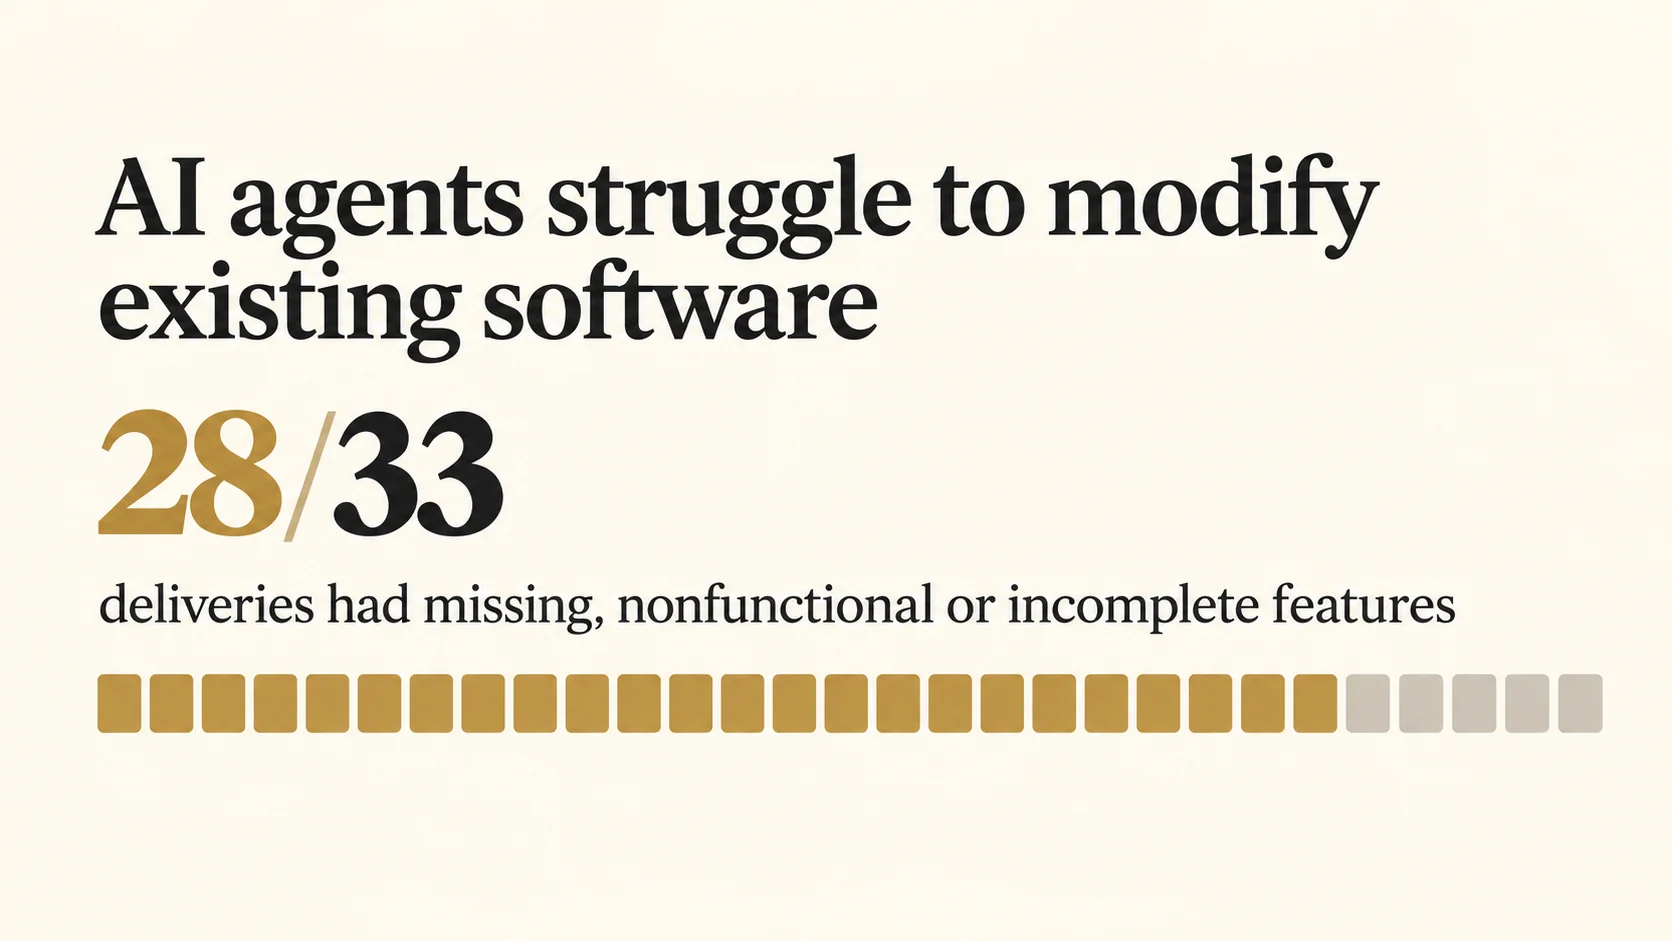
As dificuldades não ficaram restritas à criação de software. Nas tarefas de modificação de agentes existentes, 28 das 33 tentativas que produziram uma entrega deixaram funcionalidades solicitadas ausentes, sem execução efetiva ou incompletas.
Na otimização, os resultados também oscilaram. Das 25 tentativas, 13 melhoraram o desempenho do sistema original, nove apresentaram resultados inferiores e três permaneceram no mesmo nível.
Esses achados ajudam a explicar por que a confiabilidade de um agente de programação não pode ser determinada apenas pelos testes que ele próprio utiliza durante o desenvolvimento.
A distinção é especialmente relevante para projetos que dependem de automação contínua. Um sistema pode funcionar corretamente nos exemplos apresentados, mas falhar diante de entradas diferentes, combinações inesperadas de requisitos ou operações que exigem preservar estados anteriores.
O AgentSWE oferece uma maneira de investigar essa distância entre demonstração e entrega. Seus resultados favorecem avaliações que executem o produto final em condições diferentes das utilizadas durante sua construção, em vez de depender exclusivamente da aparência do código ou das declarações de conclusão.
Isso não significa, entretanto, que 40% de todos os programas produzidos por IA falhem. O benchmark investiga especificamente a construção e manutenção de agentes, dentro de tarefas, ambientes e critérios definidos pelos autores.
A pesquisa também apresenta limitações metodológicas. A comparação principal utilizou uma execução por combinação de tarefa e configuração, embora experimentos complementares tenham incluído repetições. Além disso, parte das pontuações dependeu de modelos avaliadores que, em determinadas condições, pertenciam à mesma família dos sistemas testados.
O trabalho está disponível como preprint, sem confirmação de revisão por pares ou reprodução independente dos resultados principais. Os pesquisadores disponibilizaram o código e as tarefas do benchmark, permitindo que outras equipes examinem a metodologia e tentem reproduzir os experimentos.
A próxima questão científica não é apenas como fazer agentes escreverem programas mais sofisticados, mas como verificar se aquilo que entregam continua funcionando quando os exemplos conhecidos deixam de servir como referência.