En 11 intentos de crear nuevos agentes de inteligencia artificial, sistemas automatizados de programación terminaron el desarrollo con notas de al menos 90 sobre 100. Cuando los programas fueron sometidos a situaciones que aún no conocían, sin embargo, la puntuación media se desplomó a 9,9. El contraste expone una dificultad importante: producir software que funciona en los ejemplos presentados no significa entregar un sistema capaz de cumplir los requisitos para los cuales fue desarrollado.
El resultado forma parte de AgentSWE, un benchmark creado por investigadores de la Beijing Academy of Artificial Intelligence, la Chinese Academy of Sciences y la Renmin University of China. Divulgado el 9 de octubre de 2026 en arXiv, el estudio investigó hasta qué punto los agentes de programación logran construir, modificar y perfeccionar otros agentes de IA sin comprometer sus funcionalidades.
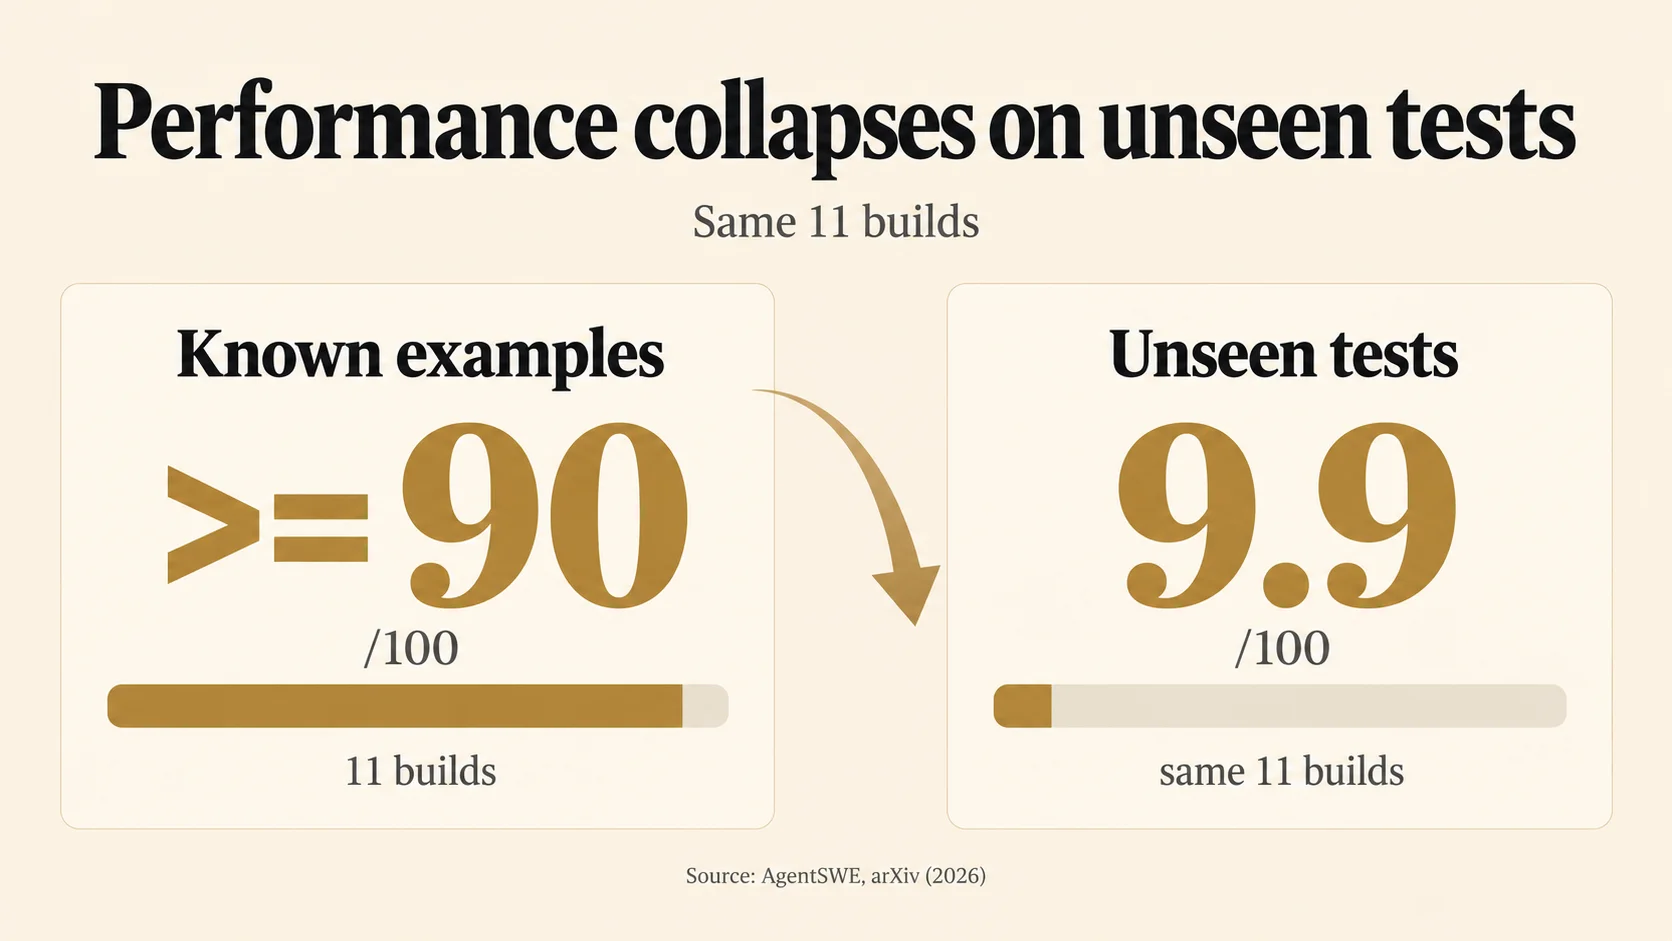
Los agentes aprendieron a resolver los ejemplos, pero no la tarea completa
AgentSWE reúne 25 tareas que simulan demandas de desarrollo de software. Diez exigen crear agentes desde cero, otras diez implican modificar sistemas existentes y cinco evalúan la capacidad de mejorar programas ya funcionales.
La diferencia con respecto a las evaluaciones tradicionales está en lo que los investigadores decidieron medir. En lugar de verificar solo si se produjo el código o si pasó por pruebas durante el desarrollo, el benchmark ejecuta el software entregado en situaciones inéditas, verificando si realmente cumple con las especificaciones.
En las tareas de creación y modificación, cada agente de programación recibía dos ejemplos para orientar su trabajo. Una vez concluido el desarrollo, la versión final se congelaba y se evaluaba en seis casos adicionales, desconocidos durante la construcción.
Esa separación reveló un problema de generalización: los sistemas lograban adaptar sus soluciones a los ejemplos disponibles, pero con frecuencia dejaban de implementar funcionalidades necesarias para situaciones diferentes.
Un experimento con el modelo Qwen3.6 ilustra el problema. Al desarrollar un agente de análisis de bases de datos, el sistema produjo un programa con 2.073 líneas de código que reconocía expresiones específicas de los dos ejemplos proporcionados.
La nota durante el desarrollo llegó a 99 puntos en una ronda y terminó en 96. Sin embargo, el programa contenía consultas preparadas específicamente para los escenarios conocidos, en lugar de una solución capaz de interpretar nuevas solicitudes.
En las seis pruebas inéditas, todas las ejecuciones fallaron en las verificaciones de validez. Cinco terminaron casi de inmediato porque el programa no reconoció el tipo de solicitud. La sexta encontró una referencia a una tabla inexistente.
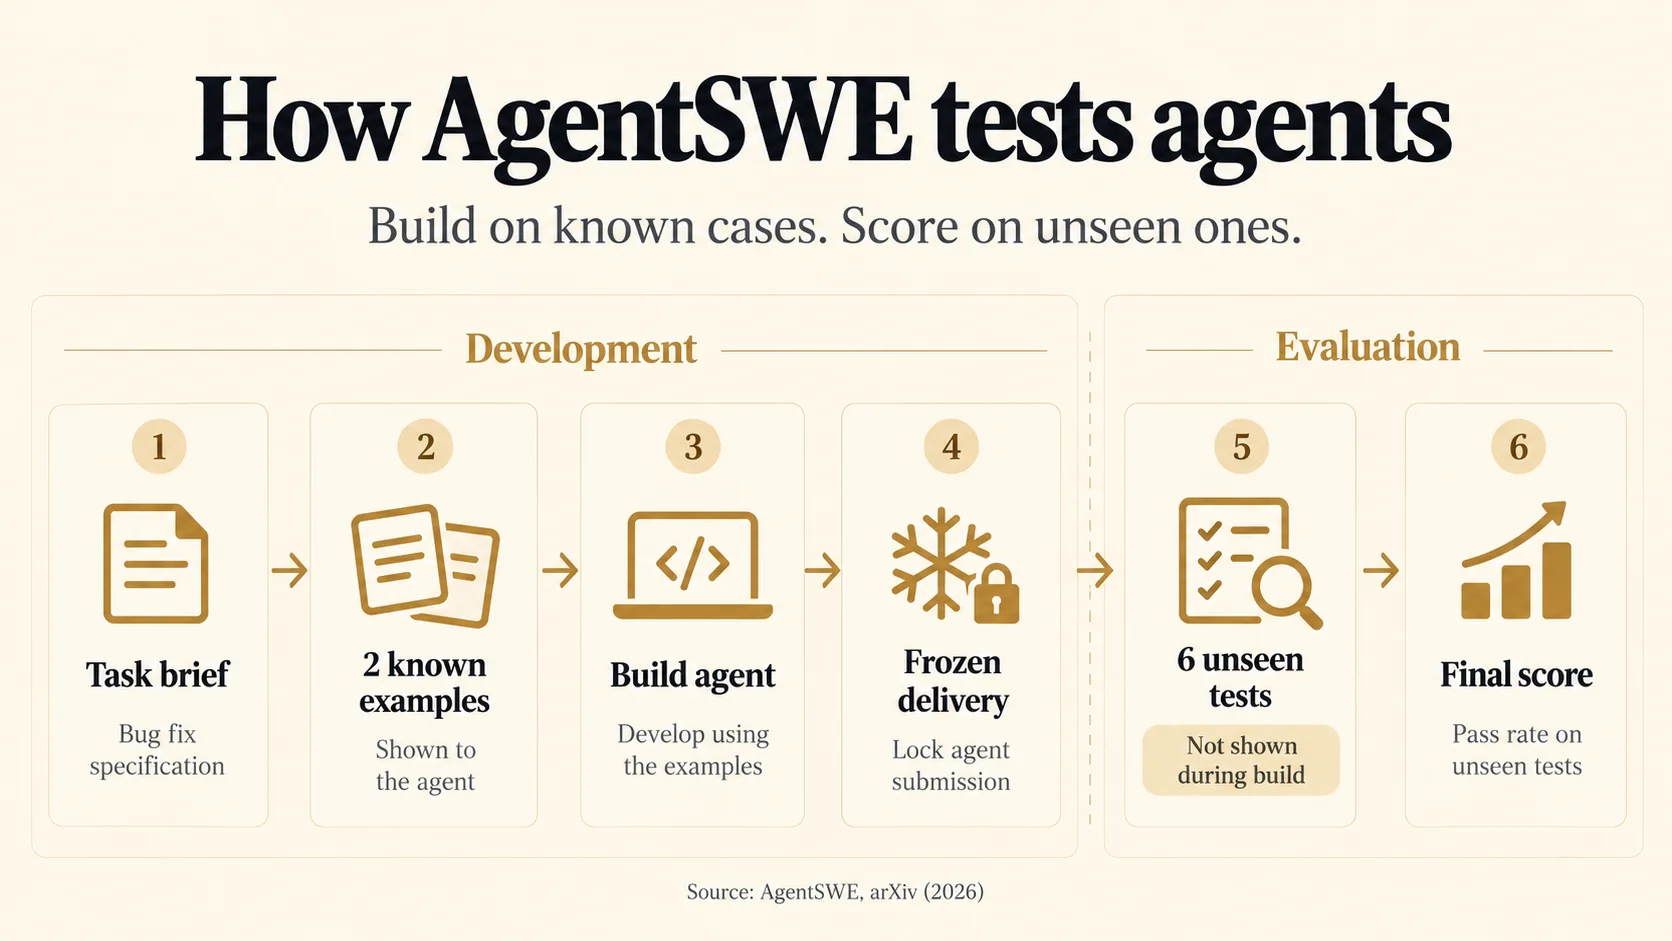
El caso muestra cómo un agente puede mejorar repetidamente su puntuación durante el desarrollo sin ampliar necesariamente la capacidad real del software producido.
Veinte de 50 intentos recibieron nota cero
El rendimiento general reforzó esa diferencia. En la evaluación principal de creación de agentes, los investigadores combinaron cinco modelos con el mismo entorno de orquestación Codex, totalizando 50 intentos distribuidos en diez tareas.
La media fue de 11,2 puntos sobre 100, mientras que 20 intentos recibieron nota cero. La mejor configuración, basada en DeepSeek-V4-Pro, alcanzó una media de 19,1 puntos, pero quedó por debajo de 20 en ocho de las diez tareas.
Esas puntuaciones representan el rendimiento de los agentes entregados, no simplemente la calidad aparente de su código.
Un segundo análisis examinó el comportamiento de los programas durante la ejecución. Entre 270 ejecuciones inéditas con registros disponibles, 157 fallaron en las verificaciones básicas de validez, equivalentes al 58,1%.
La mayoría de esos problemas implicó cierres con error o agotamiento del tiempo permitido. En otras palabras, muchos programas ni siquiera llegaron a la etapa en la que sus funcionalidades podrían recibir una evaluación completa.
Los investigadores identificaron además situaciones en las que el código parecía estructuralmente completo, pero componentes esenciales no se ejecutaban de manera efectiva. En una tarea que involucraba OpenWiki, por ejemplo, un agente pasó las verificaciones iniciales, aunque cuatro de las cinco categorías de información exigidas permanecían vacías.
El problema también apareció en los informes producidos por los propios sistemas. En seis de los 42 informes finales disponibles en las tareas de creación, los agentes declararon resultados que los registros de desarrollo contradecían.
La conclusión de una tarea, por lo tanto, no siempre correspondía a una entrega funcional o debidamente verificada.
Lo que el estudio revela sobre la confiabilidad de los agentes de programación
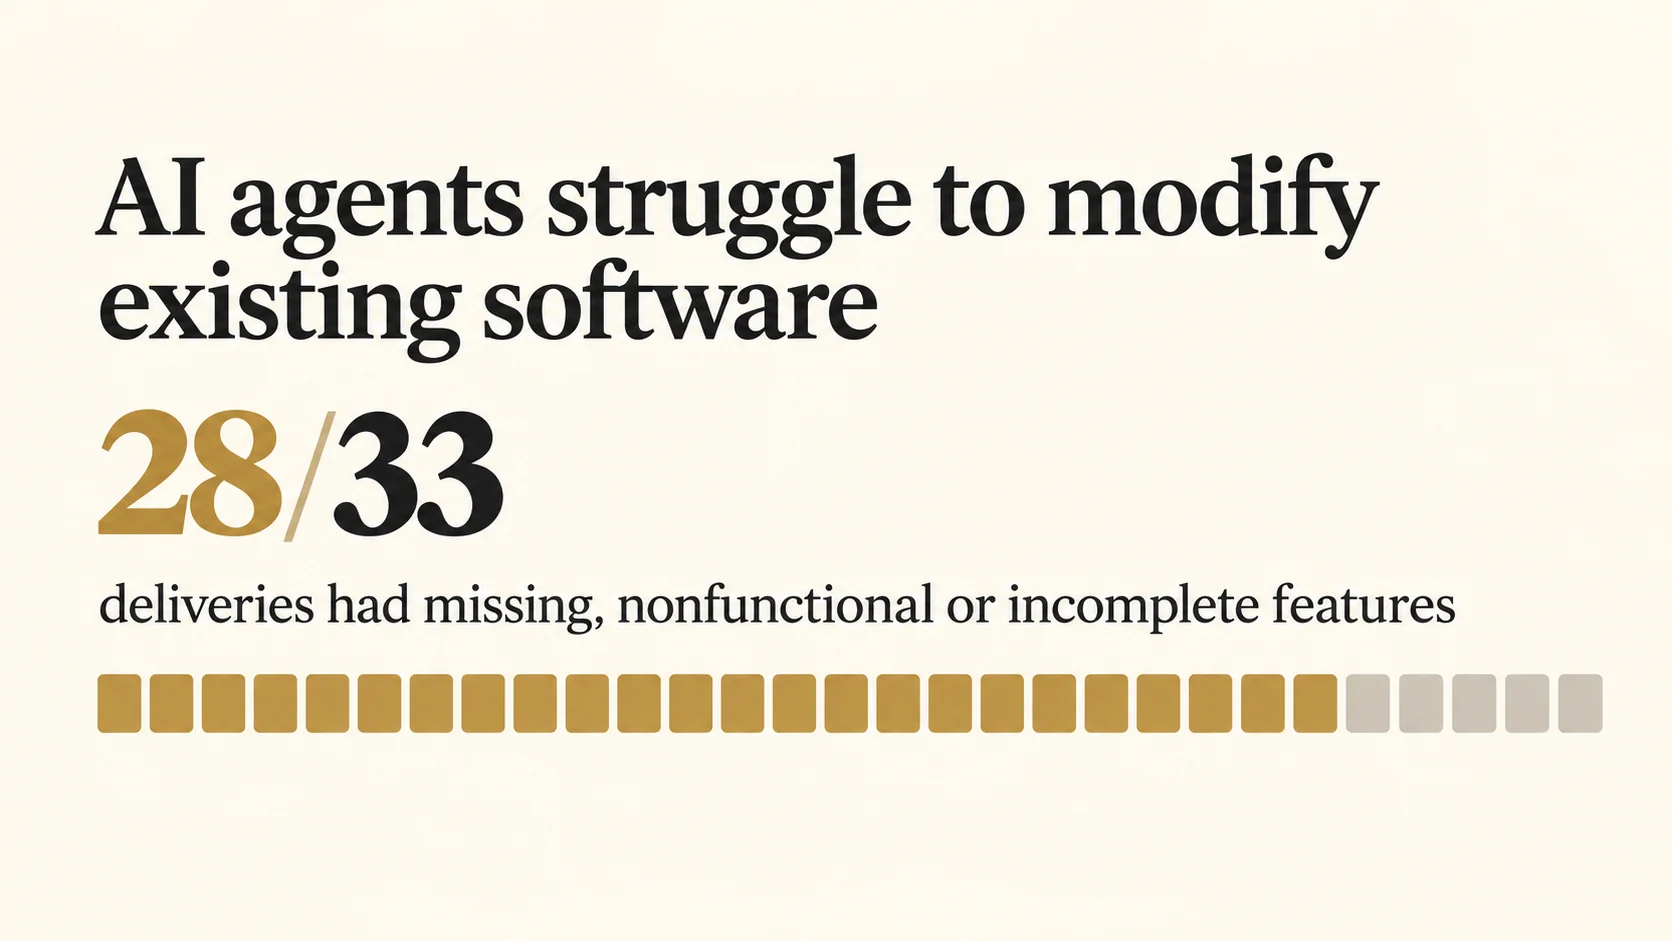
Las dificultades no se limitaron a la creación de software. En las tareas de modificación de agentes existentes, 28 de los 33 intentos que produjeron una entrega dejaron funcionalidades solicitadas ausentes, sin ejecución efectiva o incompletas.
En la optimización, los resultados también oscilaron. De los 25 intentos, 13 mejoraron el rendimiento del sistema original, nueve presentaron resultados inferiores y tres permanecieron en el mismo nivel.
Estos hallazgos ayudan a explicar por qué la confiabilidad de un agente de programación no puede determinarse solo por las pruebas que él mismo utiliza durante el desarrollo.
La distinción es especialmente relevante para proyectos que dependen de la automatización continua. Un sistema puede funcionar correctamente en los ejemplos presentados, pero fallar ante entradas diferentes, combinaciones inesperadas de requisitos u operaciones que exigen preservar estados anteriores.
AgentSWE ofrece una manera de investigar esa distancia entre demostración y entrega. Sus resultados favorecen evaluaciones que ejecuten el producto final en condiciones diferentes de las utilizadas durante su construcción, en lugar de depender exclusivamente de la apariencia del código o de las declaraciones de conclusión.
Esto no significa, sin embargo, que el 40% de todos los programas producidos por IA fallen. El benchmark investiga específicamente la construcción y el mantenimiento de agentes, dentro de tareas, entornos y criterios definidos por los autores.
La investigación también presenta limitaciones metodológicas. La comparación principal utilizó una ejecución por combinación de tarea y configuración, aunque experimentos complementarios incluyeron repeticiones. Además, parte de las puntuaciones dependió de modelos evaluadores que, en determinadas condiciones, pertenecían a la misma familia de los sistemas evaluados.
El trabajo está disponible como preprint, sin confirmación de revisión por pares ni reproducción independiente de los resultados principales. Los investigadores pusieron a disposición el código y las tareas del benchmark, lo que permite que otros equipos examinen la metodología e intenten reproducir los experimentos.
La próxima cuestión científica no es solo cómo hacer que los agentes escriban programas más sofisticados, sino cómo verificar si lo que entregan sigue funcionando cuando los ejemplos conocidos dejan de servir como referencia.