O Google apresentou em 30 de setembro o Gemini 4 Argon, seu novo modelo de fronteira, depois de meses em que a empresa deixou de lançar o Gemini 3.5 Pro enquanto OpenAI e Anthropic renovavam seus modelos mais avançados. O Argon chega com resultados competitivos em trabalho profissional, programação e segurança, além de um limite anunciado de 1 milhão de tokens de saída. Mas a característica mais relevante do lançamento não está em saber se o Google venceu mais linhas em uma tabela de benchmarks.
A questão é outra: até onde um modelo consegue permanecer trabalhando sozinho em uma tarefa longa, usando ferramentas, consultando grandes volumes de informação, corrigindo os próprios passos e chegando a um resultado verificável?
É nesse ponto que o Argon oferece o sinal mais interessante. O Google está tentando transformar capacidade de raciocínio prolongado em uma característica comercial do modelo. Se esse desempenho se sustentar fora dos testes, a competição entre os principais laboratórios passa a depender cada vez menos da qualidade de uma única resposta e mais do custo, da confiabilidade e da duração de processos inteiros executados por agentes.
O resultado mais importante não está no placar do Google
O material de lançamento coloca o Argon à frente de concorrentes em vários testes, mas comparações produzidas pelo próprio desenvolvedor precisam ser tratadas com cuidado. Diferentes modelos podem usar ferramentas, níveis de esforço e estruturas de execução distintas, e pequenas diferenças de pontuação nem sempre representam vantagens perceptíveis em produção.
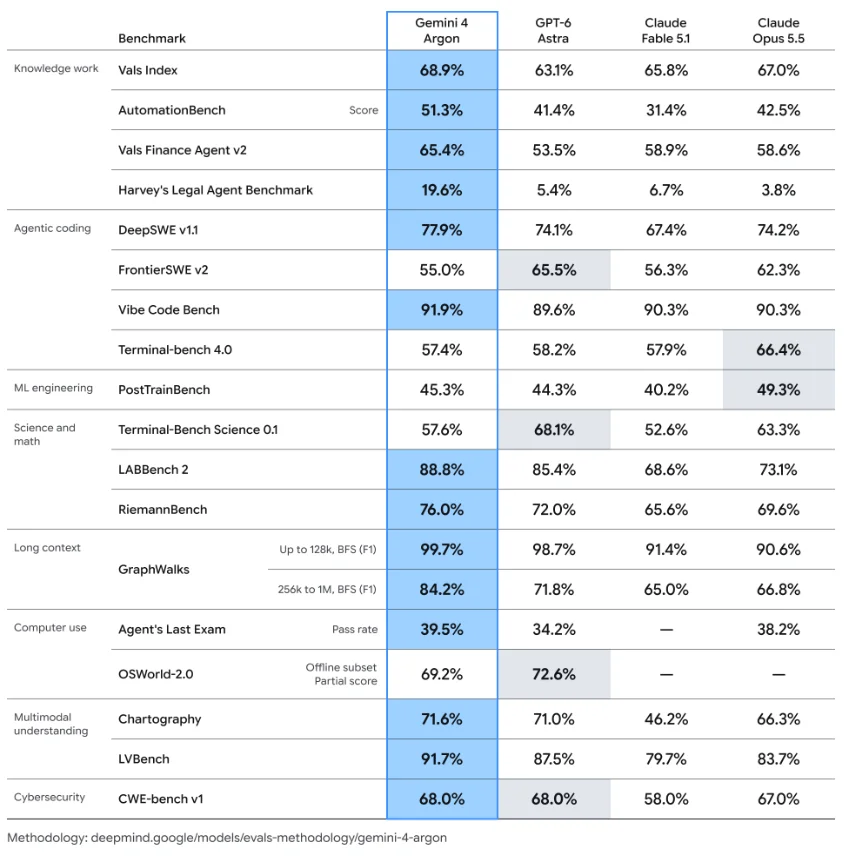
A Vals AI avaliou o Argon em sua própria suíte e colocou o modelo na primeira posição do Vals Index, com 68,9%, contra 67,04% do Claude Sonnet 5.5 e 66,97% do Claude Opus 5.5. O índice combina tarefas de finanças, programação, direito e tributação e tenta aproximar o teste de trabalho profissional com valor econômico.
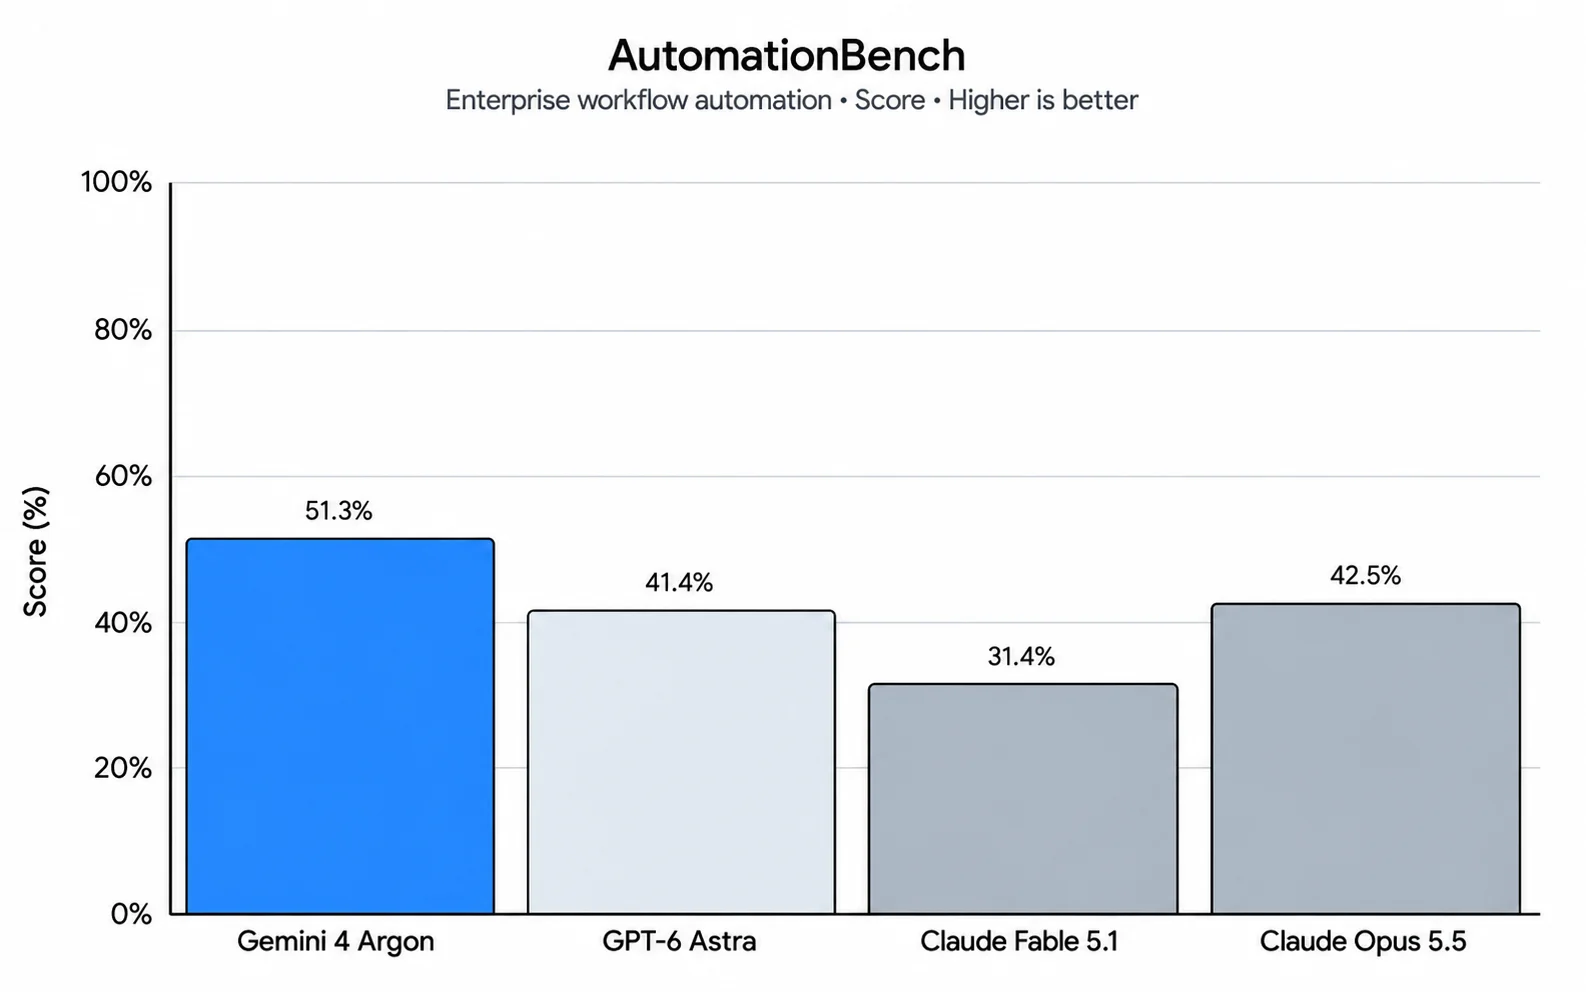
Outro resultado particularmente útil vem do AutomationBench, da Zapier. Nesse teste, o agente precisa operar ambientes empresariais simulados, consultar CRM, planilhas, e mails e outras ferramentas e modificar corretamente o estado desses sistemas. Não basta produzir uma resposta convincente: a tarefa precisa efetivamente terminar com os registros corretos alterados.
O Argon em nível High chegou a 51,29% de sucesso. O Claude Opus 5.5 alcançou 42,47% e o GPT 6 Astra, 41,4% em suas melhores configurações apresentadas no mesmo ranking. Isso ainda significa que quase metade das tarefas não é concluída integralmente, mas a diferença é relevante justamente porque o teste mede execução de ponta a ponta, e não apenas conhecimento ou geração de texto.
Esse talvez seja o indicador mais importante do Argon: o avanço aparece justamente no tipo de tarefa que empresas gostariam de delegar a agentes.
Isso não significa liderança universal. A própria avaliação da Vals coloca o Argon apenas em quinto lugar no Terminal Bench 4.0 e perto do fim da pequena amostra do CUA Bench, que testa uso de computador. O Google também mostrou resultados em que modelos concorrentes permanecem superiores em determinadas tarefas de terminal, ciência e engenharia de software.
Há, entretanto, sinais externos que tornam o lançamento mais relevante.
Portanto, a leitura mais sustentada pelos dados não é que o Google construiu um modelo melhor em tudo. É que o Argon parece especialmente competitivo quando raciocínio, grande quantidade de contexto e execução multietapas aparecem juntos.
Um milhão de tokens muda mais do que o tamanho da resposta
O Google elevou de 64 mil para 1 milhão de tokens o limite máximo anunciado de saída do Argon. Isso é diferente de apenas oferecer uma janela de contexto grande.
Contexto determina quanto material o modelo pode receber. Saída determina quanto trabalho ele pode produzir dentro de uma trajetória. Para agentes, essa diferença importa.
Uma execução prolongada pode envolver leitura de arquivos, chamadas de ferramentas, elaboração de hipóteses, testes, inspeção dos resultados, correções e novas tentativas. Cada uma dessas etapas consome tokens. Limites menores obrigam sistemas complexos a interromper trajetórias, resumir o estado ou iniciar novas sessões.
O Google argumenta que o novo limite permite manter problemas complexos dentro de uma única trajetória muito mais longa.
Os exemplos internos divulgados ajudam a entender o que a empresa pretende fazer com isso. Segundo o Google, agentes com Argon analisaram telemetria de servidores e identificaram otimizações capazes de liberar mais de 300 TiB de memória quando implantadas. A empresa também afirma estar usando o modelo na migração de bases C e C++ para Rust, incluindo mais de 800 mil linhas do kernel Zircon, do Fuchsia. Em outro caso, o modelo trabalhou em 32 mil linhas de código SIMD de um decoder de vídeo e produziu uma implementação em Rust 2,7 vezes mais rápida que o port anterior.
Esses números são resultados divulgados pelo próprio Google e ainda não equivalem a validação independente. O ponto estratégico, porém, é claro: o produto que o Google está tentando vender não é apenas um chatbot que responde melhor. É capacidade computacional aplicada durante mais tempo a um problema.
Isso altera inclusive a unidade econômica pela qual modelos de fronteira podem começar a ser comparados.
O custo por tarefa começa a importar mais que o custo por token
O Argon será lançado inicialmente por US$ 2 por milhão de tokens de entrada e US$ 10 por milhão de saída. Após o período promocional, os valores passam a US$ 4 e US$ 20.
O preço definitivo será igual ao do Claude Opus 5.5 por token e duas vezes o preço do Claude Sonnet 5.5. O GPT 6 Astra, por sua vez, custa US$ 10 por milhão de tokens de entrada e US$ 50 por milhão de saída no preço padrão divulgado pela OpenAI.
Só que essa comparação se torna progressivamente menos útil para agentes.
Um modelo barato que realiza 20 chamadas de ferramentas, volta repetidamente aos mesmos documentos e precisa de várias tentativas pode terminar mais caro que outro com preço maior por token, mas capaz de completar o trabalho em menos etapas.
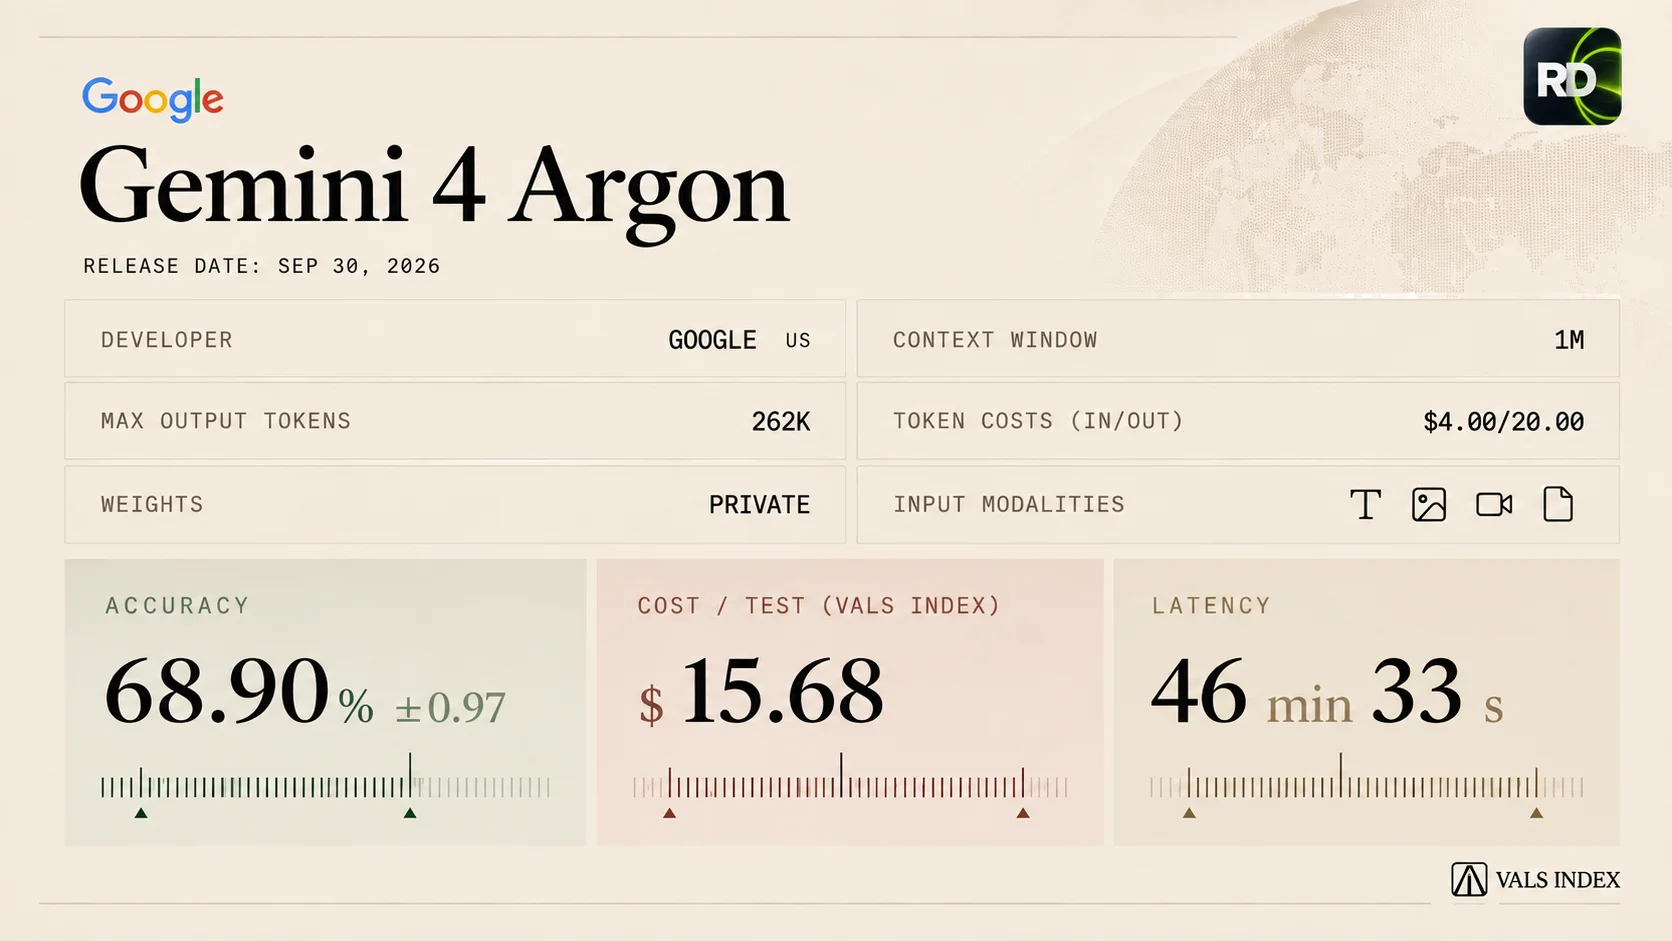
O AutomationBench já permite enxergar essa diferença. Considerando o preço padrão e não a promoção, uma tarefa com Argon High custou em média US$ 1,70 no teste, praticamente o mesmo US$ 1,73 do Astra Max, mas terminou corretamente uma proporção maior das tarefas. Durante a promoção, a Zapier calcula cerca de US$ 0,85 por tarefa para o Argon High.
Na Vals, o Argon apresentou custo médio de US$ 15,68 por teste no Vals Index, comparado a US$ 21,34 para o Sonnet 5.5 e US$ 32,14 para o Opus 5.5 nas configurações avaliadas. Em tarefas agentivas longas, entretanto, os custos sobem rapidamente: a mesma avaliação registra US$ 57,82 por teste em migração de código e US$ 193,78 no CUA Bench.
Essa diferença ajuda a explicar por que tokens isoladamente estão deixando de ser uma medida suficiente. O indicador economicamente relevante tende a ser o custo de chegar a um resultado correto.
Cibersegurança virou laboratório para a próxima geração de agentes
Há outro elemento incomum no lançamento: a maioria dos desenvolvedores não poderá utilizar o Argon imediatamente.
O primeiro acesso está sendo entregue a participantes selecionados do Fairwind Program, iniciativa do Google criada para governos, operadores de infraestrutura crítica e parceiros de segurança. O programa já reunia mais de 650 participantes quando foi anunciado em setembro.
Para esses defensores aprovados e para equipes internas, o Google afirma que disponibilizará o Argon sem as restrições cibernéticas aplicadas ao acesso normal, permitindo atividades defensivas mais avançadas. Segundo a empresa, o modelo consegue procurar, validar e corrigir vulnerabilidades de forma autônoma.
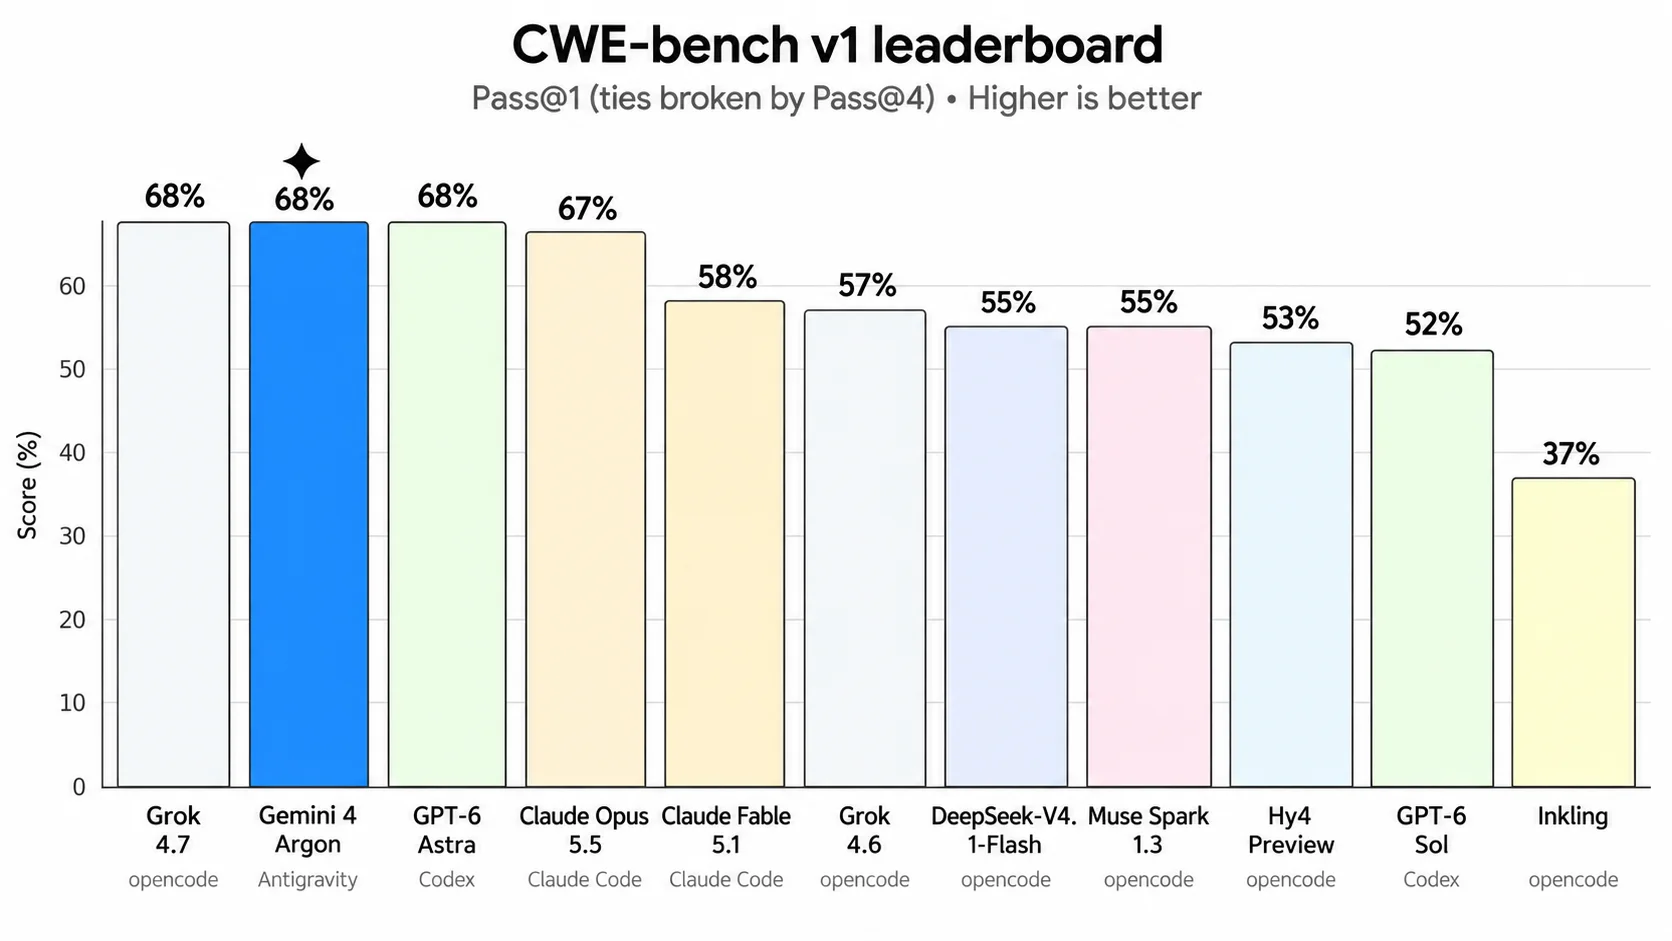
O Google diz que a Wiz já utilizou o sistema para encontrar uma vulnerabilidade crítica em software usado por hospitais, falha que modelos anteriores não haviam identificado. No CWE Bench v1, voltado à correção de vulnerabilidades, o Argon obteve 68%.
Mais importante do que um caso isolado é a arquitetura de distribuição que está surgindo.
A OpenAI estruturou o Daybreak para conceder recursos adicionais de segurança a defensores verificados e diz que o GPT 6 Astra já atingiu seu nível Critical de capacidade cibernética. A Anthropic também utiliza programas de verificação para liberar capacidades mais amplas a profissionais aprovados.
Isso aponta para um modelo de mercado diferente daquele que marcou os primeiros anos dos grandes modelos de linguagem.
Nem toda capacidade de um modelo de fronteira necessariamente será entregue a todos os usuários ao mesmo tempo. Identidade, finalidade, ambiente de execução e nível de controle podem começar a definir qual versão prática da inteligência um cliente realmente recebe.
O Argon transforma esse mecanismo em parte central do lançamento.
O paradoxo é que o modelo mais interessante do Google ainda não pode ser testado amplamente
Essa limitação também impede uma conclusão mais forte sobre o desempenho do Argon.
O Google ainda não informou uma data de disponibilidade pública. A expansão deverá começar por clientes pagos de API e assinantes Google AI Ultra, depois da coleta de dados dos primeiros usuários e do fortalecimento das proteções do sistema.
Isso importa porque o anúncio chega depois de um período difícil para a linha de modelos avançados da empresa.
O Gemini 3.5 Pro, que Sundar Pichai havia indicado para junho, não será mais lançado. Durante esse intervalo, OpenAI e Anthropic introduziram novos modelos, enquanto o Google reorganizou partes do DeepMind. O Argon é, portanto, não apenas um novo produto, mas também a tentativa da empresa de retornar à disputa pelos modelos mais avançados após meses sem um novo flagship disponível.
Nesse contexto, o acesso limitado funciona ao mesmo tempo como mecanismo de segurança e como limitação da evidência disponível.
Há avaliações independentes do modelo, como Vals e Zapier, mas ainda não existe a diversidade de testes, aplicações reais, integrações e cargas de produção que surge quando milhares de desenvolvedores começam a usar um modelo.
Até mesmo o limite de 1 milhão de tokens precisa passar por esse processo. A Vals, por exemplo, avaliou o Argon com máximo de 262.144 tokens de saída em sua configuração. Isso não contradiz o limite anunciado pelo Google, mas mostra que a característica mais extrema do modelo ainda não foi amplamente exercitada em avaliações externas.
Gerar centenas de milhares de tokens também cria problemas que uma especificação técnica não resolve sozinha: latência, custo, degradação ao longo da trajetória, erros acumulados e dificuldade de verificar uma quantidade enorme de trabalho produzido autonomamente.
Um agente que consegue trabalhar por mais tempo só é mais útil se continuar correto por mais tempo.
A próxima disputa será pela confiabilidade da trajetória inteira
O lançamento do Argon reforça uma mudança que já aparecia nos produtos de OpenAI, Anthropic e do próprio Google.
Os principais modelos estão sendo desenhados cada vez menos para responder a uma pergunta e cada vez mais para receber um objetivo.
Essa diferença muda os benchmarks necessários. Um modelo pode escrever excelente código em uma resposta e ainda falhar ao modificar um repositório durante quatro horas. Pode compreender um documento financeiro e ainda cometer um erro ao transportar o resultado para uma planilha. Pode identificar uma vulnerabilidade e introduzir outra ao tentar corrigi la.
Por isso, avaliações como AutomationBench ganham importância. Mesmo o líder atual consegue completar integralmente apenas pouco mais da metade das tarefas avaliadas.
Há muito espaço entre “o modelo consegue fazer” e “uma empresa pode entregar isso ao modelo sem supervisão”.
O Argon reduz essa distância em algumas categorias, segundo os primeiros dados. Não demonstra que ela desapareceu.
O que realmente precisa ser observado agora
O próximo marco relevante não será outro gráfico publicado pelo Google.
Será a abertura do Argon para desenvolvedores e empresas em escala suficiente para permitir comparações independentes de duração, custo e taxa de conclusão em tarefas reais.
Também será importante observar se aplicações conseguem aproveitar trajetórias muito longas sem que o custo cresça mais rapidamente que o valor produzido; se o desempenho do AutomationBench se repete em ambientes empresariais reais; se a vantagem observada em trabalho profissional permanece quando Sonnet, Opus e Astra recebem estruturas de agentes equivalentes; e como o Google administra acesso às capacidades cibernéticas mais sensíveis.
Finalmente, haverá um teste econômico: quantos clientes escolherão o Argon pelo resultado obtido por dólar, e não pelo número de benchmarks vencidos.
O Gemini 4 Argon não encerra a disputa entre Google, OpenAI e Anthropic. Seu lançamento mostra algo possivelmente mais importante: a definição de um modelo de fronteira está começando a mudar.
O próximo salto comercial pode não ser um sistema que responde melhor em alguns segundos.
Pode ser aquele capaz de receber um problema pela manhã, trabalhar nele durante horas, usar dezenas de ferramentas, revisar o próprio trabalho e devolver um resultado que realmente possa ser utilizado.
O Argon é uma das demonstrações mais claras até agora de que é nessa direção que o Google está apostando.