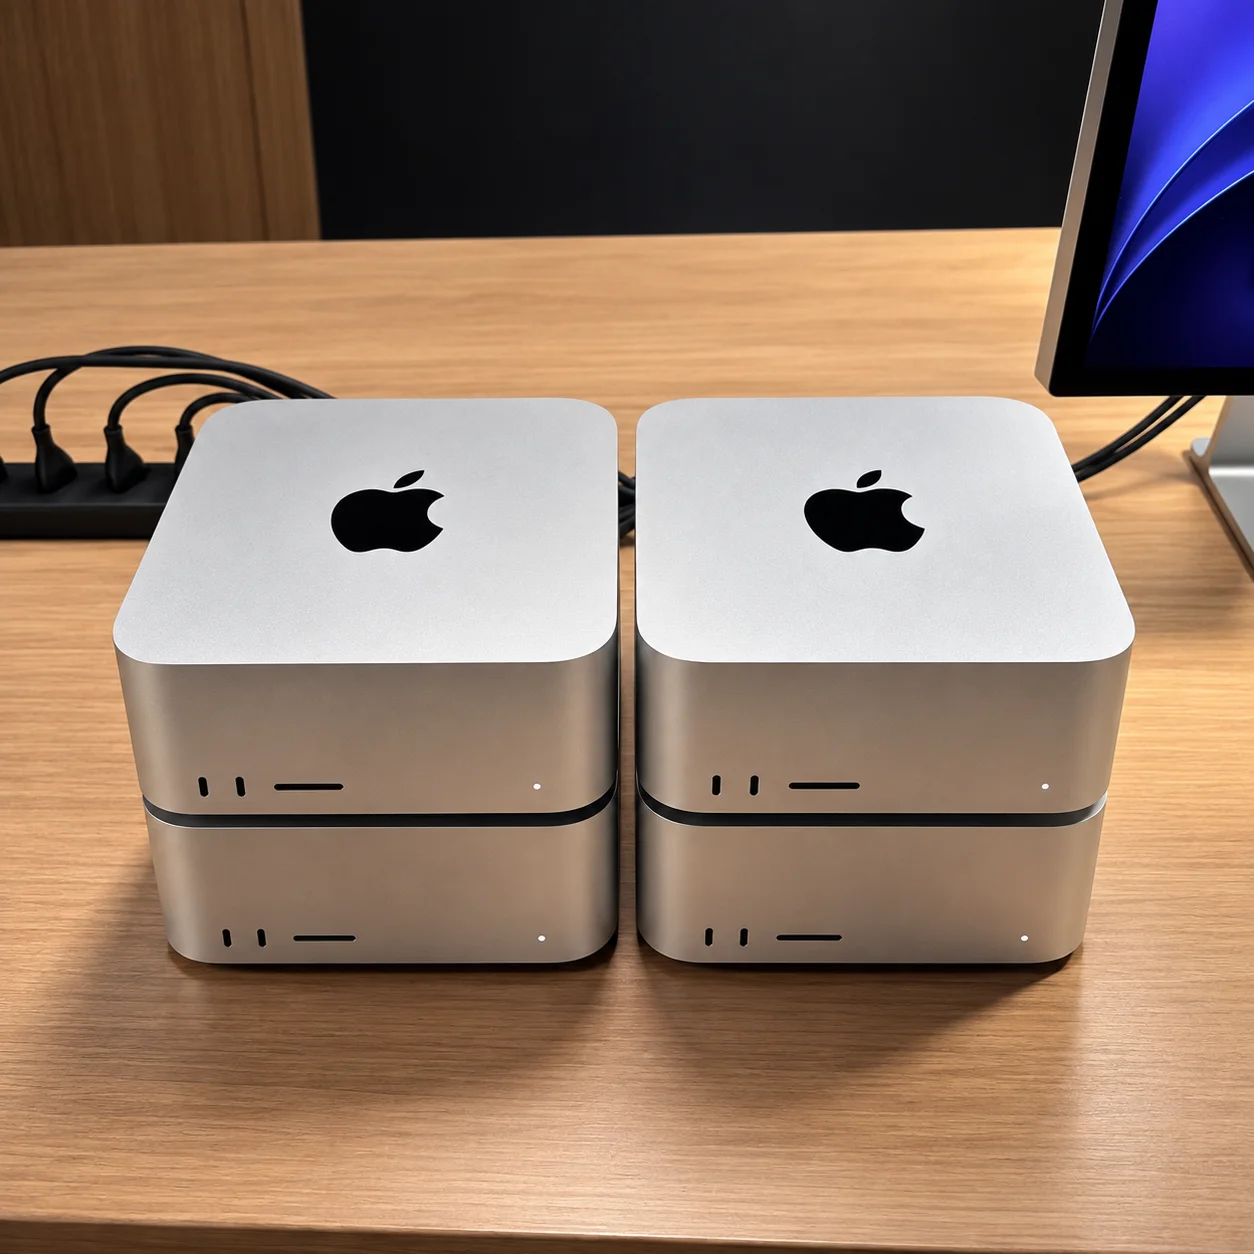
A Apple começou a entregar em 22 de setembro a nova geração do Mac Studio com uma proposta incomum para um desktop: convencer empresas de que parte da inteligência artificial pode sair da nuvem e voltar para infraestrutura própria. Com o M5 Ultra, múltiplas máquinas podem ser agrupadas por Thunderbolt 5 e RDMA para executar modelos open-weight de grande porte, transformando uma despesa variável de inferência em investimento em hardware.
A questão não é se um Mac pode rodar um modelo grande. A questão é quando comprar capacidade própria começa a fazer mais sentido econômico do que pagar continuamente pelo uso de IA na nuvem.
A Apple está tentando transformar tokens em custo fixo
O M5 Ultra suporta até 512 GB de memória unificada e largura de banda de 1,2 TB/s. A Apple também adicionou suporte para clusters de Mac Studio conectados por Thunderbolt 5 com RDMA, tecnologia que permite comunicação de baixa latência diretamente entre a memória das máquinas. Segundo testes da própria empresa, quatro sistemas podem atingir até três vezes o desempenho de um único Mac Studio em inferência distribuída.
A Reuters acompanhou uma demonstração na qual quatro Mac Studios executaram um modelo de 1 trilhão de parâmetros para localizar e corrigir um problema em código gráfico. O conjunto funcionava ligado a uma única tomada de parede.
É nesse ponto que a estratégia deixa de ser apenas técnica.
Serviços de IA hospedados normalmente transformam uso em despesa operacional: quanto mais tokens, chamadas ou capacidade computacional uma aplicação consome, maior tende a ser a conta. Em infraestrutura própria, o custo não desaparece, mas muda de natureza. A empresa paga antecipadamente pela capacidade e pode reutilizá-la sem uma cobrança adicional a cada inferência.
É essa diferença que a Apple está tentando explorar.
“Sem custo por token” não significa IA gratuita
A formulação usada pela Apple é atraente, mas precisa de uma ressalva importante.
O Mac Studio com M5 Ultra começa em US$ 5.499 nos Estados Unidos, enquanto configurações completas podem se aproximar de US$ 20 mil, segundo a Reuters. Um cluster com várias unidades, portanto, pode exigir dezenas de milhares de dólares antes de executar sua primeira tarefa de IA.
A isso se somam energia, armazenamento, administração, atualização de modelos, observabilidade, redundância e o risco de o equipamento ficar ocioso.
O argumento econômico fica mais forte quando a utilização é alta, contínua e relativamente previsível. Uma empresa que executa agentes internos, geração de código ou processamento de documentos durante grande parte do dia consegue diluir o investimento por um volume crescente de inferências.
O cenário é diferente para aplicações com demanda irregular. A nuvem permite aumentar ou reduzir capacidade sem comprar máquinas para atender apenas aos picos.
Por isso, a comparação relevante não é simplesmente “token pago contra token gratuito”. É custo total por trabalho útil produzido, considerando investimento, operação e taxa de utilização. Pesquisadores já vêm propondo métricas que combinam CAPEX e OPEX justamente porque preço por token ou por hora de GPU, isoladamente, não captura toda a economia de uma implantação de IA.
Open-weight torna a conta possível
Existe ainda uma diferença estrutural entre executar um modelo localmente e contratar uma API.
Empresas não podem simplesmente baixar modelos proprietários de provedores como OpenAI ou Anthropic e transferi-los para um Mac Studio. O argumento da Apple depende principalmente do crescimento dos modelos open-weight, cujos pesos podem ser executados em infraestrutura controlada pelo próprio cliente.
A Apple afirma que o agrupamento dos Mac Studios cria capacidade suficiente para carregar alguns dos maiores modelos open-weight disponíveis. O MLX, framework de machine learning da empresa, já suporta computação distribuída e um backend chamado JACCL para comunicação RDMA via Thunderbolt, inclusive para técnicas como tensor parallelism.
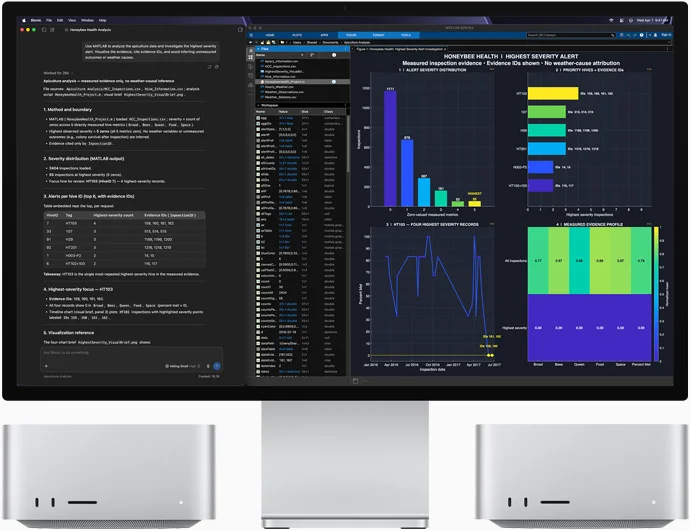
Isso abre uma alternativa intermediária entre duas estruturas que até recentemente estavam bem separadas: APIs totalmente gerenciadas de um lado e servidores especializados com GPUs de datacenter do outro.
O Mac Studio tenta ocupar o espaço da infraestrutura de IA que pode ficar literalmente dentro do escritório.
Para empresas que trabalham com código proprietário, documentos internos ou dados sensíveis, existe ainda um segundo incentivo. Manter a inferência local pode reduzir a quantidade de informação enviada para infraestrutura externa e dar maior controle sobre armazenamento e processamento.
O maior obstáculo pode não ser o chip
Ter memória suficiente para carregar um modelo é apenas parte do problema.
Clusters de IA tradicionais foram desenvolvidos em torno de um ecossistema maduro de GPUs, redes de alta velocidade, orquestração, monitoramento e ferramentas de datacenter. A alternativa da Apple ainda precisa demonstrar que pode oferecer simplicidade operacional comparável.
A própria documentação do MLX mostra que o RDMA por Thunderbolt ainda exige configuração específica. Para ativá-lo, por exemplo, é necessário entrar no modo de recuperação do macOS, habilitar o recurso e posteriormente configurar a comunicação entre os nós.
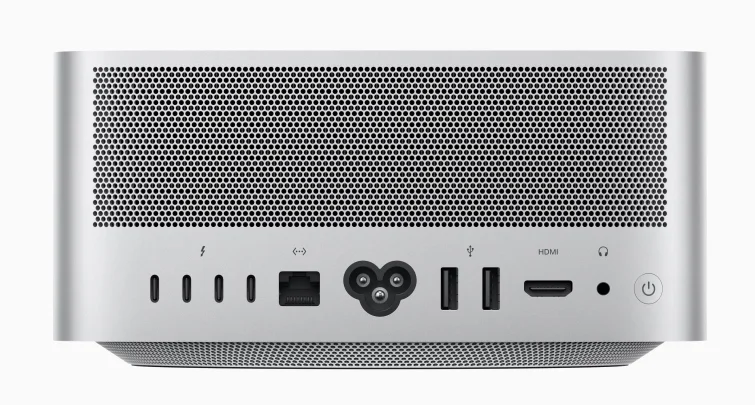
Esse tipo de fricção importa mais em ambientes corporativos do que em demonstrações técnicas.
A Apple também parte de uma posição pequena no mercado empresarial de computadores. Segundo dados da IDC citados pela Reuters, Macs representam cerca de 4,6% do mercado corporativo de desktops e notebooks, contra 91,3% de máquinas Windows.
Para transformar o Mac Studio em infraestrutura de IA, portanto, a empresa precisa conquistar não apenas desenvolvedores, mas equipes de TI acostumadas a ecossistemas completamente diferentes.
O Mac Studio não precisa substituir a nuvem para mudar a conta
O cenário mais plausível não é uma migração completa da inferência empresarial para desktops.
É uma arquitetura híbrida.
Aplicações com demanda variável, necessidade de escala global ou dependência dos modelos proprietários mais avançados tendem a continuar favorecendo serviços externos. Já cargas previsíveis baseadas em modelos open-weight podem começar a justificar infraestrutura própria quando o volume torna a cobrança recorrente suficientemente relevante.
Nesse cenário, a empresa poderia manter uma capacidade local permanente para a carga básica e recorrer à nuvem para picos ou modelos especializados.
É uma mudança menor do que abandonar o datacenter, mas economicamente importante. Parte do orçamento de IA deixa de crescer diretamente com o número de tokens processados e passa a depender da utilização de ativos já adquiridos.
Os próximos sinais virão de fora das demonstrações da Apple. Será necessário observar benchmarks independentes de throughput, latência e consumo de energia, além da adoção de clusters Mac por empresas em cargas reais e da evolução das ferramentas para administrar múltiplas máquinas.
Também haverá um teste imediato de hardware. Embora os novos Mac Studio tenham começado a chegar aos clientes em 22 de setembro, a configuração M5 Ultra com 512 GB de memória unificada só está prevista para o fim de outubro.
Se organizações começarem a manter agentes, ferramentas de desenvolvimento e outras cargas intensivas funcionando continuamente nesses sistemas, a proposta econômica da Apple ganhará evidência concreta.
Até lá, o Mac Studio não elimina a nuvem. Ele torna mais plausível uma pergunta que empresas terão de fazer com frequência crescente: quais workloads de IA ainda precisam ser alugados por token e quais já justificam capacidade própria?