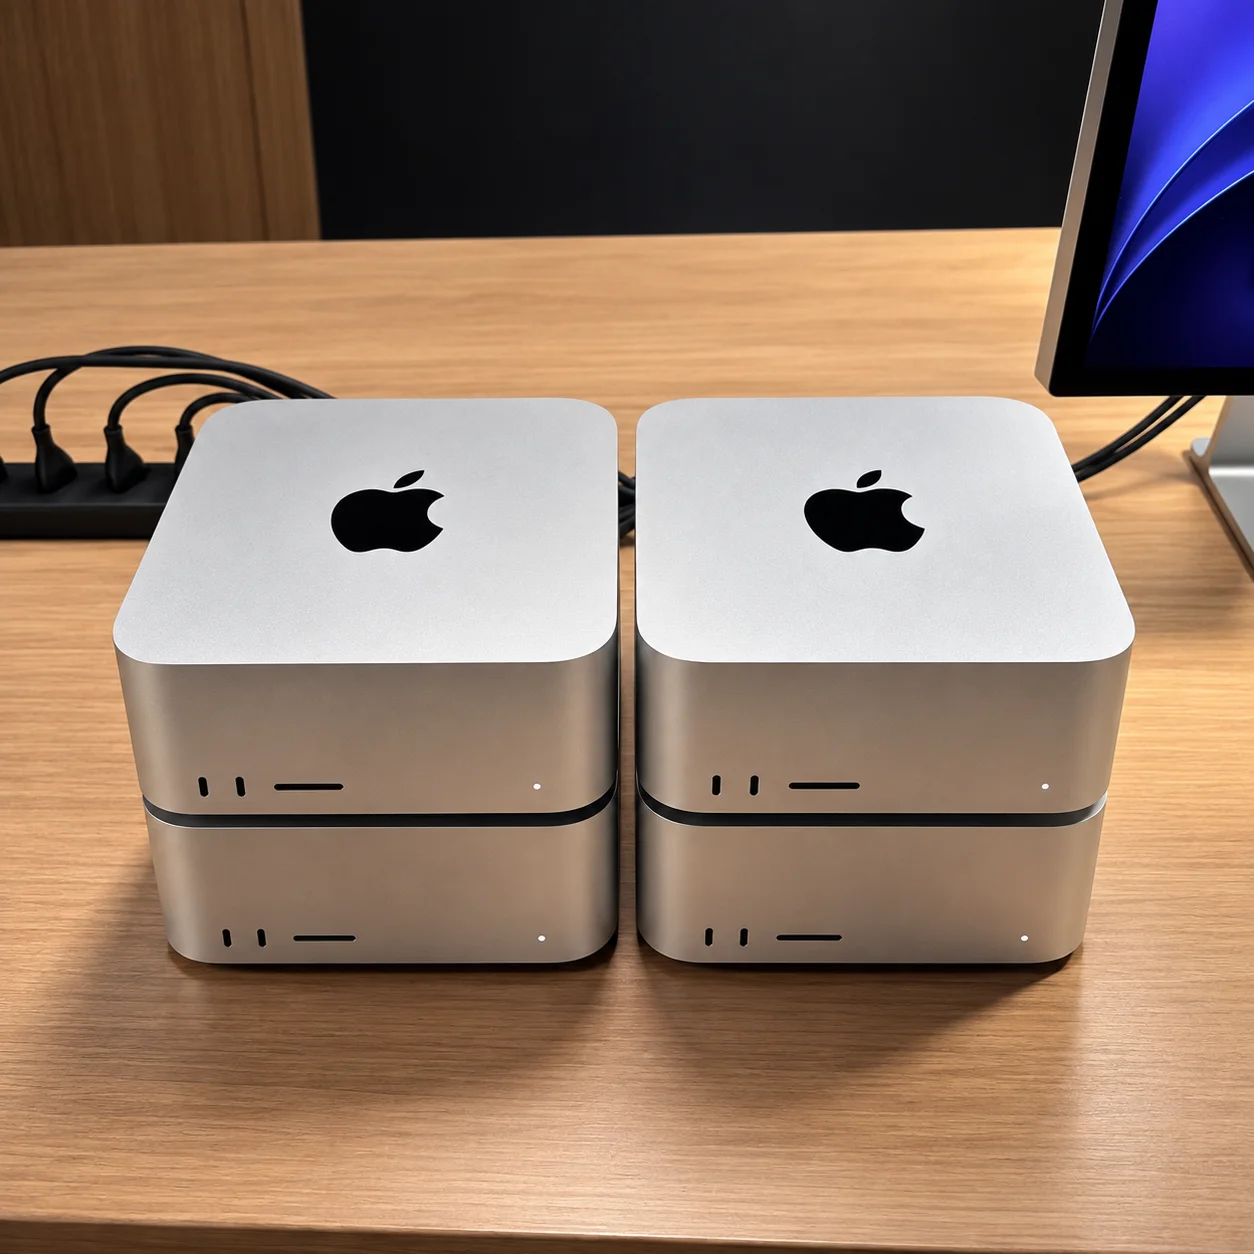
Apple comenzó a entregar el 22 de septiembre la nueva generación del Mac Studio con una propuesta inusual para un equipo de escritorio: convencer a las empresas de que parte de la inteligencia artificial puede salir de la nube y pasar a infraestructura propia. Con el M5 Ultra, múltiples máquinas pueden agruparse mediante Thunderbolt 5 y RDMA para ejecutar modelos open-weight de gran tamaño, transformando un gasto variable de inferencia en inversión en hardware.
La cuestión no es si un Mac puede ejecutar un modelo grande. La cuestión es cuándo comprar capacidad propia empieza a tener más sentido económico que pagar continuamente por el uso de IA en la nube.
Apple está intentando transformar los tokens en costo fijo
El M5 Ultra admite hasta 512 GB de memoria unificada y un ancho de banda de 1,2 TB/s. Apple también añadió compatibilidad con clústeres de Mac Studio conectados por Thunderbolt 5 con RDMA, una tecnología que permite la comunicación de baja latencia directamente entre la memoria de las máquinas. Según pruebas de la propia empresa, cuatro sistemas pueden alcanzar hasta tres veces el rendimiento de un único Mac Studio en inferencia distribuida.
Reuters presenció una demostración en la que cuatro Mac Studios ejecutaron un modelo de 1 billón de parámetros para localizar y corregir un problema en código gráfico. El conjunto funcionaba conectado a una sola toma de pared.
Es en ese punto donde la estrategia deja de ser solo técnica.
Los servicios de IA alojados normalmente convierten el uso en gasto operativo: a medida que una aplicación consume más tokens, llamadas o capacidad computacional, mayor tiende a ser la factura. En infraestructura propia, el costo no desaparece, pero cambia de naturaleza. La empresa paga por adelantado por la capacidad y puede reutilizarla sin un cargo adicional por cada inferencia.
Es esa diferencia la que Apple está tratando de explotar.
“Sin costo por token” no significa IA gratuita
La formulación que utiliza Apple es atractiva, pero requiere una salvedad importante.
El Mac Studio con M5 Ultra comienza en US$ 5.499 en los Estados Unidos, mientras que las configuraciones completas pueden acercarse a US$ 20 mil, según Reuters. Un clúster con varias unidades, por lo tanto, puede exigir decenas de miles de dólares antes de ejecutar su primera tarea de IA.
A eso se suman energía, almacenamiento, administración, actualización de modelos, observabilidad, redundancia y el riesgo de que el equipo quede ocioso.
El argumento económico se vuelve más fuerte cuando la utilización es alta, continua y relativamente predecible. Una empresa que ejecuta agentes internos, generación de código o procesamiento de documentos durante gran parte del día logra diluir la inversión en un volumen creciente de inferencias.
El escenario es diferente para aplicaciones con demanda irregular. La nube permite aumentar o reducir capacidad sin comprar máquinas para atender solo los picos.
Por eso, la comparación relevante no es simplemente “token pagado contra token gratuito”. Es costo total por trabajo útil producido, considerando inversión, operación y tasa de utilización. Los investigadores ya vienen proponiendo métricas que combinan CAPEX y OPEX justamente porque el precio por token o por hora de GPU, de forma aislada, no captura toda la economía de una implementación de IA.
Open-weight hace posible la cuenta
Existe además una diferencia estructural entre ejecutar un modelo localmente y contratar una API.
Las empresas no pueden simplemente descargar modelos propietarios de proveedores como OpenAI o Anthropic y transferirlos a un Mac Studio. El argumento de Apple depende principalmente del crecimiento de los modelos open-weight, cuyos pesos pueden ejecutarse en infraestructura controlada por el propio cliente.
Apple afirma que la agrupación de los Mac Studios crea capacidad suficiente para cargar algunos de los mayores modelos open-weight disponibles. MLX, el framework de machine learning de la empresa, ya admite computación distribuida y un backend llamado JACCL para comunicación RDMA vía Thunderbolt, incluso para técnicas como tensor parallelism.
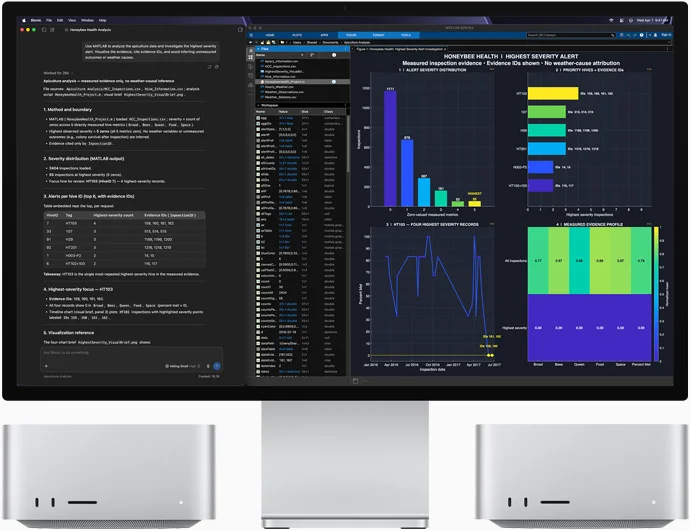
Esto abre una alternativa intermedia entre dos estructuras que hasta hace poco estaban bien separadas: APIs totalmente gestionadas por un lado y servidores especializados con GPUs de centro de datos por el otro.
El Mac Studio intenta ocupar el espacio de la infraestructura de IA que puede quedar literalmente dentro de la oficina.
Para las empresas que trabajan con código propietario, documentos internos o datos sensibles, existe además un segundo incentivo. Mantener la inferencia local puede reducir la cantidad de información enviada a infraestructura externa y dar mayor control sobre el almacenamiento y el procesamiento.
El mayor obstáculo puede no ser el chip
Tener memoria suficiente para cargar un modelo es solo parte del problema.
Los clústeres de IA tradicionales se desarrollaron en torno a un ecosistema maduro de GPUs, redes de alta velocidad, orquestación, monitoreo y herramientas de centro de datos. La alternativa de Apple todavía debe demostrar que puede ofrecer una simplicidad operativa comparable.
La propia documentación de MLX muestra que el RDMA por Thunderbolt todavía exige una configuración específica. Para activarlo, por ejemplo, es necesario entrar en el modo de recuperación de macOS, habilitar la función y posteriormente configurar la comunicación entre los nodos.
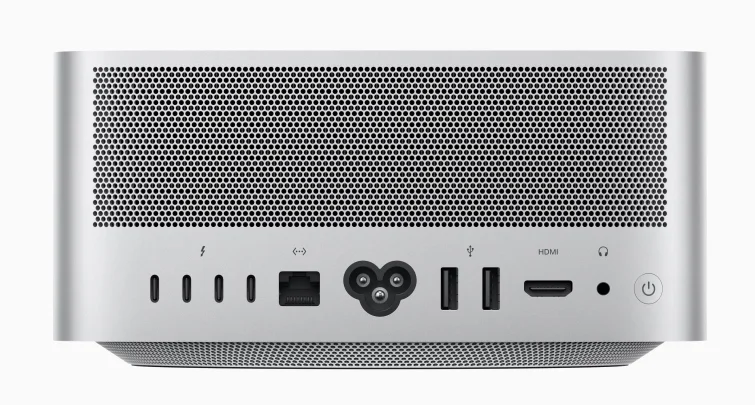
Ese tipo de fricción importa más en entornos corporativos que en demostraciones técnicas.
Apple también parte de una posición pequeña en el mercado empresarial de computadoras. Según datos de IDC citados por Reuters, los Mac representan cerca de 4,6% del mercado corporativo de desktops y notebooks, frente al 91,3% de máquinas Windows.
Para transformar el Mac Studio en infraestructura de IA, por lo tanto, la empresa necesita conquistar no solo a desarrolladores, sino también a equipos de TI acostumbrados a ecosistemas completamente diferentes.
El Mac Studio no necesita sustituir a la nube para cambiar la cuenta
El escenario más plausible no es una migración completa de la inferencia empresarial a desktops.
Es una arquitectura híbrida.
Las aplicaciones con demanda variable, necesidad de escala global o dependencia de los modelos propietarios más avanzados tienden a seguir favoreciendo a los servicios externos. En cambio, las cargas previsibles basadas en modelos open-weight pueden empezar a justificar infraestructura propia cuando el volumen hace que el cobro recurrente sea suficientemente relevante.
En ese escenario, la empresa podría mantener una capacidad local permanente para la carga básica y recurrir a la nube para picos o modelos especializados.
Es un cambio menor que abandonar el centro de datos, pero económicamente importante. Parte del presupuesto de IA deja de crecer directamente con el número de tokens procesados y pasa a depender de la utilización de activos ya adquiridos.
Las próximas señales vendrán de fuera de las demostraciones de Apple. Será necesario observar benchmarks independientes de throughput, latencia y consumo de energía, además de la adopción de clústeres Mac por parte de empresas en cargas reales y de la evolución de las herramientas para administrar múltiples máquinas.
También habrá una prueba inmediata de hardware. Aunque los nuevos Mac Studio hayan comenzado a llegar a los clientes el 22 de septiembre, la configuración M5 Ultra con 512 GB de memoria unificada solo está prevista para finales de octubre.
Si las organizaciones empiezan a mantener agentes, herramientas de desarrollo y otras cargas intensivas funcionando continuamente en estos sistemas, la propuesta económica de Apple ganará evidencia concreta.
Hasta entonces, el Mac Studio no elimina la nube. Hace más plausible una pregunta que las empresas tendrán que hacerse con frecuencia creciente: ¿qué cargas de trabajo de IA todavía deben alquilarse por token y cuáles ya justifican capacidad propia?