A otimização de taxa de conversão se torna muito mais útil quando deixa de ser uma coleção de ajustes em landing pages e se torna um sistema de experimentação.
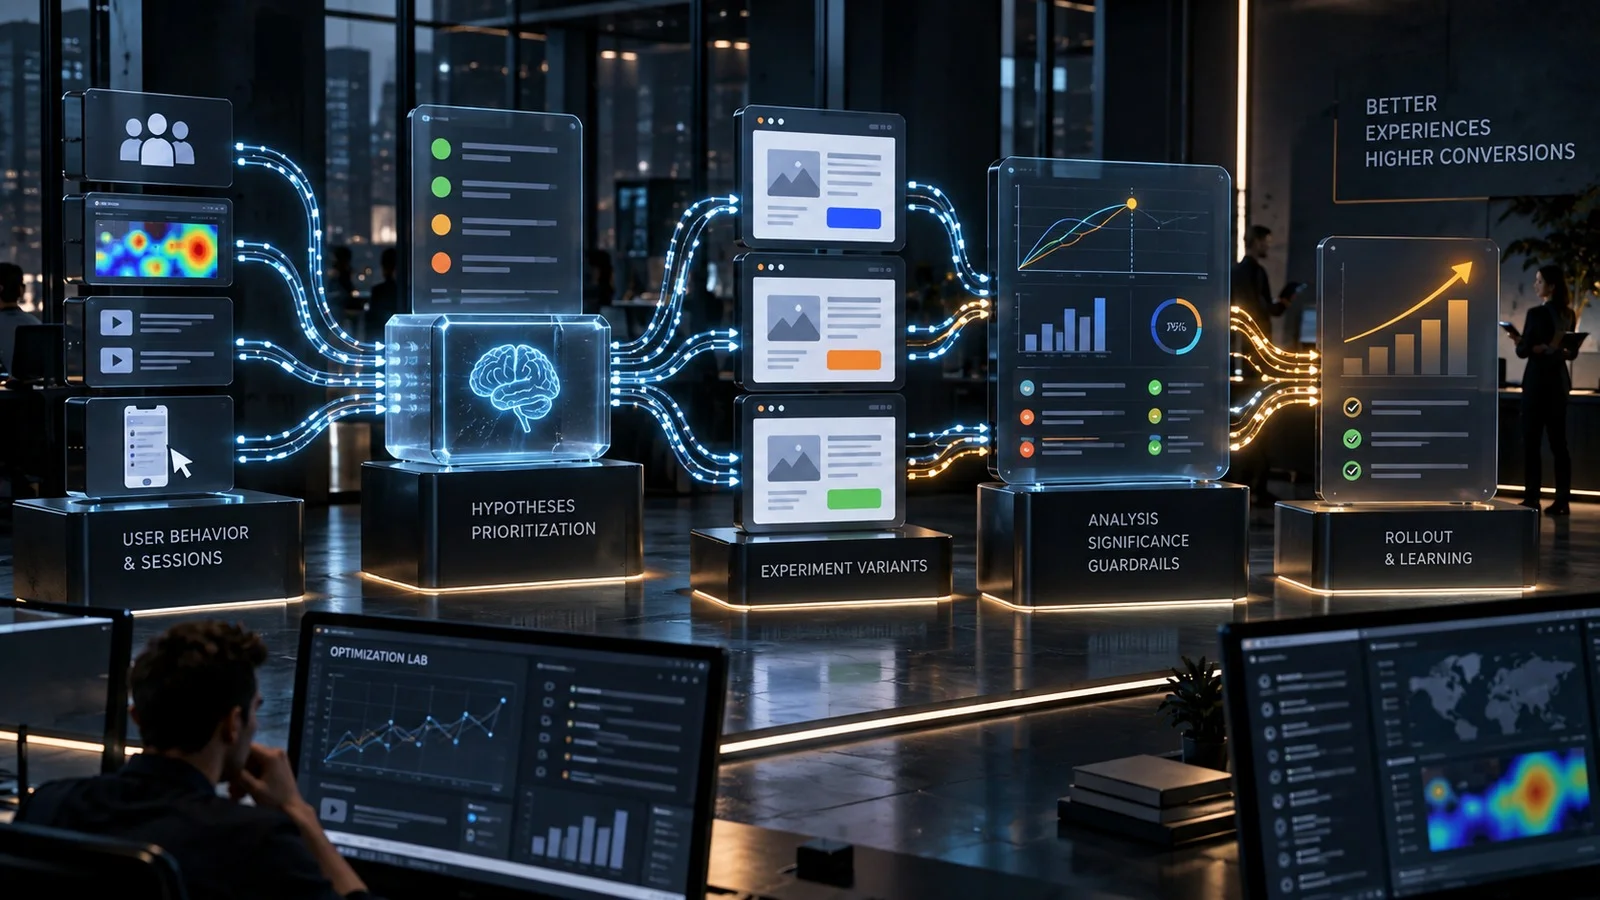
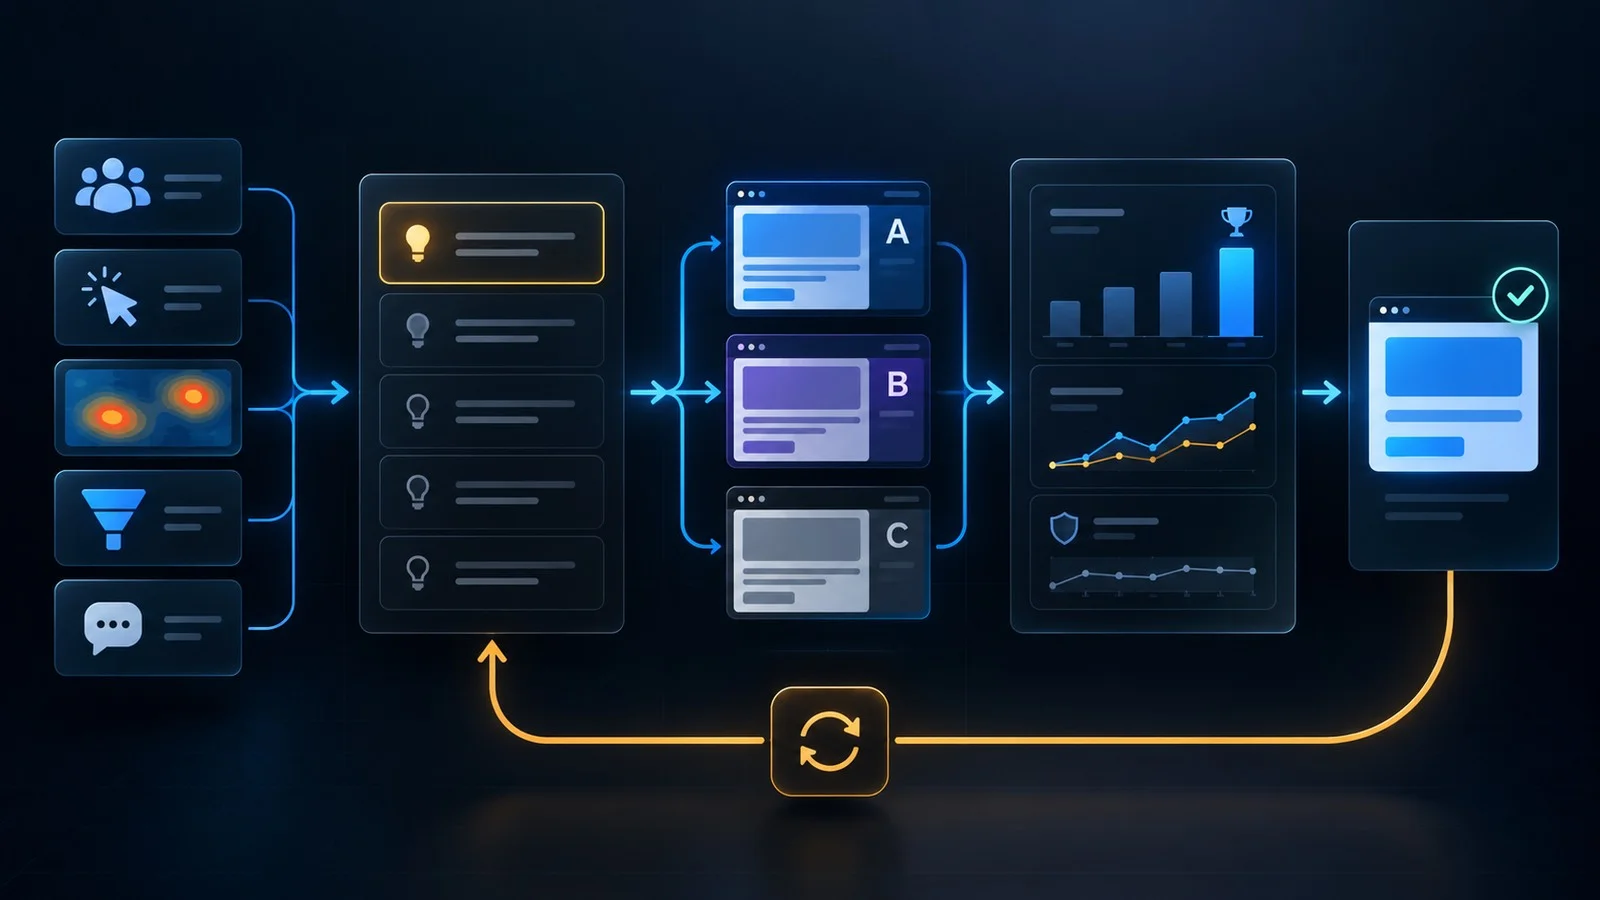
Um stack de experimentação maduro conecta quatro coisas:
- evidências sobre o comportamento do usuário;
- um backlog de hipóteses priorizado;
- entrega controlada de variantes;
- medição confiável de resultados e guardrails.
O software pode variar de ferramentas simples de teste visual a plataformas de feature flag integradas diretamente ao código da aplicação.
O modelo operacional importa mais do que o fornecedor.
Camada 1: evidências comportamentais
Experimentos devem começar com um motivo.
Fontes úteis de evidências incluem:
- web analytics;
- analytics de produto;
- análise de funil;
- consultas de busca;
- dados de CRM;
- replay de sessão;
- mapas de calor;
- pesquisas;
- tickets de suporte;
- objeções de vendas;
- testes de usabilidade.
O objetivo é identificar atrito ou incerteza.
Exemplos:
- visitantes mobile abandonam a página de preços com mais frequência do que visitantes desktop;
- usuários ativados permanecem, mas a maioria dos novos usuários nunca ativa;
- prospects perguntam repetidamente a mesma pergunta sobre implementação;
- visitantes interagem com conteúdo de comparação, mas não chegam às páginas de produto.
Essas evidências geram hipóteses.
Camada 2: o backlog de hipóteses
Uma hipótese deve explicar:
- qual segmento é afetado;
- qual mudança é proposta;
- por que ela deve funcionar;
- qual métrica deve se mover;
- o que pode ser prejudicado.
Exemplo:
Para visitantes mobile na 1ª visita à página de preços, substituir a matriz de planos por uma recomendação guiada deve aumentar os inícios de checkout porque a comparação atual exige escaneamento demais, sem aumentar a taxa de reembolso.
Isso é testável.
“Melhorar a página de preços” não é.
O backlog deve registrar:
- hipótese;
- evidência;
- responsável;
- impacto esperado;
- confiança;
- esforço;
- métrica-alvo;
- guardrails;
- status.
Priorize pelo valor de aprendizado
Um teste pode ser valioso mesmo quando não vence.
Experimentos de alto valor respondem a perguntas importantes.
Exemplos:
- Este público entende a proposta de valor?
- O preço ou a complexidade é a maior restrição?
- A prova social afeta compradores enterprise?
- Um caminho de onboarding mais curto melhora a ativação?
- Exigir cartão aumenta a qualidade da conversão paga?
Priorize experimentos em que a resposta muda uma decisão significativa.
Não preencha o calendário com testes cosméticos de baixo risco enquanto a incerteza estratégica permanece intocada.
Camada 3: entrega de experimentos
Há várias maneiras de entregar variantes.
Teste visual no lado do cliente
Útil para:
- texto;
- layout;
- mudanças simples em landing pages.
Vantagens:
- implementação rápida;
- amigável para profissionais de marketing.
As limitações podem incluir:
- impacto no desempenho;
- flicker;
- lógica de aplicação restrita.
Experimentação no lado do servidor
As variantes são atribuídas na lógica de backend.
Útil para:
- lógica de preços;
- comportamento de checkout;
- algoritmos de recomendação;
- experiências complexas.
Experimentação com feature flags
Experimentos são executados por meio de feature flags.
O Optimizely Feature Experimentation, por exemplo, oferece suporte a experimentos sobre feature flags, enquanto o Statsig usa SDKs e configuração de experimentos para atribuir variantes e medir métricas.
Esse modelo é útil porque rollout e experimentação compartilham a mesma infraestrutura de entrega.
Uma variante vencedora frequentemente pode ser expandida gradualmente em vez de reconstruída após o teste.
Escolha a unidade de randomização
O experimento precisa de uma unidade de atribuição estável.
As possibilidades incluem:
- usuário;
- conta;
- dispositivo;
- sessão;
- geografia.
A atribuição no nível do usuário funciona quando existe um identificador de usuário estável.
A randomização no nível da conta pode ser melhor em B2B, onde vários usuários pertencem a uma empresa.
A atribuição no nível do dispositivo pode ser útil para visitantes anônimos.
A unidade deve corresponder ao risco de contaminação.
Se usuários da mesma conta enterprise recebem experiências de preços diferentes, a atribuição no nível da conta pode ser mais apropriada.
Defina um scorecard antes do lançamento
O fluxo de experimentos atual do Statsig exige uma hipótese e um scorecard com pelo menos uma métrica primária.
Isso reflete um bom princípio operacional.
Antes de lançar, defina:
Métrica primária
O resultado principal.
Exemplos:
- conversão de compra;
- taxa de contas ativadas;
- conversão de demos qualificadas.
Métricas secundárias
Ajudam a explicar o mecanismo.
Exemplos:
- taxa de cliques;
- tempo até a ativação;
- preenchimento de formulário.
Métricas de guardrail
Protegem contra danos.
Exemplos:
- taxa de reembolso;
- churn;
- contato com suporte;
- desempenho da página;
- margem bruta.
Não adicione vinte métricas “primárias”.
Use feature flags para rollout seguro, não apenas para testes
Um stack de experimentação também pode melhorar a segurança da entrega.
Feature flags podem dar suporte a:
- preview interno;
- rollout percentual;
- rollout geográfico;
- allowlists de contas;
- rollback rápido.
Isso separa implantação de exposição.
Um recurso pode existir no código de produção sem estar visível para todos os usuários.
Isso reduz o risco operacional de grandes lançamentos.
Camada 4: análise estatística
A plataforma deve ajudar a responder:
- Há evidências de diferença?
- Qual é o tamanho do efeito?
- Quão incerta é a estimativa?
- As métricas de guardrail se moveram?
- Segmentos importantes são diferentes?
Evite reduzir a decisão a “verde significa vencedor”.
O negócio deve considerar:
- tamanho do efeito;
- incerteza;
- custo de implementação;
- comportamento downstream;
- aderência estratégica.
Um resultado estatisticamente detectável ainda pode ser economicamente irrelevante.
Evite decisões motivadas por peeking
Um problema comum é interromper um experimento assim que a variante preferida aparece à frente.
Isso aumenta o risco de agir com base em ruído.
Use a metodologia estatística da plataforma e regras de decisão predefinidas.
Documente antes do lançamento:
- duração esperada;
- alocação de tráfego;
- efeito prático mínimo;
- métrica primária;
- guardrails;
- condições de interrupção.
Não reescreva os critérios de sucesso depois de ver os dados.
Segmente com cuidado após o resultado primário
A análise de segmentos pode revelar diferenças úteis.
Exemplos:
- mobile vs. desktop;
- novos vs. recorrentes;
- geografia;
- plano;
- canal de aquisição.
Mas fatiar os resultados repetidamente pode produzir padrões falsos.
Trate descobertas inesperadas de subgrupos como novas hipóteses, a menos que o segmento tenha sido pré-especificado.
Conecte o CRO à receita
Uma equipe de CRO não deve otimizar apenas a conversão de página.
Um teste de landing page pode aumentar os envios de formulário enquanto reduz a qualidade dos leads.
Um teste de checkout pode aumentar a taxa de compra enquanto aumenta os reembolsos.
Um teste de onboarding pode aumentar a ativação enquanto prejudica a retenção de longo prazo.
Conecte métricas de experimento a sistemas downstream quando possível.
Exemplos:
- qualificação no CRM;
- receita;
- margem;
- retenção;
- lifetime value.
Quanto mais longo o horizonte de decisão, mais valiosa se torna a validação downstream.
Adicione pesquisa qualitativa ao stack
Nem todo problema deve ser testado em A/B.
Se a equipe não entende por que os usuários falham, a pesquisa pode ser mais valiosa.
Use:
- entrevistas;
- sessões de usabilidade;
- respostas de pesquisas;
- gravações de vendas;
- dados de suporte.
Depois, teste a intervenção criada a partir desse insight.
A experimentação é um método dentro de uma prática de otimização mais ampla.
Biblioteca de experimentos
Todo teste concluído deve ser armazenado.
Inclua:
- hipótese;
- evidência;
- público;
- detalhes da variante;
- capturas de tela;
- datas;
- métricas;
- resultado;
- decisão;
- acompanhamento.
Marque por:
- estágio do funil;
- público;
- página;
- problema;
- mensagem;
- área do produto.
A biblioteca evita testes repetidos e constrói conhecimento institucional.
Um stack prático de CRO
- Análise de dados — Funis, coortes, segmentos
- Comportamento — Replay, mapas de calor, evidências qualitativas
- Pesquisa — Pesquisas, entrevistas, feedback
- Backlog — Hipóteses, prioridade, responsabilidade
- Experimentação — Testes A/B e multivariados
- Entrega de features — Flags, direcionamento, rollout
- Medição — Primária, secundária, guardrails
- Warehouse/CRM — Qualidade downstream e receita
- Conhecimento — Arquivo de experimentos
Uma empresa não precisa de um fornecedor dedicado em todas as categorias.
Escolha o menor sistema que dá suporte à maturidade de experimentação da equipe.
Quando não executar um experimento
Evite testar quando:
- o tráfego é muito baixo;
- a mudança é exigida por lei;
- a experiência atual está obviamente quebrada;
- o custo de executar o teste supera o valor da decisão;
- pesquisa qualitativa é necessária primeiro.
Às vezes, a ação correta é simplesmente corrigir o problema.
Checklist do stack de experimentação
Confirme:
- Há evidências por trás da hipótese?
- O segmento-alvo está definido?
- A atribuição é estável?
- A métrica primária está especificada?
- Os guardrails estão definidos?
- O tracking foi validado antes do lançamento?
- A regra de interrupção está documentada?
- A mudança pode ser revertida?
- Os efeitos downstream serão verificados?
- O resultado será armazenado?
- A próxima ação depende do resultado?
O melhor stack de CRO não produz o maior número de experimentos.
Ele cria um ciclo disciplinado:
observar → formular hipóteses → testar → medir → aprender → fazer rollout → observar novamente.
Esse ciclo é o verdadeiro sistema de otimização.
Alinhe o stack à maturidade de experimentação
O stack de experimentação ideal muda conforme a organização amadurece.
Estágio inicial
Uma equipe pequena pode precisar apenas de:
- analytics confiável;
- pesquisa qualitativa;
- um rastreador de hipóteses;
- experimentos simples em landing pages.
A maior oportunidade geralmente é disciplina de aprendizado, não infraestrutura.
Programa em crescimento
Conforme o volume de experimentos aumenta, adicione:
- registros centralizados de experimentos;
- atribuição estável;
- métricas reutilizáveis;
- QA automatizado;
- relatórios de guardrail;
- feature flags onde os testes de produto as exigem.
Nesse estágio, a governança se torna mais importante porque várias equipes podem interferir umas nas outras.
Programa maduro
Uma organização de experimentação madura pode precisar de:
- definições compartilhadas de métricas;
- SDKs de experimentação;
- integração com warehouse;
- randomização no nível de conta ou dispositivo;
- registro automatizado de exposição;
- detecção de interação entre experimentos;
- aprendizado no nível do portfólio.
O stack deve evoluir apenas quando a complexidade operacional justificar.
Um erro comum é comprar infraestrutura de experimentação enterprise antes de a organização ter um processo repetível de hipóteses. A plataforma então se torna um lugar caro para executar testes de baixo valor.
Construa maturidade de processo e maturidade técnica juntas.