La optimización de la tasa de conversión se vuelve mucho más útil cuando deja de ser una colección de ajustes en landing pages y se convierte en un sistema de experimentación.
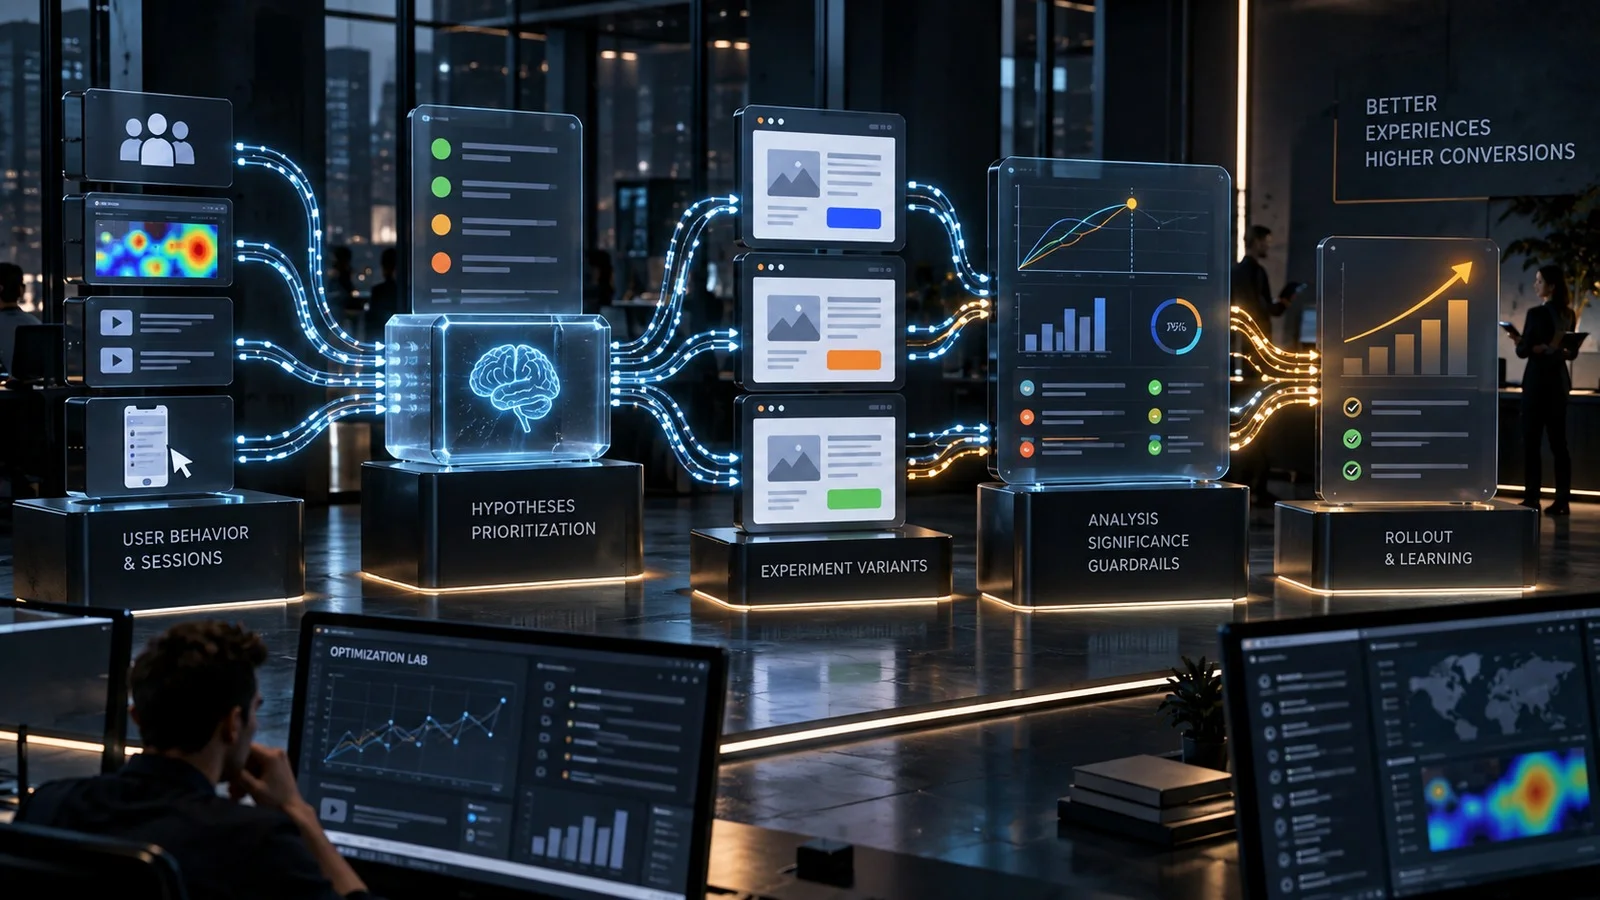
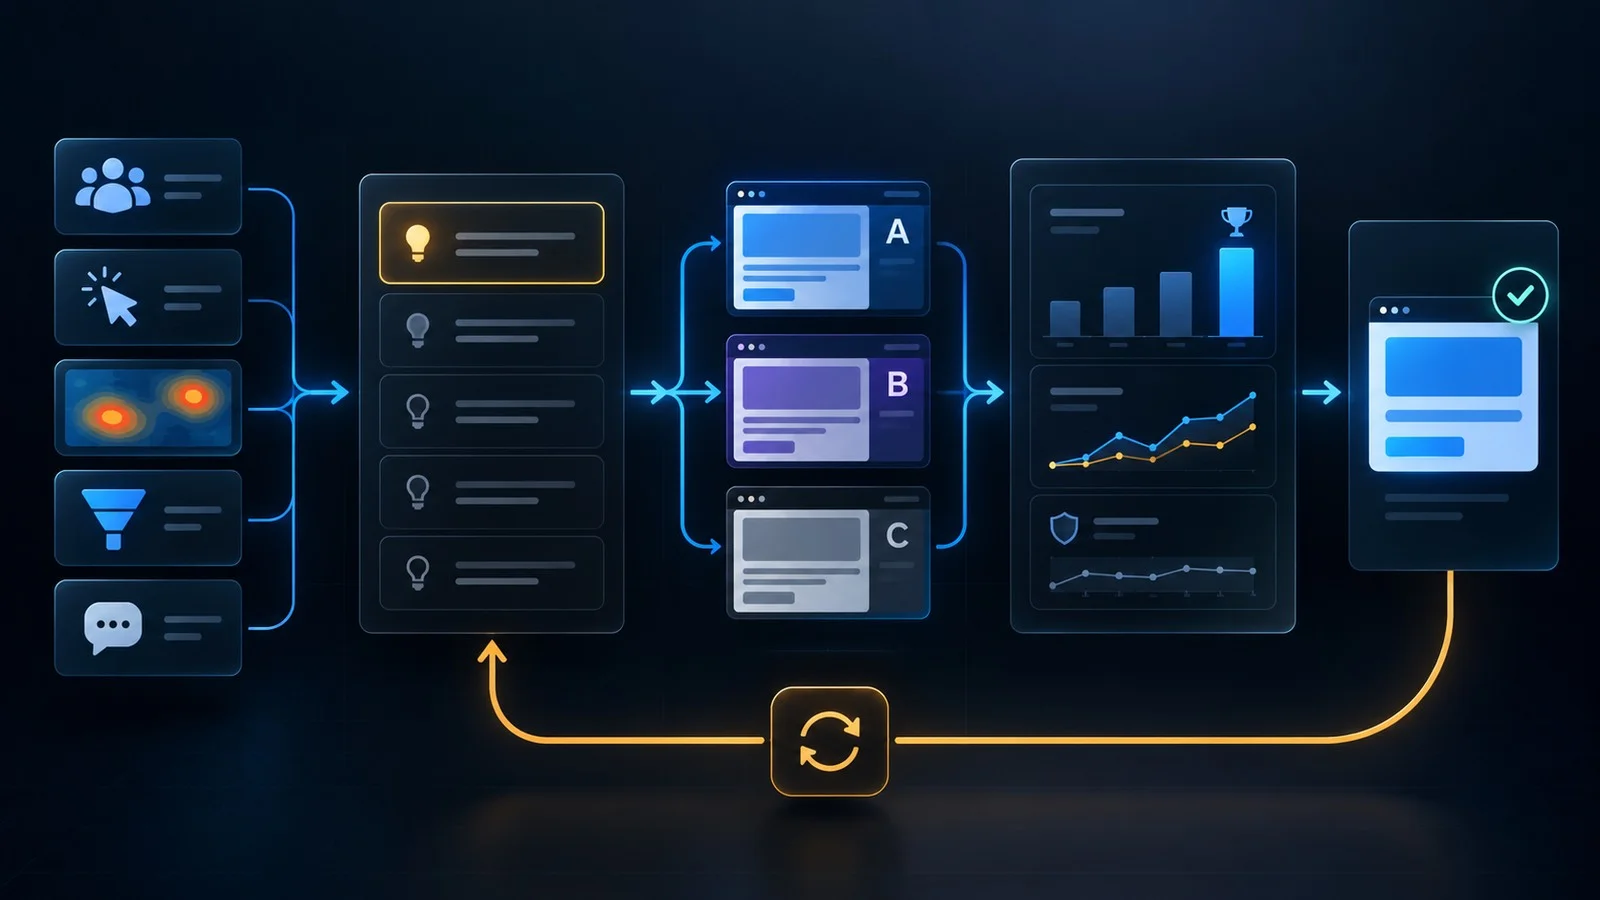
Un stack de experimentación maduro conecta cuatro cosas:
- evidencias sobre el comportamiento del usuario;
- un backlog de hipótesis priorizado;
- entrega controlada de variantes;
- medición confiable de resultados y guardrails.
El software puede variar desde herramientas simples de prueba visual hasta plataformas de feature flags integradas directamente en el código de la aplicación.
El modelo operativo importa más que el proveedor.
Capa 1: evidencias de comportamiento
Los experimentos deben comenzar con un motivo.
Las fuentes útiles de evidencias incluyen:
- web analytics;
- analytics de producto;
- análisis de embudo;
- consultas de búsqueda;
- datos de CRM;
- replay de sesión;
- mapas de calor;
- encuestas;
- tickets de soporte;
- objeciones de ventas;
- pruebas de usabilidad.
El objetivo es identificar fricción o incertidumbre.
Ejemplos:
- los visitantes móviles abandonan la página de precios con más frecuencia que los visitantes de escritorio;
- los usuarios activados permanecen, pero la mayoría de los nuevos usuarios nunca se activa;
- los prospects preguntan repetidamente la misma pregunta sobre implementación;
- los visitantes interactúan con contenido de comparación, pero no llegan a las páginas de producto.
Esas evidencias generan hipótesis.
Capa 2: el backlog de hipótesis
Una hipótesis debe explicar:
- qué segmento se ve afectado;
- qué cambio se propone;
- por qué debería funcionar;
- qué métrica debería moverse;
- qué puede verse perjudicado.
Ejemplo:
Para visitantes móviles en la 1.ª visita a la página de precios, sustituir la matriz de planes por una recomendación guiada debería aumentar los inicios de checkout porque la comparación actual exige demasiado escaneo, sin aumentar la tasa de reembolso.
Esto es testable.
“Mejorar la página de precios” no lo es.
El backlog debe registrar:
- hipótesis;
- evidencia;
- responsable;
- impacto esperado;
- confianza;
- esfuerzo;
- métrica objetivo;
- guardrails;
- estado.
Priorice por el valor de aprendizaje
Una prueba puede ser valiosa incluso cuando no gana.
Los experimentos de alto valor responden a preguntas importantes.
Ejemplos:
- ¿Este público entiende la propuesta de valor?
- ¿El precio o la complejidad es la mayor restricción?
- ¿La prueba social afecta a los compradores enterprise?
- ¿Un camino de onboarding más corto mejora la activación?
- ¿Exigir tarjeta aumenta la calidad de la conversión paga?
Priorice los experimentos en los que la respuesta cambia una decisión significativa.
No llene el calendario con pruebas cosméticas de bajo riesgo mientras la incertidumbre estratégica sigue intacta.
Capa 3: entrega de experimentos
Hay varias maneras de entregar variantes.
Prueba visual del lado del cliente
Útil para:
- texto;
- layout;
- cambios simples en landing pages.
Ventajas:
- implementación rápida;
- amigable para profesionales de marketing.
Las limitaciones pueden incluir:
- impacto en el rendimiento;
- flicker;
- lógica de aplicación restringida.
Experimentación del lado del servidor
Las variantes se asignan en la lógica de backend.
Útil para:
- lógica de precios;
- comportamiento de checkout;
- algoritmos de recomendación;
- experiencias complejas.
Experimentación con feature flags
Los experimentos se ejecutan mediante feature flags.
Optimizely Feature Experimentation, por ejemplo, ofrece soporte para experimentos sobre feature flags, mientras que Statsig usa SDKs y configuración de experimentos para asignar variantes y medir métricas.
Este modelo es útil porque el rollout y la experimentación comparten la misma infraestructura de entrega.
Con frecuencia, una variante ganadora puede expandirse gradualmente en lugar de reconstruirse después de la prueba.
Elija la unidad de aleatorización
El experimento necesita una unidad de asignación estable.
Las posibilidades incluyen:
- usuario;
- cuenta;
- dispositivo;
- sesión;
- geografía.
La asignación a nivel de usuario funciona cuando existe un identificador de usuario estable.
La aleatorización a nivel de cuenta puede ser mejor en B2B, donde varios usuarios pertenecen a una empresa.
La asignación a nivel de dispositivo puede ser útil para visitantes anónimos.
La unidad debe corresponder al riesgo de contaminación.
Si los usuarios de la misma cuenta enterprise reciben experiencias de precios diferentes, la asignación a nivel de cuenta puede ser más apropiada.
Defina un scorecard antes del lanzamiento
El flujo actual de experimentos de Statsig exige una hipótesis y un scorecard con al menos una métrica primaria.
Esto refleja un buen principio operativo.
Antes de lanzar, defina:
Métrica primaria
El resultado principal.
Ejemplos:
- conversión de compra;
- tasa de cuentas activadas;
- conversión de demos calificadas.
Métricas secundarias
Ayudan a explicar el mecanismo.
Ejemplos:
- tasa de clics;
- tiempo hasta la activación;
- finalización de formulario.
Métricas de guardrail
Protegen contra daños.
Ejemplos:
- tasa de reembolso;
- churn;
- contacto con soporte;
- rendimiento de la página;
- margen bruto.
No añada veinte métricas “primarias”.
Use feature flags para un rollout seguro, no solo para pruebas
Un stack de experimentación también puede mejorar la seguridad de la entrega.
Los feature flags pueden dar soporte a:
- preview interno;
- rollout porcentual;
- rollout geográfico;
- allowlists de cuentas;
- rollback rápido.
Esto separa el despliegue de la exposición.
Una funcionalidad puede existir en el código de producción sin estar visible para todos los usuarios.
Esto reduce el riesgo operativo de los grandes lanzamientos.
Capa 4: análisis estadístico
La plataforma debe ayudar a responder:
- ¿Hay evidencias de diferencia?
- ¿Cuál es el tamaño del efecto?
- ¿Qué tan incierta es la estimación?
- ¿Se movieron las métricas de guardrail?
- ¿Los segmentos importantes son diferentes?
Evite reducir la decisión a “verde significa ganador”.
El negocio debe considerar:
- tamaño del efecto;
- incertidumbre;
- costo de implementación;
- comportamiento downstream;
- alineación estratégica.
Un resultado estadísticamente detectable aún puede ser económicamente irrelevante.
Evite las decisiones motivadas por el peeking
Un problema común es interrumpir un experimento en cuanto la variante preferida aparece por delante.
Esto aumenta el riesgo de actuar con base en ruido.
Use la metodología estadística de la plataforma y reglas de decisión predefinidas.
Documente antes del lanzamiento:
- duración esperada;
- asignación de tráfico;
- efecto práctico mínimo;
- métrica primaria;
- guardrails;
- condiciones de interrupción.
No reescriba los criterios de éxito después de ver los datos.
Segmente con cuidado después del resultado primario
El análisis de segmentos puede revelar diferencias útiles.
Ejemplos:
- móvil vs. escritorio;
- nuevos vs. recurrentes;
- geografía;
- plan;
- canal de adquisición.
Pero dividir los resultados repetidamente puede producir patrones falsos.
Trate los hallazgos inesperados de subgrupos como nuevas hipótesis, a menos que el segmento se haya preespecificado.
Conecte el CRO con los ingresos
Un equipo de CRO no debe optimizar solo la conversión de página.
Una prueba de landing page puede aumentar los envíos de formulario mientras reduce la calidad de los leads.
Una prueba de checkout puede aumentar la tasa de compra mientras aumentan los reembolsos.
Una prueba de onboarding puede aumentar la activación mientras perjudica la retención a largo plazo.
Conecte las métricas de experimento con sistemas downstream cuando sea posible.
Ejemplos:
- calificación en el CRM;
- ingresos;
- margen;
- retención;
- lifetime value.
Cuanto más largo el horizonte de decisión, más valiosa se vuelve la validación downstream.
Añada investigación cualitativa al stack
No todo problema debe probarse en A/B.
Si el equipo no entiende por qué fallan los usuarios, la investigación puede ser más valiosa.
Use:
- entrevistas;
- sesiones de usabilidad;
- respuestas de encuestas;
- grabaciones de ventas;
- datos de soporte.
Después, pruebe la intervención creada a partir de ese insight.
La experimentación es un método dentro de una práctica de optimización más amplia.
Biblioteca de experimentos
Toda prueba concluida debe almacenarse.
Incluya:
- hipótesis;
- evidencia;
- público;
- detalles de la variante;
- capturas de pantalla;
- fechas;
- métricas;
- resultado;
- decisión;
- seguimiento.
Etiquete por:
- etapa del embudo;
- público;
- página;
- problema;
- mensaje;
- área del producto.
La biblioteca evita pruebas repetidas y construye conocimiento institucional.
Un stack práctico de CRO
- Análisis de datos — Embudos, cohortes, segmentos
- Comportamiento — Replay, mapas de calor, evidencias cualitativas
- Investigación — Encuestas, entrevistas, feedback
- Backlog — Hipótesis, prioridad, responsabilidad
- Experimentación — Pruebas A/B y multivariadas
- Entrega de funcionalidades — Flags, segmentación, rollout
- Medición — Primaria, secundaria, guardrails
- Warehouse/CRM — Calidad downstream e ingresos
- Conocimiento — Archivo de experimentos
Una empresa no necesita un proveedor dedicado en todas las categorías.
Elija el sistema más pequeño que dé soporte a la madurez de experimentación del equipo.
Cuándo no ejecutar un experimento
Evite probar cuando:
- el tráfico es muy bajo;
- el cambio es exigido por ley;
- la experiencia actual está obviamente rota;
- el costo de ejecutar la prueba supera el valor de la decisión;
- se necesita investigación cualitativa primero.
A veces, la acción correcta es simplemente corregir el problema.
Checklist del stack de experimentación
Confirme:
- ¿Hay evidencias detrás de la hipótesis?
- ¿El segmento objetivo está definido?
- ¿La asignación es estable?
- ¿La métrica primaria está especificada?
- ¿Los guardrails están definidos?
- ¿El tracking se validó antes del lanzamiento?
- ¿La regla de interrupción está documentada?
- ¿El cambio puede revertirse?
- ¿Se verificarán los efectos downstream?
- ¿El resultado se almacenará?
- ¿La próxima acción depende del resultado?
El mejor stack de CRO no produce el mayor número de experimentos.
Crea un ciclo disciplinado:
observar → formular hipótesis → probar → medir → aprender → hacer rollout → observar de nuevo.
Ese ciclo es el verdadero sistema de optimización.
Alinee el stack con la madurez de experimentación
El stack de experimentación ideal cambia a medida que la organización madura.
Etapa inicial
Un equipo pequeño puede necesitar solo:
- analytics confiable;
- investigación cualitativa;
- un rastreador de hipótesis;
- experimentos simples en landing pages.
La mayor oportunidad suele ser la disciplina de aprendizaje, no la infraestructura.
Programa en crecimiento
A medida que aumenta el volumen de experimentos, añada:
- registros centralizados de experimentos;
- asignación estable;
- métricas reutilizables;
- QA automatizado;
- informes de guardrail;
- feature flags donde las pruebas de producto las requieran.
En esta etapa, la gobernanza se vuelve más importante porque varios equipos pueden interferir entre sí.
Programa maduro
Una organización de experimentación madura puede necesitar:
- definiciones compartidas de métricas;
- SDKs de experimentación;
- integración con warehouse;
- aleatorización a nivel de cuenta o dispositivo;
- registro automatizado de exposición;
- detección de interacción entre experimentos;
- aprendizaje a nivel de portafolio.
El stack debe evolucionar solo cuando la complejidad operativa lo justifique.
Un error común es comprar infraestructura de experimentación enterprise antes de que la organización tenga un proceso repetible de hipótesis. La plataforma se convierte entonces en un lugar caro para ejecutar pruebas de bajo valor.
Construya madurez de proceso y madurez técnica en conjunto.