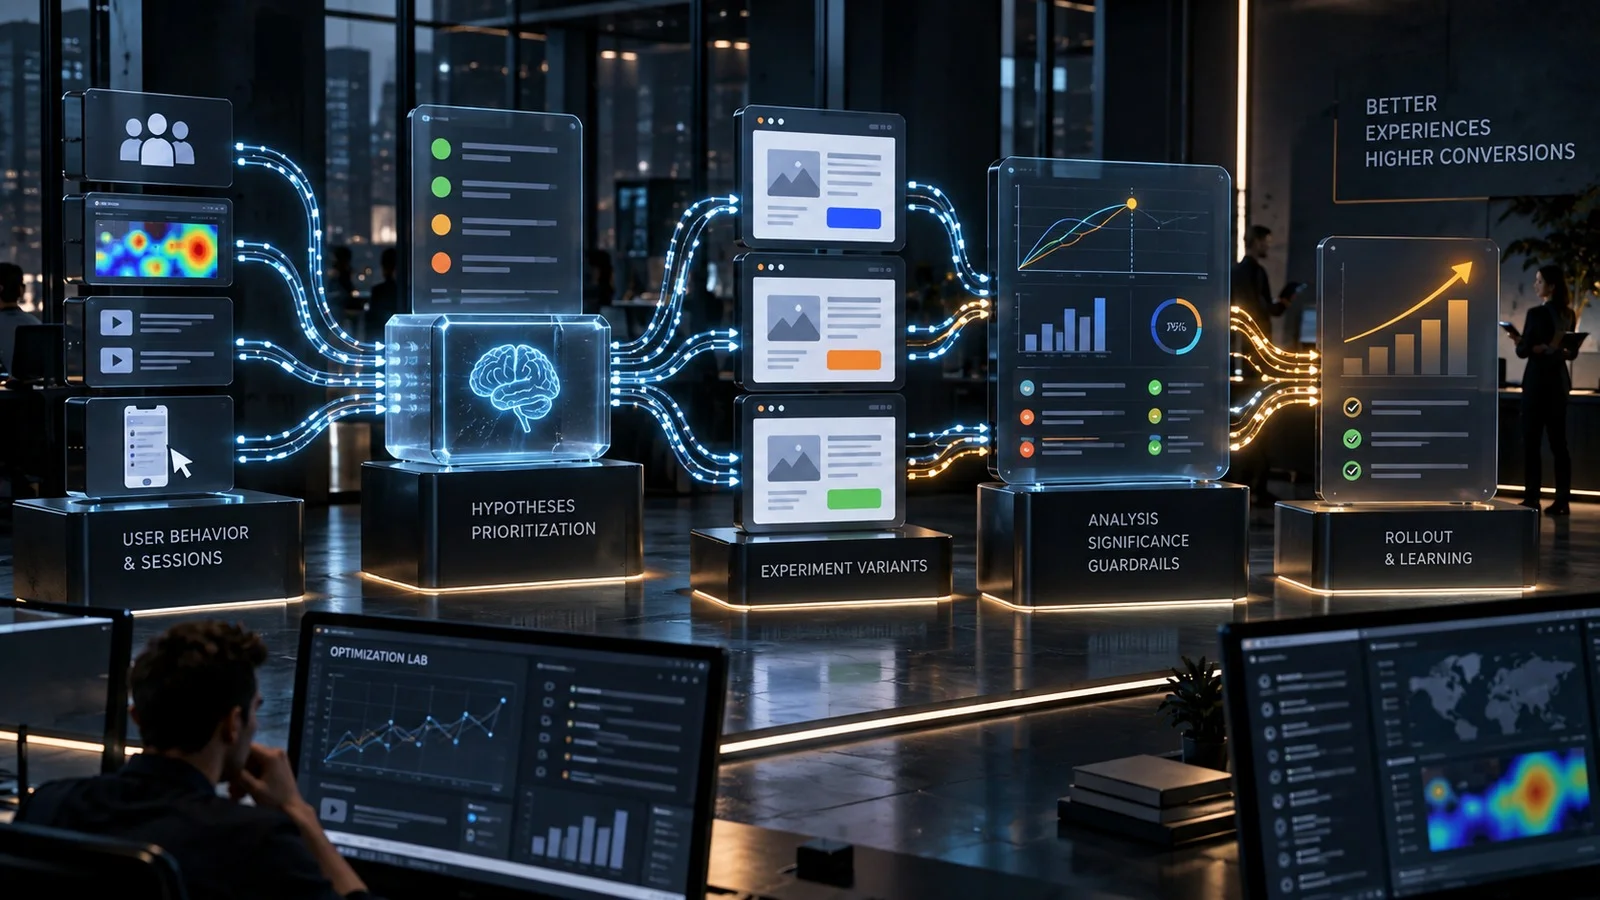
O go-to-market liderado por experimentação substitui um grande plano de lançamento não testado por uma sequência de hipóteses explícitas.
A ideia é simples: mercados contêm incerteza. Público, posicionamento, canais, precificação, criativos, onboarding e motion de vendas envolvem suposições. Em vez de tratar essas suposições como fatos, uma equipe liderada por experimentação transforma as mais importantes em testes.
O propósito não é executar mais testes A/B. É construir um processo repetível para aprender o que merece ser escalado.
Comece pela suposição mais arriscada
Um plano de GTM contém várias camadas de risco:
- risco de mercado;
- risco de público;
- risco de problema;
- risco de posicionamento;
- risco de canal;
- risco de conversão;
- risco de retenção;
- risco econômico.
Equipes frequentemente testam a coisa mais fácil em vez da de maior consequência.
Mudar a cor de um botão é fácil. Testar se a equipe está mirando o comprador errado é mais difícil e mais importante.
Liste as suposições por trás do plano e pontue-as por:
- impacto se estiver errada;
- incerteza;
- custo de aprender depois.
Teste as suposições de maior risco primeiro.
Escreva hipóteses que possam falhar
Uma hipótese útil tem:
- segmento-alvo;
- intervenção;
- comportamento esperado;
- resultado mensurável;
- horizonte temporal.
Exemplo:
Para líderes de operações em empresas com 50–250 funcionários, uma landing page focada em reduzir a reconciliação manual gerará pelo menos 20% mais solicitações qualificadas de demonstração do que a mensagem de produtividade existente ao longo de quatro semanas, sem reduzir a qualidade das oportunidades.
Isso é mais forte do que:
Testar novas mensagens.
A primeira afirmação pode produzir uma decisão.
Construa uma escada de evidências
Nem toda pergunta exige um experimento caro.
Use o método crível mais barato primeiro.
Nível 1: evidência qualitativa
- entrevistas;
- conversas de suporte;
- chamadas de vendas;
- análise de ganhos/perdas;
- consultas de busca;
- discussões em comunidades.
Útil para descobrir linguagem, problemas e objeções.
Nível 2: evidência comportamental
- comportamento na landing page;
- eventos de produto;
- dados de CRM;
- análise de coorte;
- análise de funil.
Útil para identificar onde o comportamento diverge das suposições.
Nível 3: smoke tests
- listas de espera;
- testes de mensagem;
- páginas de protótipo;
- testes de demanda;
- campanhas pagas limitadas.
Útil antes de construir funcionalidades caras ou entrar em um novo segmento.
Nível 4: experimentos controlados
- testes A/B;
- holdouts;
- testes randomizados;
- experimentos geográficos.
Útil para estimar impacto causal quando existe volume suficiente.
Nível 5: validação em escala
A intervenção é ampliada e monitorada em condições reais de operação.
Essa progressão evita superengenharia na validação inicial.
Priorize experimentos
Um backlog pode se tornar outra forma de procrastinação.
Use um sistema de pontuação consistente.
Um modelo simples é:
prioridade = impacto × confiança ÷ esforço
Outro pode incluir importância estratégica e velocidade de aprendizado.
A fórmula exata importa menos do que a comparação consistente.
Para cada experimento, documente:
- hipótese;
- público;
- responsável;
- métrica primária;
- métricas de proteção;
- duração esperada;
- esforço de implementação;
- regra de decisão;
- dependências.
Evite priorizar apenas pela facilidade.
Escolha uma métrica primária
Um experimento deve ter uma métrica primária sempre que possível.
Exemplos:
- conversão de demonstrações qualificadas;
- conclusão de checkout;
- taxa de ativação;
- conversão para pago;
- receita retida.
Depois, defina métricas de proteção.
Exemplo:
Primária:
- conversão de teste para pago.
Métricas de proteção:
- taxa de reembolso;
- tickets de suporte;
- retenção de 30 dias.
Isso impede que a equipe declare vitória em uma métrica local enquanto prejudica o sistema mais amplo.
Use analytics para direcionar o experimento
A experimentação funciona melhor quando parte de evidências.
O analytics pode revelar:
- etapas de funil com queda incomum;
- segmentos com comportamento materialmente diferente;
- páginas com tráfego forte, mas conversão fraca;
- coortes com retenção ruim;
- campanhas com custo alto, mas forte valor downstream.
A Amplitude descreve a experimentação como um processo conectado ao analytics comportamental: use dados para identificar atrito, definir uma hipótese, executar um teste e então analisar como as variantes afetam a jornada mais ampla do usuário.
O princípio importante não é a ferramenta. É a conexão entre observação e design de teste.
Alinhe o design do teste à decisão
Nem todo teste deve ser um teste A/B.
Teste A/B
Use quando:
- as variantes podem ser atribuídas aleatoriamente;
- o volume é suficiente;
- o ambiente é estável o suficiente;
- a intervenção pode ser isolada.
Implantação sequencial
Use quando o risco exigir exposição gradual.
Experimento geográfico
Útil para efeitos de mídia ou offline em que a randomização no nível do usuário é difícil.
Holdout
Útil para estimar impacto incremental.
Análise antes/depois
A mais fraca para inferência causal, mas às vezes a única opção prática. Use com cautela e considere sazonalidade e outras mudanças.
Validação qualitativa
Use antes do teste quantitativo quando a equipe ainda está tentando entender o problema.
O método deve corresponder à incerteza.
Defina uma regra de decisão antes de ver o resultado
Equipes são vulneráveis à interpretação motivada.
Antes do lançamento, escreva:
- efeito mínimo aceitável;
- limiar de confiança ou evidência;
- duração máxima;
- limites de proteção;
- o que acontece se o resultado for positivo;
- o que acontece se ele for neutro;
- o que acontece se ele for negativo.
Exemplo:
Se a conversão qualificada melhorar pelo menos 15% e a qualidade das oportunidades não cair mais de 5%, leve a mensagem para 100% do tráfego e teste o próximo segmento. Se o efeito for abaixo de 5%, pare. Se o resultado ficar entre 5% e 15%, colete outro ciclo, a menos que o custo exceda o valor de aprendizado.
Os limiares exatos dependem do negócio.
A disciplina é o que importa.
Não pare na significância estatística
Um efeito estatisticamente detectável ainda pode ser economicamente irrelevante.
Pergunte:
- O efeito é grande o suficiente para importar?
- Ele persiste downstream?
- Ele melhora a economia unitária?
- Ele funciona no segmento prioritário?
- O efeito justifica a complexidade de implementação?
- É provável que sobreviva em escala?
Um aumento de 1% na conversão pode ser extremamente valioso em grande escala e sem sentido em pequena escala.
O contexto de negócio determina a materialidade.
Trate resultados negativos como úteis
Um resultado negativo pode eliminar um investimento ruim.
Se uma equipe descobre que um segmento não responde a uma proposta de valor apresentada antes de passar seis meses construindo um pacote de produto dedicado, o experimento criou valor.
A meta não é uma alta “taxa de vitória”.
Uma taxa de vitória suspeitamente alta pode indicar:
- hipóteses fracas;
- relato seletivo;
- testes pequenos demais;
- critérios de sucesso alterados após o lançamento.
Um programa saudável produz resultados positivos, negativos e inconclusivos.
Armazene aprendizados, não apenas resultados
Um banco de dados de experimentos deve capturar:
- hipótese;
- contexto;
- capturas de tela ou detalhes das variantes;
- público;
- datas;
- métricas;
- resultado;
- interpretação;
- decisão;
- pergunta de acompanhamento.
Isso impede que as equipes repitam testes antigos e cria memória institucional.
Etiquete os aprendizados por:
- público;
- problema;
- mensagem;
- canal;
- etapa do funil;
- área de produto.
Com o tempo, a biblioteca de experimentos se torna um ativo estratégico.
Escale vencedores com cuidado
Um teste bem-sucedido em um contexto pode falhar em escala maior.
Os motivos incluem:
- expansão de público;
- fadiga criativa;
- saturação de canal;
- capacidade operacional;
- restrições de acompanhamento de vendas;
- geografias diferentes;
- dispositivos diferentes;
- efeitos de novidade.
Escale em etapas.
Para um experimento de aquisição paga:
- valide a mensagem;
- valide a landing page;
- valide a conversão qualificada;
- aumente o orçamento;
- monitore o CAC marginal;
- verifique a retenção ou a qualidade da receita.
Escalar é outro experimento.
Conecte a experimentação ao sistema de GTM
Os experimentos de maior valor frequentemente atravessam fronteiras de equipes.
Exemplos:
Experimento de público
Marketing e vendas testam se um ICP mais restrito melhora a qualidade do pipeline.
Experimento de posicionamento
Marketing testa duas formulações do problema enquanto vendas registra padrões de objeção.
Experimento de precificação
Growth, finanças e produto testam empacotamento ou apresentação de preço com métricas de proteção de margem.
Experimento de onboarding
Produto e marketing de ciclo de vida testam se um caminho guiado para o primeiro valor melhora a ativação.
Experimento de canal
Growth testa uma nova fonte de aquisição em relação ao CAC downstream e à retenção.
É por isso que a experimentação não deve viver apenas dentro do CRO.
Construa uma cadência de experimentação
Semanal
- revise a saúde dos experimentos;
- resolva problemas de instrumentação;
- interrompa testes quebrados;
- documente comportamento inesperado.
Quinzenal ou mensal
- revise experimentos concluídos;
- selecione as próximas hipóteses;
- atualize o backlog com base no aprendizado.
Trimestral
- identifique as maiores incertezas estratégicas;
- avalie se o programa está testando perguntas significativas;
- aposente suposições obsoletas.
A cadência deve corresponder ao tráfego e à velocidade do negócio.
Erros comuns de experimentação
Testar sem uma hipótese
A equipe muda algo e espera que um número se mova.
Variáveis simultâneas demais
Ninguém sabe o que causou o resultado.
Sem métricas de proteção
A conversão melhora enquanto a qualidade cai.
Parar cedo
A equipe encerra um teste assim que um resultado desejado aparece.
Testar detalhes triviais
A incerteza estratégica de alta alavancagem permanece intocada.
Sem documentação
A organização reaprende repetidamente a mesma lição.
Escalar rápido demais
Um vencedor local é assumido como universalmente válido.
Checklist de GTM liderado por experimentação
Para cada grande iniciativa de GTM, pergunte:
- Quais suposições precisam ser verdadeiras?
- Qual suposição é a mais arriscada?
- Qual é o teste crível mais barato?
- Quais evidências já existem?
- Qual é a métrica primária?
- Quais são as métricas de proteção?
- Qual decisão o resultado mudará?
- Qual é a regra de parada?
- Onde o aprendizado será armazenado?
- O que deve ser revalidado em escala?
A experimentação não remove o julgamento. Ela melhora as evidências disponíveis para o julgamento.
Um sistema de GTM forte liderado por experimentação cria uma sequência:
observar → formular hipóteses → testar → aprender → decidir → escalar → observar novamente
As empresas que fazem isso bem não eliminam a incerteza. Elas transformam a incerteza em um processo operacional gerenciável.