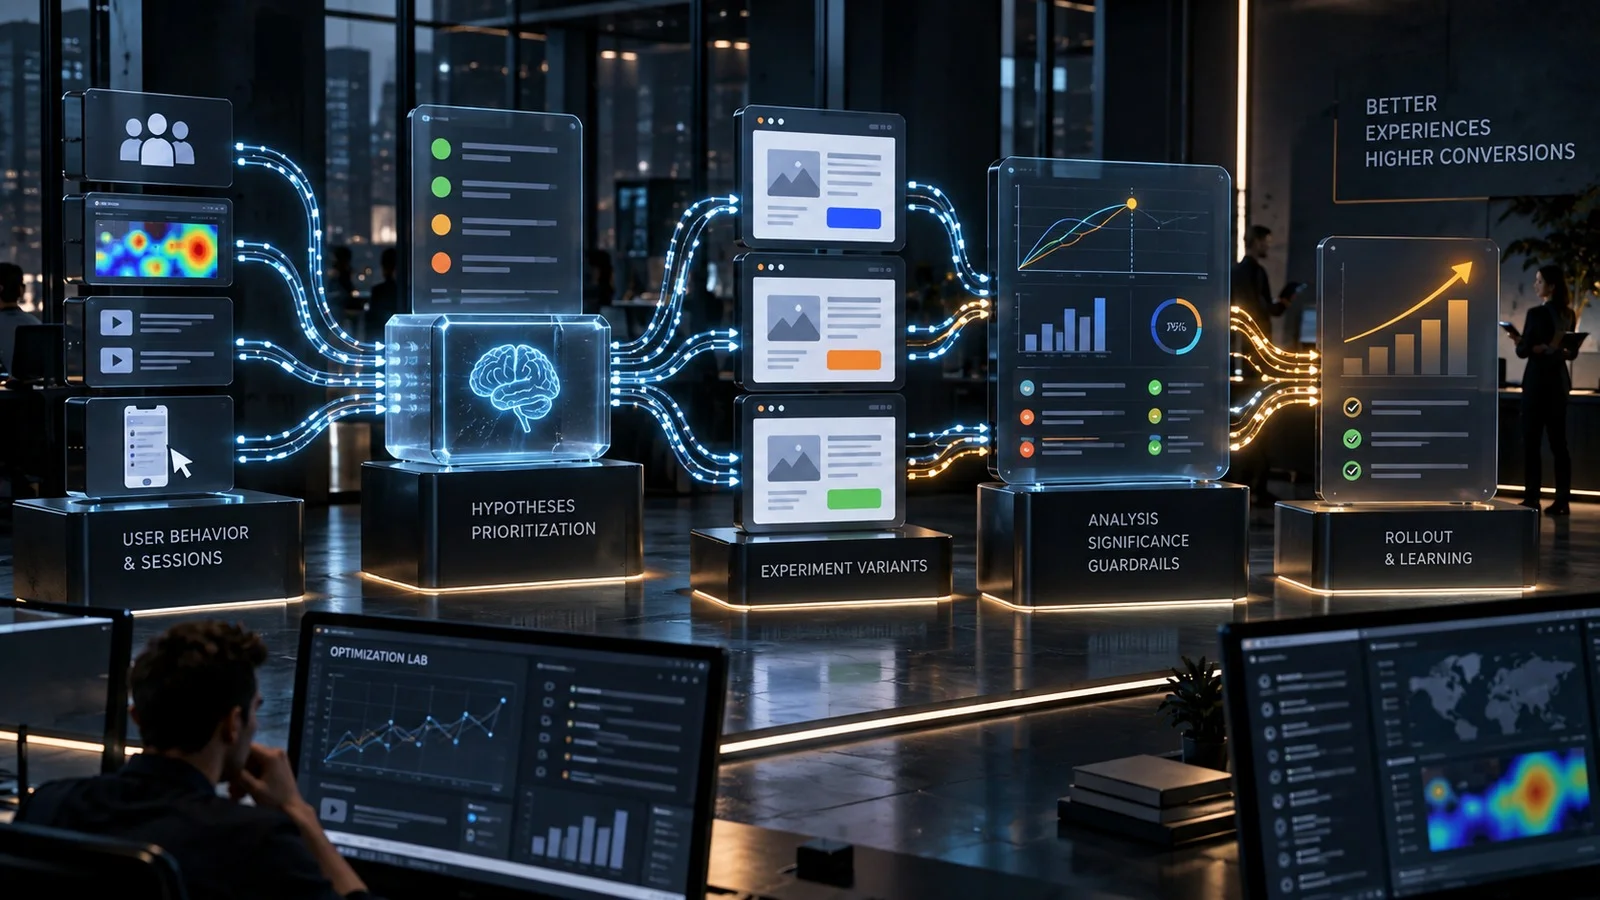
El go-to-market liderado por experimentación sustituye un gran plan de lanzamiento no probado por una secuencia de hipótesis explícitas.
La idea es simple: los mercados contienen incertidumbre. Audiencia, posicionamiento, canales, precios, creativos, onboarding y dinámica de ventas implican suposiciones. En lugar de tratar esas suposiciones como hechos, un equipo liderado por experimentación convierte las más importantes en pruebas.
El propósito no es ejecutar más pruebas A/B. Es construir un proceso repetible para aprender qué merece ser escalado.
Empiece por la suposición más arriesgada
Un plan de GTM contiene varias capas de riesgo:
- riesgo de mercado;
- riesgo de audiencia;
- riesgo de problema;
- riesgo de posicionamiento;
- riesgo de canal;
- riesgo de conversión;
- riesgo de retención;
- riesgo económico.
Los equipos con frecuencia prueban lo más fácil en lugar de lo de mayor consecuencia.
Cambiar el color de un botón es fácil. Probar si el equipo se está dirigiendo al comprador equivocado es más difícil y más importante.
Enumere las suposiciones detrás del plan y puntúelas por:
- impacto si está equivocada;
- incertidumbre;
- costo de aprender después.
Pruebe primero las suposiciones de mayor riesgo.
Escriba hipótesis que puedan fallar
Una hipótesis útil tiene:
- segmento objetivo;
- intervención;
- comportamiento esperado;
- resultado medible;
- horizonte temporal.
Ejemplo:
Para líderes de operaciones en empresas con 50–250 empleados, una landing page enfocada en reducir la conciliación manual generará al menos 20% más solicitudes calificadas de demostración que el mensaje de productividad existente durante cuatro semanas, sin reducir la calidad de las oportunidades.
Esto es más sólido que:
Probar nuevos mensajes.
La primera afirmación puede producir una decisión.
Construya una escalera de evidencia
No toda pregunta exige un experimento costoso.
Use primero el método creíble más barato.
Nivel 1: evidencia cualitativa
- entrevistas;
- conversaciones de soporte;
- llamadas de ventas;
- análisis de ganancias/pérdidas;
- consultas de búsqueda;
- debates en comunidades.
Útil para descubrir lenguaje, problemas y objeciones.
Nivel 2: evidencia conductual
- comportamiento en la landing page;
- eventos de producto;
- datos de CRM;
- análisis de cohortes;
- análisis de embudo.
Útil para identificar dónde el comportamiento diverge de las suposiciones.
Nivel 3: pruebas de humo
- listas de espera;
- pruebas de mensajes;
- páginas de prototipo;
- pruebas de demanda;
- campañas pagadas limitadas.
Útil antes de construir funcionalidades costosas o entrar en un nuevo segmento.
Nivel 4: experimentos controlados
- pruebas A/B;
- holdouts;
- pruebas aleatorizadas;
- experimentos geográficos.
Útil para estimar el impacto causal cuando existe volumen suficiente.
Nivel 5: validación a escala
La intervención se amplía y se monitorea en condiciones reales de operación.
Esta progresión evita la sobreingeniería en la validación inicial.
Priorice experimentos
Un backlog puede convertirse en otra forma de procrastinación.
Use un sistema de puntuación consistente.
Un modelo simple es:
prioridad = impacto × confianza ÷ esfuerzo
Otro puede incluir importancia estratégica y velocidad de aprendizaje.
La fórmula exacta importa menos que la comparación consistente.
Para cada experimento, documente:
- hipótesis;
- audiencia;
- responsable;
- métrica primaria;
- métricas de protección;
- duración esperada;
- esfuerzo de implementación;
- regla de decisión;
- dependencias.
Evite priorizar solo por facilidad.
Elija una métrica primaria
Un experimento debe tener una métrica primaria siempre que sea posible.
Ejemplos:
- conversión de demostraciones calificadas;
- finalización de checkout;
- tasa de activación;
- conversión a pago;
- ingresos retenidos.
Después, defina métricas de protección.
Ejemplo:
Primaria:
- conversión de prueba a pago.
Métricas de protección:
- tasa de reembolso;
- tickets de soporte;
- retención de 30 días.
Esto impide que el equipo declare una victoria en una métrica local mientras perjudica el sistema más amplio.
Use la analítica para orientar el experimento
La experimentación funciona mejor cuando parte de evidencia.
La analítica puede revelar:
- etapas de embudo con caída inusual;
- segmentos con comportamiento materialmente diferente;
- páginas con tráfico alto pero conversión débil;
- cohortes con mala retención;
- campañas con costo alto pero fuerte valor posterior.
Amplitude describe la experimentación como un proceso conectado a la analítica de comportamiento: use datos para identificar fricción, definir una hipótesis, ejecutar una prueba y luego analizar cómo las variantes afectan la jornada más amplia del usuario.
El principio importante no es la herramienta. Es la conexión entre observación y diseño de pruebas.
Alinee el diseño de la prueba con la decisión
No toda prueba debe ser una prueba A/B.
Prueba A/B
Úsela cuando:
- las variantes pueden asignarse aleatoriamente;
- el volumen es suficiente;
- el entorno es lo suficientemente estable;
- la intervención puede aislarse.
Despliegue secuencial
Úselo cuando el riesgo exija exposición gradual.
Experimento geográfico
Útil para efectos de medios u offline donde la aleatorización a nivel de usuario es difícil.
Holdout
Útil para estimar el impacto incremental.
Análisis antes/después
El más débil para la inferencia causal, pero a veces la única opción práctica. Úselo con cautela y considere la estacionalidad y otros cambios.
Validación cualitativa
Úsela antes de la prueba cuantitativa cuando el equipo todavía está tratando de entender el problema.
El método debe corresponder a la incertidumbre.
Defina una regla de decisión antes de ver el resultado
Los equipos son vulnerables a la interpretación motivada.
Antes del lanzamiento, escriba:
- efecto mínimo aceptable;
- umbral de confianza o evidencia;
- duración máxima;
- límites de protección;
- qué sucede si el resultado es positivo;
- qué sucede si es neutro;
- qué sucede si es negativo.
Ejemplo:
Si la conversión calificada mejora al menos 15% y la calidad de las oportunidades no cae más de 5%, lleve el mensaje al 100% del tráfico y pruebe el siguiente segmento. Si el efecto es inferior a 5%, deténgase. Si el resultado queda entre 5% y 15%, recoja otro ciclo, a menos que el costo supere el valor de aprendizaje.
Los umbrales exactos dependen del negocio.
La disciplina es lo que importa.
No se detenga en la significancia estadística
Un efecto estadísticamente detectable aún puede ser económicamente irrelevante.
Pregunte:
- ¿El efecto es lo suficientemente grande para importar?
- ¿Persiste en etapas posteriores?
- ¿Mejora la economía unitaria?
- ¿Funciona en el segmento prioritario?
- ¿El efecto justifica la complejidad de implementación?
- ¿Es probable que sobreviva a escala?
Un aumento de 1% en la conversión puede ser extremadamente valioso a gran escala y no tener sentido a pequeña escala.
El contexto de negocio determina la materialidad.
Trate los resultados negativos como útiles
Un resultado negativo puede eliminar una mala inversión.
Si un equipo descubre que un segmento no responde a una propuesta de valor presentada antes de pasar seis meses construyendo un paquete de producto dedicado, el experimento creó valor.
La meta no es una alta “tasa de victoria”.
Una tasa de victoria sospechosamente alta puede indicar:
- hipótesis débiles;
- reporte selectivo;
- pruebas demasiado pequeñas;
- criterios de éxito modificados después del lanzamiento.
Un programa saludable produce resultados positivos, negativos e inconclusos.
Almacene aprendizajes, no solo resultados
Una base de datos de experimentos debe capturar:
- hipótesis;
- contexto;
- capturas de pantalla o detalles de las variantes;
- audiencia;
- fechas;
- métricas;
- resultado;
- interpretación;
- decisión;
- pregunta de seguimiento.
Esto evita que los equipos repitan pruebas antiguas y crea memoria institucional.
Etiquete los aprendizajes por:
- audiencia;
- problema;
- mensaje;
- canal;
- etapa del embudo;
- área de producto.
Con el tiempo, la biblioteca de experimentos se convierte en un activo estratégico.
Escale a los ganadores con cuidado
Una prueba exitosa en un contexto puede fallar a mayor escala.
Los motivos incluyen:
- expansión de audiencia;
- fatiga creativa;
- saturación de canal;
- capacidad operativa;
- restricciones de seguimiento de ventas;
- geografías diferentes;
- dispositivos diferentes;
- efectos de novedad.
Escale por etapas.
Para un experimento de adquisición paga:
- valide el mensaje;
- valide la landing page;
- valide la conversión calificada;
- aumente el presupuesto;
- monitoree el CAC marginal;
- verifique la retención o la calidad de los ingresos.
Escalar es otro experimento.
Conecte la experimentación con el sistema de GTM
Los experimentos de mayor valor a menudo cruzan fronteras de equipos.
Ejemplos:
Experimento de audiencia
Marketing y ventas prueban si un ICP más restringido mejora la calidad del pipeline.
Experimento de posicionamiento
Marketing prueba dos formulaciones del problema mientras ventas registra patrones de objeción.
Experimento de precios
Growth, finanzas y producto prueban el empaquetado o la presentación del precio con métricas de protección de margen.
Experimento de onboarding
Producto y marketing de ciclo de vida prueban si un camino guiado hacia el primer valor mejora la activación.
Experimento de canal
Growth prueba una nueva fuente de adquisición frente al CAC posterior y la retención.
Por eso la experimentación no debe vivir solo dentro del CRO.
Construya una cadencia de experimentación
Semanal
- revise la salud de los experimentos;
- resuelva problemas de instrumentación;
- detenga pruebas defectuosas;
- documente comportamiento inesperado.
Quincenal o mensual
- revise los experimentos concluidos;
- seleccione las próximas hipótesis;
- actualice el backlog con base en el aprendizaje.
Trimestral
- identifique las mayores incertidumbres estratégicas;
- evalúe si el programa está probando preguntas significativas;
- retire suposiciones obsoletas.
La cadencia debe corresponder al tráfico y a la velocidad del negocio.
Errores comunes de experimentación
Probar sin una hipótesis
El equipo cambia algo y espera que un número se mueva.
Demasiadas variables simultáneas
Nadie sabe qué causó el resultado.
Sin métricas de protección
La conversión mejora mientras la calidad cae.
Parar temprano
El equipo termina una prueba tan pronto como aparece un resultado deseado.
Probar detalles triviales
La incertidumbre estratégica de alto apalancamiento permanece intacta.
Sin documentación
La organización reaprende repetidamente la misma lección.
Escalar demasiado rápido
Se asume que un ganador local es universalmente válido.
Lista de verificación de GTM liderado por experimentación
Para cada gran iniciativa de GTM, pregunte:
- ¿Qué suposiciones deben ser verdaderas?
- ¿Cuál es la suposición más arriesgada?
- ¿Cuál es la prueba creíble más barata?
- ¿Qué evidencia ya existe?
- ¿Cuál es la métrica primaria?
- ¿Cuáles son las métricas de protección?
- ¿Qué decisión cambiará el resultado?
- ¿Cuál es la regla de parada?
- ¿Dónde se almacenará el aprendizaje?
- ¿Qué debe revalidarse a escala?
La experimentación no elimina el juicio. Mejora la evidencia disponible para el juicio.
Un sistema de GTM sólido liderado por experimentación crea una secuencia:
observar → formular hipótesis → probar → aprender → decidir → escalar → observar de nuevo
Las empresas que hacen esto bien no eliminan la incertidumbre. Transforman la incertidumbre en un proceso operativo gestionable.