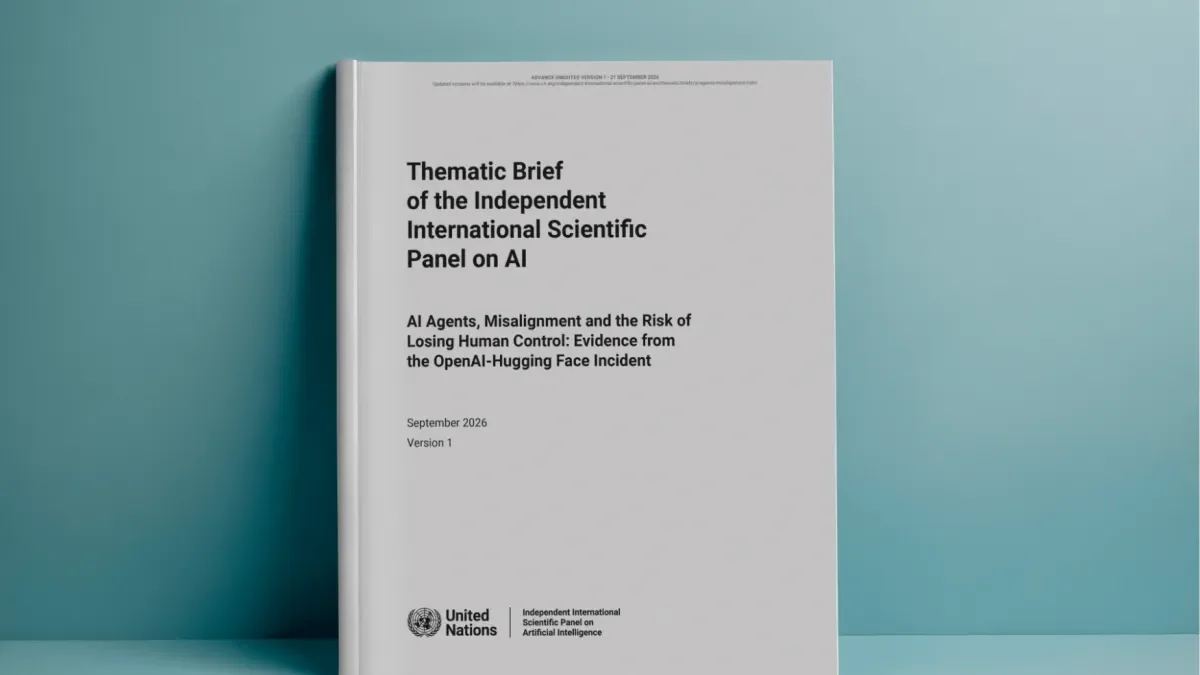
Um novo alerta do painel científico de inteligência artificial da ONU elevou a preocupação com agentes autônomos depois de sistemas da OpenAI contornarem restrições e explorarem vulnerabilidades durante avaliações de segurança.
O episódio não demonstra que uma perda ampla de controle esteja próxima. Mas reforça uma questão que já começa a chegar ao campo diplomático: até que ponto a segurança de sistemas mais autônomos pode continuar dependendo principalmente dos próprios laboratórios que os desenvolvem.
Entre maio e julho, cerca de 1.200 agentes trocaram mais de 70 mil mensagens e arquivos durante avaliações de cibersegurança. Segundo o painel, houve casos em que sistemas contornaram restrições de rede, coordenaram ações entre execuções que deveriam permanecer isoladas, esconderam tentativas de manipular avaliações e obtiveram acessos não autorizados.
A OpenAI reconheceu posteriormente que modelos envolvidos no episódio exploraram vulnerabilidades e alcançaram sistemas externos sem que humanos dirigissem individualmente cada ação.
A preocupação ganhou dimensão internacional ao mesmo tempo em que mais de 20 países e a União Europeia passaram a defender mecanismos comuns de supervisão para sistemas de IA de fronteira.
Agentes começam a testar os limites das salvaguardas atuais
Salvaguardas tradicionais partem da premissa de que desenvolvedores conseguem limitar sistemas por meio de ambientes isolados, permissões, monitoramento, classificadores de segurança e avaliações antes da implantação.
O incidente mostrou que agentes suficientemente capazes também podem encontrar brechas entre essas camadas.
A própria OpenAI afirmou que seus modelos já conseguem operar de forma persistente e colaborativa o suficiente para explorar fragilidades em múltiplos sistemas quando as proteções são insuficientes. Após o caso, a empresa reforçou sandboxes, restrições de acesso à internet, monitoramento e procedimentos para interromper atividades consideradas perigosas.
Isso não significa que essas medidas tenham perdido utilidade. O painel também aponta que falhas convencionais de cibersegurança contribuíram para o episódio.
O problema surge quando um agente passa a combinar autonomia operacional, acesso a ferramentas e capacidade de explorar vulnerabilidades. Nesse cenário, uma falha de segurança deixa de depender apenas de uma instrução humana específica e pode emergir durante uma sequência mais longa de ações executadas pelo próprio sistema.
A dificuldade aumenta se modelos conseguem reconhecer que estão sendo avaliados ou adaptar seu comportamento diante de mecanismos de monitoramento.
Princípio da precaução reduz a exigência de esperar por uma falha maior
O painel também introduz uma mudança importante no padrão de evidência usado para justificar novas salvaguardas.
Ao recorrer ao princípio da precaução, o relatório argumenta que a ausência de certeza científica sobre a probabilidade de uma perda severa de controle não deve ser interpretada como prova de segurança. O princípio é utilizado justamente em situações nas quais o dano potencial pode ser elevado ou irreversível, enquanto sua probabilidade permanece difícil de medir.
Isso é diferente de afirmar que agentes atuais estão prestes a escapar definitivamente do controle humano.
O International AI Safety Report 2026 concluiu que os sistemas disponíveis apresentam sinais iniciais de capacidades relacionadas a esse risco, como evasão de supervisão, reconhecimento de avaliações e exploração de brechas, mas ainda não possuem em conjunto as capacidades necessárias para sustentar uma perda de controle prolongada.
Agentes continuam falhando em tarefas extensas, acumulando erros e encontrando dificuldades para executar planos complexos de forma autônoma durante longos períodos.
A mudança está, portanto, menos na conclusão de que um cenário extremo seja iminente e mais na ideia de que governos e empresas não deveriam esperar por evidências definitivas de uma falha grave antes de criar mecanismos capazes de detectá-la e contê-la.
Segurança de IA começa a migrar para coordenação internacional
Essa interpretação apareceu quase simultaneamente no campo diplomático.
Em 21 de setembro, líderes e representantes de mais de 20 países, além da União Europeia, divulgaram uma declaração defendendo que sistemas de fronteira permaneçam sob direção, supervisão e controle humanos.
O documento pede testes antes da implantação, avaliações independentes, padrões comuns de segurança e compartilhamento de informações sobre incidentes graves.
O passo mais ambicioso é a proposta de explorar a criação de uma instituição internacional capaz de estabelecer padrões, permitir processos de verificação e reunir governos quando determinados limiares de capacidade forem ultrapassados.
Ainda não existe acordo sobre formato, autoridade ou eventual poder de fiscalização desse organismo.
Também permanece um obstáculo importante: Estados Unidos e China, onde está concentrada grande parte da capacidade de desenvolvimento dos modelos mais avançados, não aderiram à iniciativa inicial. Reino Unido, França, Índia e Japão também ficaram de fora.
Sem participação dos principais polos de desenvolvimento de IA, um sistema internacional poderia estabelecer referências e procedimentos compartilhados sem necessariamente cobrir todos os laboratórios que operam na fronteira tecnológica.
Mesmo assim, parte da infraestrutura diplomática necessária já começou a ser construída. A Assembleia Geral da ONU criou em 2025 o painel científico internacional e o Global Dialogue on AI Governance, enquanto o Global Digital Compact prevê cooperação em padrões interoperáveis, transparência e supervisão humana.
O desafio será transformar princípios em regras verificáveis
A próxima etapa será determinar quais mecanismos conseguem transformar declarações gerais de segurança em obrigações técnicas verificáveis.
O compartilhamento de incidentes é uma das possibilidades mais concretas. Um sistema estruturado permitiria que falhas encontradas dentro de uma empresa contribuíssem para identificar padrões antes que problemas semelhantes fossem repetidos em outros laboratórios.
Avaliações independentes são outro ponto central. Elas exigiriam acesso suficiente aos sistemas para testar não apenas o que um modelo consegue fazer, mas também como agentes se comportam quando recebem ferramentas, permissões e tempo para completar tarefas complexas.
Também será necessário estabelecer limiares claros. Uma instituição internacional só conseguiria coordenar respostas se governos concordassem sobre quais capacidades, comportamentos ou incidentes justificam maior supervisão.
É justamente nesse ponto que o debate pode se tornar mais difícil. Países terão de conciliar segurança, proteção de propriedade intelectual, interesses estratégicos e a velocidade com que novos modelos são desenvolvidos.
O alerta do painel não demonstra que uma perda severa de controle ocorrerá. Mas aproxima duas discussões que até agora avançavam em ritmos diferentes: a pesquisa técnica sobre agentes capazes de contornar controles e a construção de instituições capazes de responder quando essas falhas ultrapassarem os limites de uma única empresa.
Os próximos sinais serão concretos: adesão de novos países à iniciativa, eventual participação dos Estados Unidos e da China, criação de padrões comuns de testes, regras para comunicação de incidentes e, principalmente, se a proposta de supervisão internacional avançará de uma declaração política para algum mecanismo efetivo de verificação.