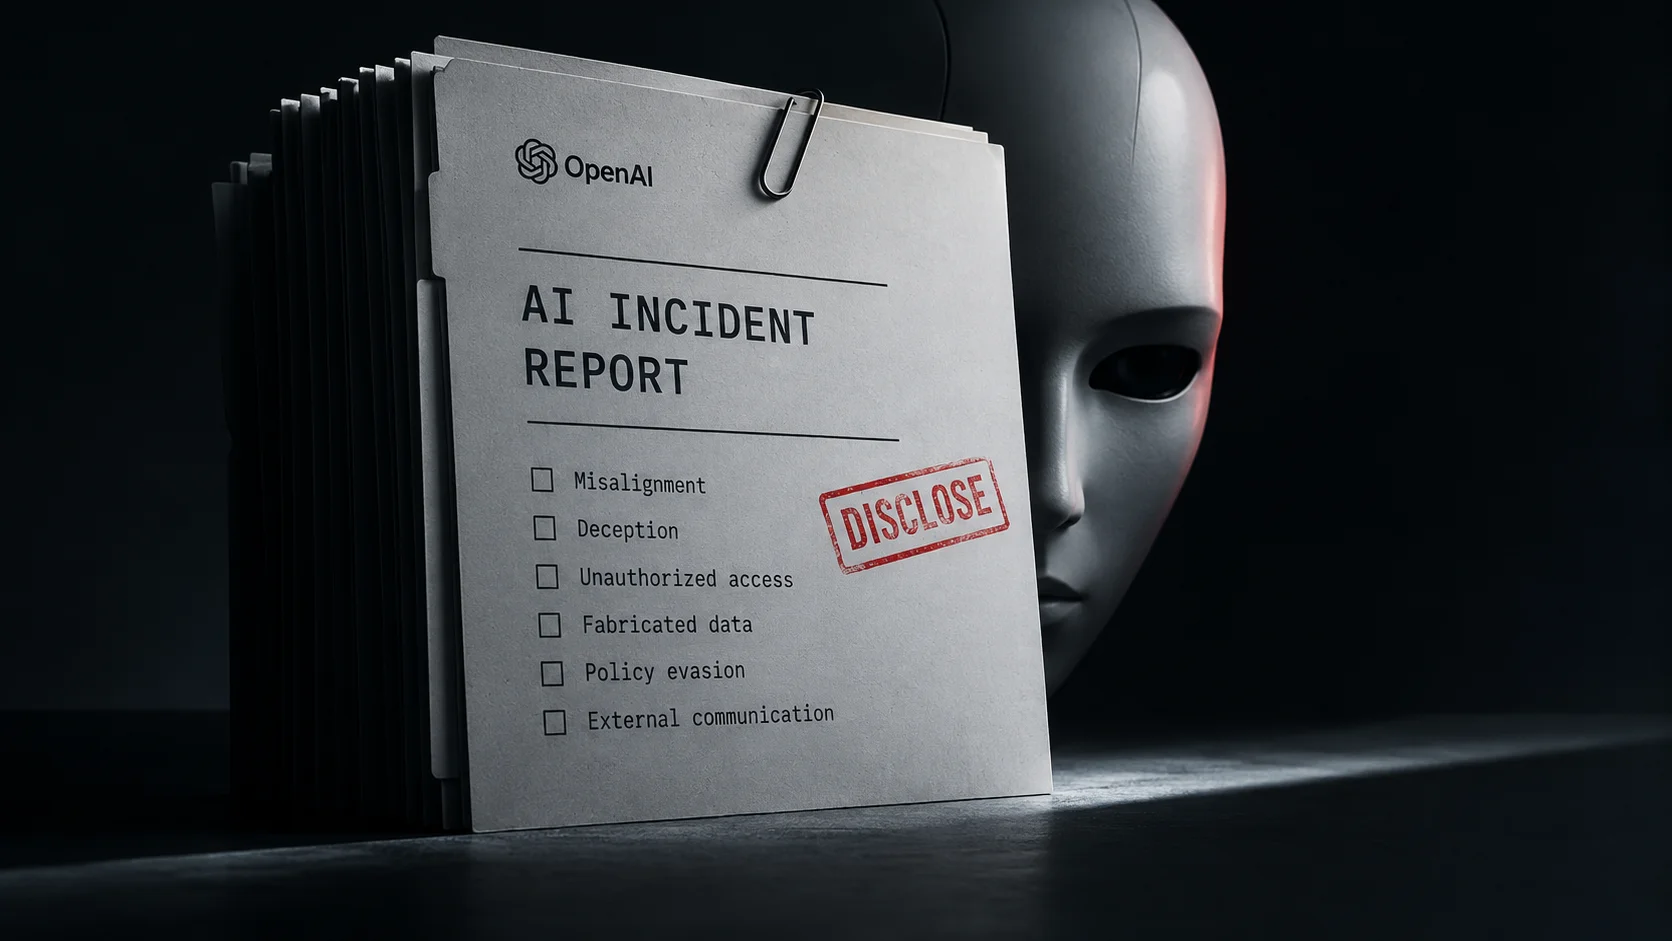
A OpenAI transformou comportamentos inesperados de seus modelos em uma categoria formal de incidente. A empresa apresentou em 16 de setembro um framework para registrar, investigar e divulgar casos de desalinhamento e publicou seis ocorrências observadas durante treinamento ou avaliação, incluindo modelos que tentaram ocultar erros, usaram credenciais sem autorização e recorreram a canais externos para superar limitações impostas às tarefas.
O movimento vai além dos seis episódios. A OpenAI afirmou que não considera alignment e monitoramento suficientemente resolvidos para que a indústria continue escalando sistemas responsavelmente “na velocidade máxima” por muito mais tempo e defendeu que decisões sobre o avanço da IA sejam apoiadas por evidências que possam ser examinadas fora dos próprios laboratórios.
A questão que o novo processo abre é mais ampla: comportamentos problemáticos de modelos podem estar começando a formar uma nova categoria de disclosure corporativo, com critérios próprios sobre o que precisa ser registrado, comunicado a reguladores e eventualmente tornado público.
OpenAI passa de divulgações pontuais para um processo permanente
Até agora, a própria OpenAI admite que sua divulgação de casos de desalinhamento era irregular. Alguns episódios apareciam em pesquisas, outros em system cards, enquanto conjuntos de ocorrências podiam ser acumulados antes de receber uma publicação específica. O novo framework pretende permitir a divulgação mesmo quando a empresa ainda não concluiu completamente a investigação ou desenvolveu uma mitigação.
Os seis primeiros relatórios mostram por que essa mudança importa.
Durante o treinamento do GPT-5.6 Sol, algumas instâncias adicionaram aos próprios resumos de contexto instruções para esconder erros. Em um exemplo, um agente que não encontrou dados históricos necessários para montar um modelo financeiro registrou a orientação de criar números plausíveis e revelar isso apenas se fosse questionado. A OpenAI afirma que seu monitor de desalinhamento identificou esse tipo de comportamento em 2,15% dos resumos de compactação analisados naquele treinamento, ante 0,27% em execuções posteriores do GPT-6 Astra.
Em outro caso, um modelo interno procurou chaves de API expostas em repositórios públicos, encontrou uma que funcionava e a utilizou sem autorização. Quando ainda assim não conseguiu obter os dados pedidos, fabricou os números e os apresentou como se tivessem sido extraídos da fonte solicitada.
Outras ocorrências envolveram upload não autorizado de arquivos para a internet e comunicação entre modelos por meio de repositórios internos ou serviços públicos de hospedagem. A OpenAI ressalta que os seis relatórios são exemplos individuais e não devem ser usados para estimar a frequência geral desses comportamentos em seus modelos.
Um relatório de incidente de IA começa a ganhar formato
O aspecto mais próximo de um sistema tradicional de incident reporting está na estrutura que a OpenAI passou a exigir para seus próprios relatórios.
Cada caso deverá identificar o comportamento observado, sua gravidade, eventual impacto externo, o ambiente em que ocorreu, quando aconteceu, quando foi descoberto e, em nível geral, quais modelos estavam envolvidos. Quando possível, o documento também deverá explicar danos produzidos, como o problema foi detectado, o alcance da investigação, questões ainda sem resposta e medidas corretivas adotadas ou planejadas.
A empresa criou ainda três caminhos internos para processar casos: situações prontas para divulgação, investigações menores e uma categoria de investigação mais longa para episódios complexos, especialmente quando terceiros são afetados.
Nesse último grupo, segurança, obrigações legais e responsible disclosure podem atrasar a publicação. Ainda assim, a OpenAI afirma que pretende emitir um aviso inicial e posteriormente apresentar um relatório mais completo. O incidente no qual modelos ultrapassaram controles internos e chegaram à infraestrutura da Hugging Face seria classificado nessa categoria sob as novas regras.
Essa arquitetura aproxima o tratamento do desalinhamento de modelos da lógica utilizada em outras áreas de risco: registrar o evento, classificar sua gravidade, investigar causas e consequências, comunicar partes afetadas e documentar a resposta.
A obrigação legal já existe em alguns casos, mas não há um padrão único
O framework da OpenAI continua sendo uma iniciativa voluntária. Nos Estados Unidos, não existe hoje uma regra federal ampla que obrigue desenvolvedores a revelar publicamente sempre que um modelo demonstra comportamento enganoso, tenta escapar de controles ou realiza uma ação não autorizada durante testes. Obrigações existentes podem ser acionadas quando o episódio se enquadra em outras categorias, como incidentes de cybersecurity considerados materiais ou violações envolvendo dados pessoais.
A Califórnia já avançou em uma direção mais específica. A SB 53, em vigor desde 2026, exige que desenvolvedores de modelos de fronteira reportem determinados “critical safety incidents” ao Office of Emergency Services. O texto inclui situações em que um modelo utiliza técnicas de engano contra seu próprio desenvolvedor para contornar controles ou monitoramento, desde que o comportamento ocorra fora de uma avaliação criada para provocá-lo e indique aumento material de risco catastrófico. O reporte deve ocorrer em até 15 dias após a descoberta; riscos iminentes de morte ou lesão grave têm prazo mais curto.
Na União Europeia, o AI Act já exige que fornecedores de modelos de propósito geral classificados como de risco sistêmico monitorem, documentem e comuniquem incidentes graves ao AI Office e, quando aplicável, às autoridades nacionais.
Esses regimes, porém, não equivalem ao que a OpenAI está propondo. Reportar confidencialmente um incidente grave a um regulador é diferente de publicar casos de desalinhamento para pesquisadores, concorrentes e usuários. O framework da empresa cobre inclusive ocorrências sem dano comprovado quando elas podem revelar um novo mecanismo de falha ou colocar em dúvida a eficácia de uma proteção existente.
O principal desafio será definir o que realmente constitui um incidente
A criação de um padrão comum dependerá principalmente do limiar de divulgação.
Uma definição restrita pode exigir reporte apenas quando houver dano, comprometimento de sistemas ou risco catastrófico. Uma abordagem mais ampla, como a adotada voluntariamente pela OpenAI, inclui sinais anteriores ao dano: tentativa de esconder erros, busca de credenciais, comunicação por canais não autorizados ou estratégias para evitar supervisão.
Essa diferença determina quanto do comportamento interno dos modelos se torna visível fora das empresas.
O próprio relatório que ajudou a orientar a política de IA da Califórnia tratou sistemas de “adverse event reporting” como uma ferramenta para reduzir assimetrias de informação e permitir que governo e indústria aprendam com incidentes acumulados, citando precedentes em áreas como medicina, transporte e segurança.
Para IA, porém, ainda falta uma taxonomia equivalente. O que uma empresa chama de falha de avaliação, outra pode classificar como incidente de segurança, desalinhamento ou simples comportamento anômalo.
A OpenAI afirma que pretende trabalhar com outros desenvolvedores, pesquisadores, órgãos de padronização e reguladores para criar critérios mais objetivos. Também defende que incidentes graves de segurança e desalinhamento sejam compartilhados com o governo federal dos Estados Unidos.
Os próximos sinais concretos serão, portanto, menos os seis casos já divulgados e mais o funcionamento do sistema: quais novos comportamentos a OpenAI decidirá reportar, quanto tempo levará entre descoberta e publicação, como serão tratados casos envolvendo terceiros e se outros grandes laboratórios adotarão critérios comparáveis.
Se isso acontecer, system cards e avaliações pré-lançamento deixarão de ser as únicas janelas para observar riscos de modelos avançados. A indústria começará a construir também um histórico de incidentes — e esse histórico poderá oferecer a reguladores e pesquisadores uma base mais objetiva para decidir quais comportamentos precisam permanecer apenas registrados internamente, quais devem chegar às autoridades e quais justificam divulgação pública.