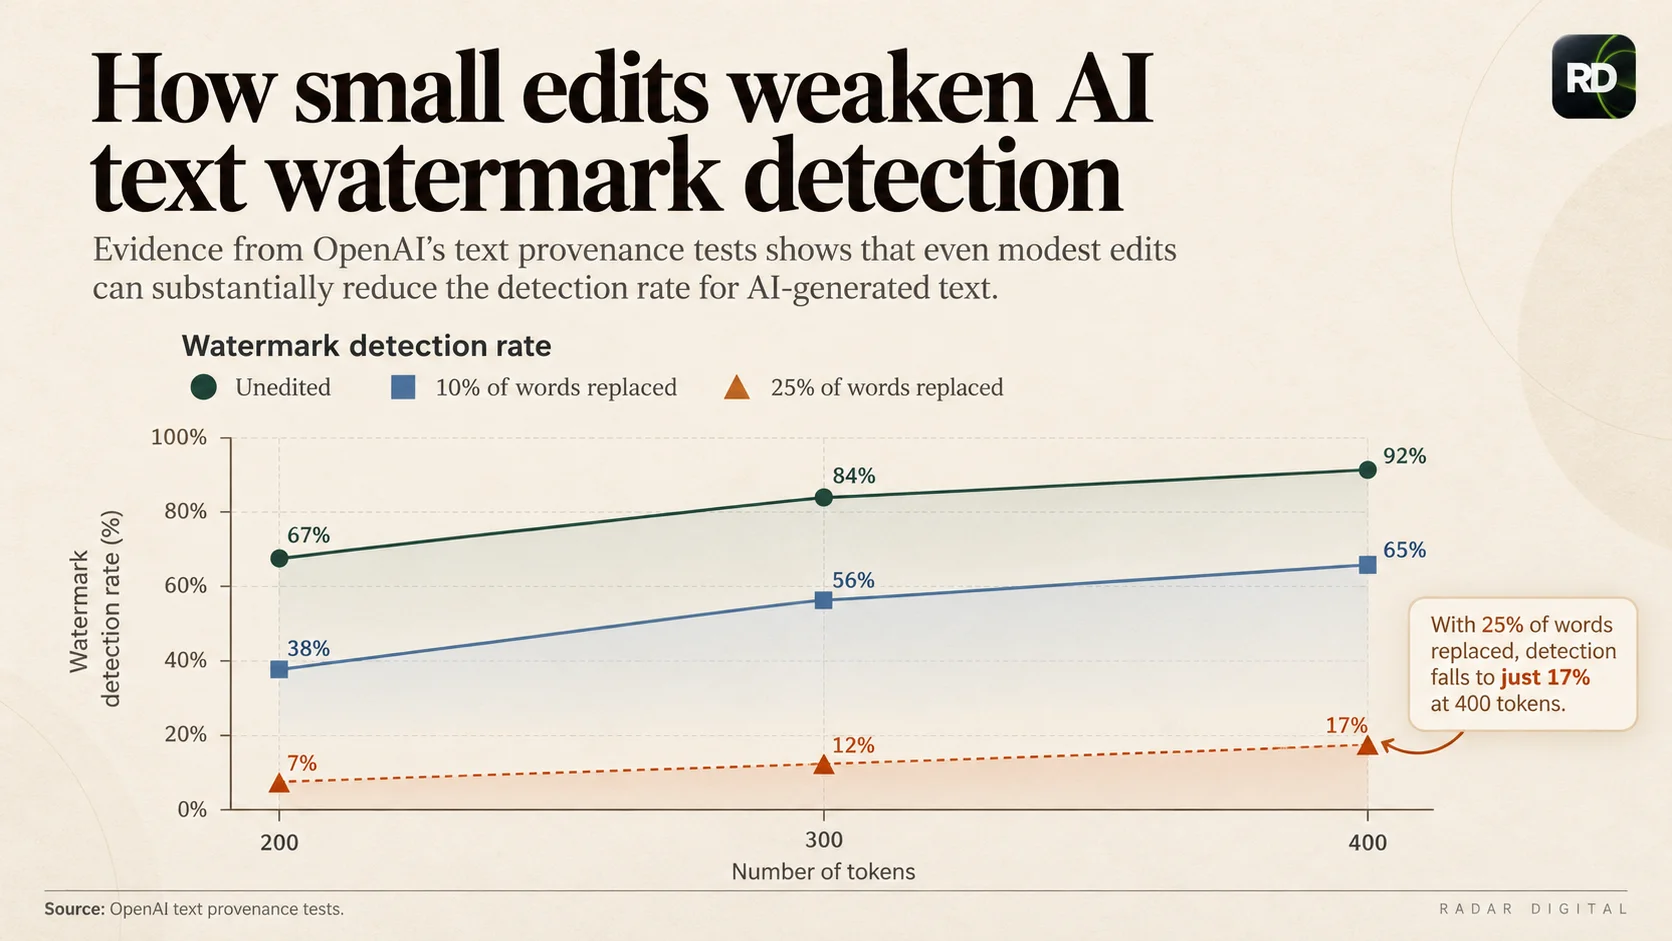
OpenAI comenzará a insertar una marca invisible en textos elegibles de ChatGPT y Codex en la Unión Europea, transformando la exigencia de transparencia del AI Act en una de las mayores pruebas prácticas ya realizadas con watermarking de texto. El problema aparece en los propios números de la empresa: alterar solo el 10% de las palabras ya reduce de cerca del 92% al 66% la capacidad de detectar la marca. Con el 25% del texto modificado, la tasa cae al 17%.
El contraste no significa que OpenAI esté necesariamente ofreciendo una solución incapaz de cumplir la legislación. La norma europea contiene una salvedad importante: los sistemas de marcado deben ser eficaces, interoperables, robustos y confiables en la medida en que ello sea técnicamente viable, considerando las limitaciones del contenido y el estado del arte.
La cuestión pasa a ser menos si el watermark logra identificar todo texto generado por IA y más qué nivel de confiabilidad será suficiente para caracterizar la conformidad regulatoria cuando la propia señal puede desaparecer tras alteraciones relativamente pequeñas.
Europa exige identificación, pero no una prueba infalible
Desde el 2 de agosto, el artículo 50 del AI Act exige que los proveedores de sistemas capaces de generar texto, imagen, audio o video adopten mecanismos que permitan identificar contenido artificial en formato legible por máquinas.
Es exactamente esa capa la que OpenAI intenta atender con textGrain, tecnología que modifica estadísticamente las elecciones de palabras hechas por el modelo sin insertar caracteres ocultos ni marcas visibles.
La distinción importa porque la legislación reconoce las limitaciones técnicas del proceso. No existe en el texto legal una exigencia de que cualquier contenido generado siga siendo detectable después de cualquier transformación posible.
Esto impide una lectura simple de que las pruebas de OpenAI demuestran una incompatibilidad directa entre la tecnología y la ley. Demuestran, sin embargo, que la conformidad regulatoria y la identificación confiable del origen de un texto son problemas diferentes.
Un proveedor puede implementar un mecanismo técnicamente adecuado en el momento de la generación y aun así ser incapaz de recuperar la señal después de que el texto circula, se resume, se traduce o se reescribe.
Poca edición ya debilita drásticamente la señal
Es en ese punto donde los números divulgados por la propia OpenAI se vuelven relevantes.
En pasajes de aproximadamente 400 tokens, la empresa afirma detectar cerca del 92% de los textos marcados en determinada configuración de prueba. La sustitución del 10% de las palabras por sinónimos reduce el resultado al 66%. Con el 25% de las palabras sustituidas, solo el 17% sigue siendo detectado.
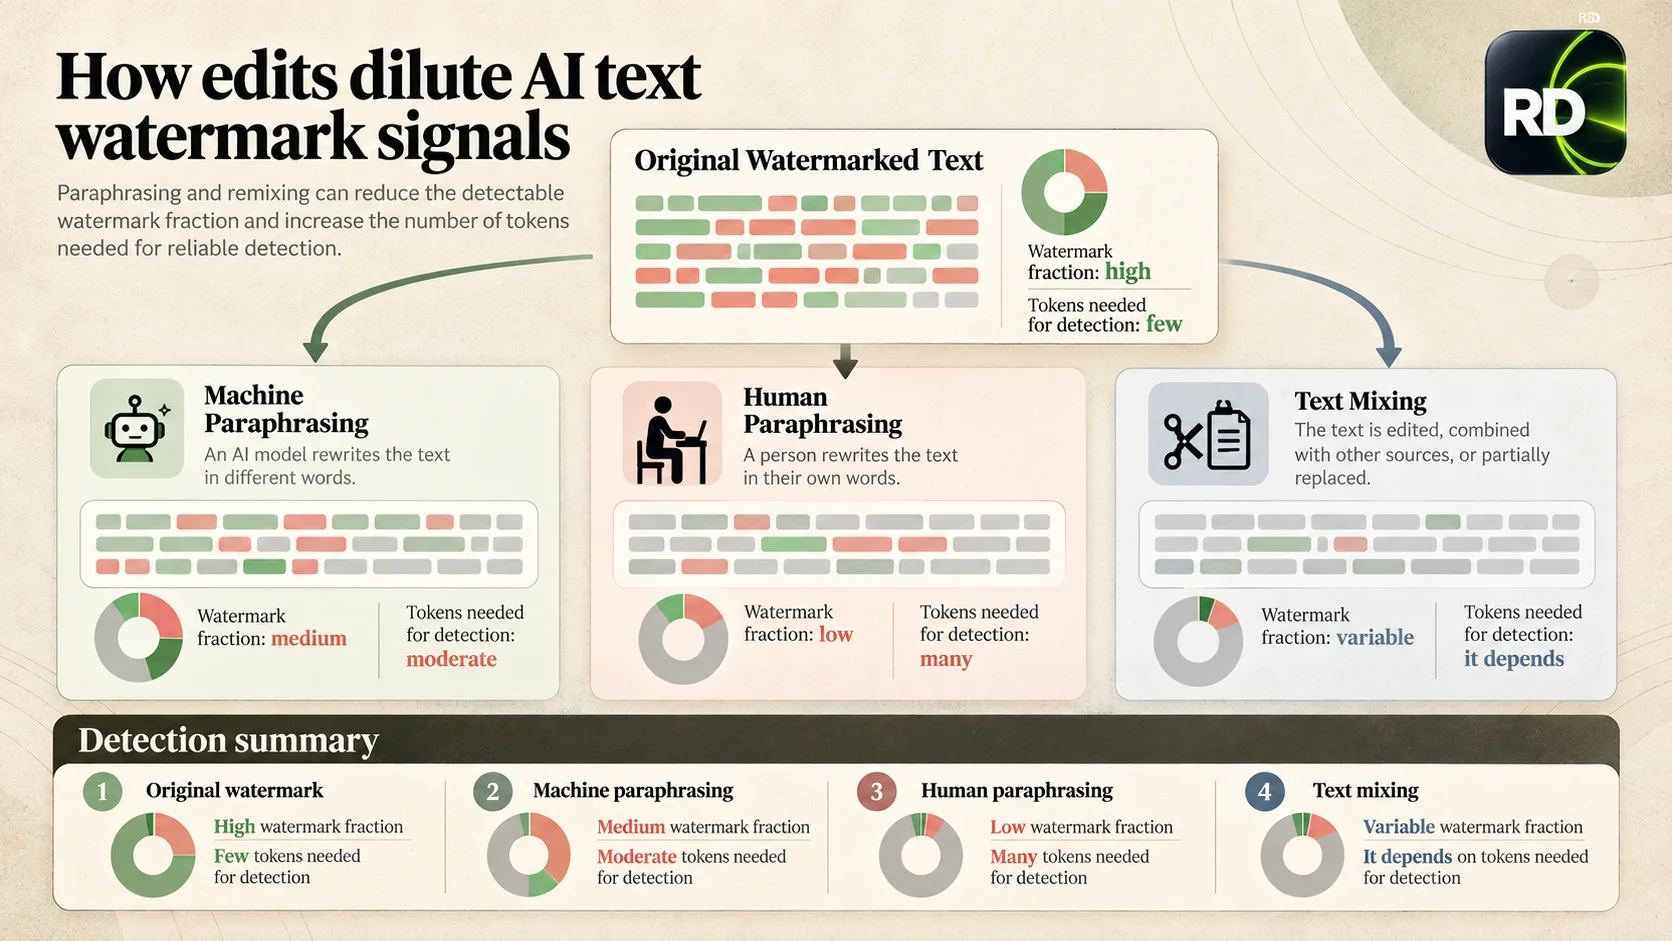
El mecanismo explica la fragilidad. textGrain depende de patrones estadísticos distribuidos por las elecciones lingüísticas del modelo. Reescribir el texto significa sustituir justamente parte de los elementos que portan ese patrón.
Esto crea una limitación particularmente importante para el texto porque la edición no es un escenario excepcional. Las revisiones humanas, las herramientas gramaticales, la traducción, el resumen y la reformulación forman parte del ciclo normal de producción y distribución de contenido.
La dificultad aumenta en textos cortos o en contenidos en los que el modelo tiene menos libertad de elección. En las pruebas divulgadas por OpenAI, aproximadamente el 80% de los textos de 200 tokens fueron identificados, frente a cerca del 95% entre pasajes de 400 tokens, considerando una tasa objetivo de falsos positivos del 1%.
Los contenidos matemáticos también presentaron resultados inferiores a los de textos con mayor flexibilidad lingüística. Cuanto menor es el espacio de elecciones posibles para el modelo, menor tiende a ser el espacio disponible para insertar una señal estadística robusta.
El mismo watermark no funciona igual en todos los idiomas
Hay además una dificultad específicamente europea: el idioma.
En pruebas realizadas por OpenAI en los 24 idiomas oficiales de la Unión Europea, la detección inicial varió del 69% en español al 42,2% en rumano, considerando nuevamente una tasa objetivo de falsos positivos del 1%.
La empresa afirma que consigue reforzar la señal en idiomas que presentan un desempeño menor. Pero la diferencia entre los resultados revela otro obstáculo para una implementación regulatoria a escala continental.
El mismo mecanismo no produce necesariamente la misma confiabilidad en todo el mercado europeo.
Esto importa porque la obligación regulatoria es común, mientras que las propiedades estadísticas de los idiomas no lo son. Una tecnología considerada suficientemente eficaz en inglés o español puede exigir ajustes adicionales para alcanzar un desempeño similar en otras lenguas.
En la práctica, evaluar la conformidad podrá depender no solo de la existencia de un watermark, sino también de la forma en que funciona en diferentes idiomas, longitudes de texto y tipos de contenido.
Un watermark detectado no equivale a probar la autoría
OpenAI también evita presentar su detector como una prueba definitiva de contenido artificial.
La presencia de la marca puede indicar que un sistema de OpenAI generó o procesó parte del texto, pero no determina cuánto trabajo humano se realizó posteriormente, quién escribió o publicó el material, quién posee los derechos sobre él o si el contenido es verdadero.
Lo inverso es aún más importante: no encontrar el watermark no permite concluir que un texto fue escrito por una persona.
El contenido puede haber sido editado, traducido, reducido, reescrito por otro modelo, producido antes de la implementación de la tecnología o simplemente ser demasiado corto para portar una señal estadística suficientemente fuerte.
Esa limitación ayuda a explicar por qué el detector no se pondrá a disposición del público de inmediato. OpenAI pretende restringir el acceso inicial a investigadores y organizaciones especializadas.
La elección reduce el riesgo de que una herramienta probabilística se convierta en un veredicto automático sobre la autoría, especialmente en entornos como escuelas, universidades, empresas o procesos jurídicos.
El watermarking logra producir evidencia sobre la procedencia. Por sí solo, no logra reconstruir toda la historia de creación de un texto.
La procedencia tiende a funcionar como señal, no como veredicto
El diseño europeo también apunta en esa dirección.
Además de la obligación técnica impuesta a los proveedores, el AI Act establece reglas específicas para quienes publican textos generados o manipulados por IA sobre asuntos de interés público. Esa exigencia tiene una excepción cuando existe revisión humana, control editorial y una persona física o jurídica asume la responsabilidad por el contenido.
Esto crea dos capas distintas. Una intenta preservar técnicamente una señal sobre el origen del material. La otra determina quién asume la responsabilidad por su publicación.
El watermark no sustituye esa segunda capa. La propia OpenAI afirma que las marcas invisibles y los sistemas de procedencia no eliminan eventuales obligaciones de divulgación visible.
La consecuencia es que la procedencia del texto tiende a funcionar mejor como evidencia complementaria que como mecanismo aislado para decidir si determinado contenido provino o no de IA.
Ese modelo ya aparece en otras estrategias de procedencia. Para las imágenes, por ejemplo, las empresas pueden combinar credenciales de contenido, metadatos y señales técnicas porque cualquier mecanismo individual puede desaparecer durante la edición, la conversión o la publicación en determinadas plataformas.
En el texto, el problema es aún más difícil. Copiar, resumir, traducir y reescribir no son ataques sofisticados contra el sistema. Son operaciones comunes.
El problema regulatorio pasa a ser definir qué es lo suficientemente confiable
Es justamente ahí donde la implementación de OpenAI puede cobrar importancia más allá de los propios productos de la empresa.
El AI Act no exige una tecnología perfecta. Condiciona requisitos como la robustez y la confiabilidad a lo que sea técnicamente viable y al estado del arte disponible.
Esto protege a la regulación de una exigencia imposible, pero también abre una cuestión práctica: ¿Qué desempeño se considerará suficiente para que una empresa demuestre que realmente tomó medidas eficaces de identificación?
Una tasa alta en textos intactos puede ser suficiente para demostrar que el sistema inserta una señal detectable. Pero no resuelve necesariamente el problema que motivó la regla si esa señal desaparece durante usos comunes del contenido.
Por otro lado, exigir que un watermark sobreviva a cualquier forma de transformación también sería técnicamente difícil y podría producir otros problemas, como falsos positivos o interferencia excesiva en la generación del texto.
La discusión regulatoria tiende, por lo tanto, a desplazarse de la existencia del mecanismo a su desempeño concreto.
Las tasas de falsos positivos, la resistencia a la edición, las diferencias entre idiomas, la longitud mínima necesaria y el comportamiento tras la traducción o el procesamiento por otros modelos pueden convertirse en criterios más relevantes que simplemente preguntar si determinado sistema posee o no un watermark.
La prueba decisiva comienza después del lanzamiento
Los próximos indicadores relevantes no vendrán solo de benchmarks controlados.
La implementación en ChatGPT y Codex permitirá observar cómo se comporta textGrain cuando los textos pasan por editores, traductores, herramientas de resumen, modelos competidores y procesos de revisión humana.
También será importante seguir cómo interpretarán las autoridades europeas el requisito de soluciones robustas y confiables en la medida en que sean técnicamente viables. La Comisión considera el Código de Práctica sobre transparencia una herramienta para ayudar a las empresas a demostrar conformidad, pero la adhesión al código no representa, por sí sola, prueba definitiva de cumplimiento de la legislación.
Otra señal importante será la reacción de los competidores. Si diferentes proveedores adoptan sistemas incompatibles de identificación, la interoperabilidad exigida por el régimen europeo podría convertirse en un problema adicional. Si los estándares compartidos avanzan, la procedencia podría evolucionar de soluciones propietarias a una infraestructura más amplia de identificación.
La experiencia de OpenAI coloca, por lo tanto, un límite concreto sobre la discusión regulatoria. Europa ya consigue exigir que los grandes modelos dejen señales técnicas de su participación en la creación de un texto. Sin embargo, aún no existe evidencia de que esas señales logren sobrevivir de forma confiable al ciclo normal de edición y circulación del lenguaje.
El éxito de esa política dependerá menos de transformar el watermarking en una prueba absoluta de autoría y más de definir cuándo una señal imperfecta sigue siendo lo suficientemente robusta para ser útil, auditable y jurídicamente relevante.
Herramientas mencionadas
Sigue en Radar
Amazon pone US$ 1 mil millones donde construye centros de datos: la carrera de la IA ahora depende también de la licencia social
Auditoría de 50 PB de OpenAI expone nuevo estándar de seguridad para agentes autónomos
Manus capta más de US$ 500 millones después de que China bloqueara la venta a Meta por US$ 2 mil millones