A OpenAI começará a inserir uma marca invisível em textos elegíveis do ChatGPT e do Codex na União Europeia, transformando a exigência de transparência do AI Act em um dos maiores testes práticos já feitos com watermarking de texto. O problema aparece nos próprios números da empresa: alterar apenas 10% das palavras já reduz de cerca de 92% para 66% a capacidade de detectar a marca. Com 25% do texto modificado, a taxa cai para 17%.
O contraste não significa que a OpenAI esteja necessariamente oferecendo uma solução incapaz de cumprir a legislação. A regra europeia contém uma ressalva importante: os sistemas de marcação devem ser eficazes, interoperáveis, robustos e confiáveis na medida em que isso seja tecnicamente viável, considerando as limitações do conteúdo e o estado da arte.
A questão passa a ser menos se o watermark consegue identificar todo texto gerado por IA e mais qual nível de confiabilidade será suficiente para caracterizar conformidade regulatória quando o próprio sinal pode desaparecer após alterações relativamente pequenas.
A Europa exige identificação, mas não uma prova infalível
Desde 2 de agosto, o artigo 50 do AI Act exige que provedores de sistemas capazes de gerar texto, imagem, áudio ou vídeo adotem mecanismos que permitam identificar conteúdo artificial em formato legível por máquinas.
É exatamente essa camada que a OpenAI tenta atender com o textGrain, tecnologia que modifica estatisticamente as escolhas de palavras feitas pelo modelo sem inserir caracteres ocultos ou marcas visíveis.
A distinção importa porque a legislação reconhece as limitações técnicas do processo. Não existe no texto legal uma exigência de que qualquer conteúdo gerado continue detectável depois de qualquer transformação possível.
Isso impede uma leitura simples de que os testes da OpenAI demonstram uma incompatibilidade direta entre a tecnologia e a lei. Eles demonstram, porém, que conformidade regulatória e identificação confiável da origem de um texto são problemas diferentes.
Um provedor pode implementar um mecanismo tecnicamente adequado no momento da geração e ainda assim ser incapaz de recuperar o sinal depois que o texto circula, é resumido, traduzido ou reescrito.
Pouca edição já enfraquece drasticamente o sinal
É nesse ponto que os números divulgados pela própria OpenAI se tornam relevantes.
Em passagens de aproximadamente 400 tokens, a empresa afirma detectar cerca de 92% dos textos marcados em determinada configuração de teste. A substituição de 10% das palavras por sinônimos reduz o resultado para 66%. Com 25% das palavras substituídas, apenas 17% continuam sendo detectados.
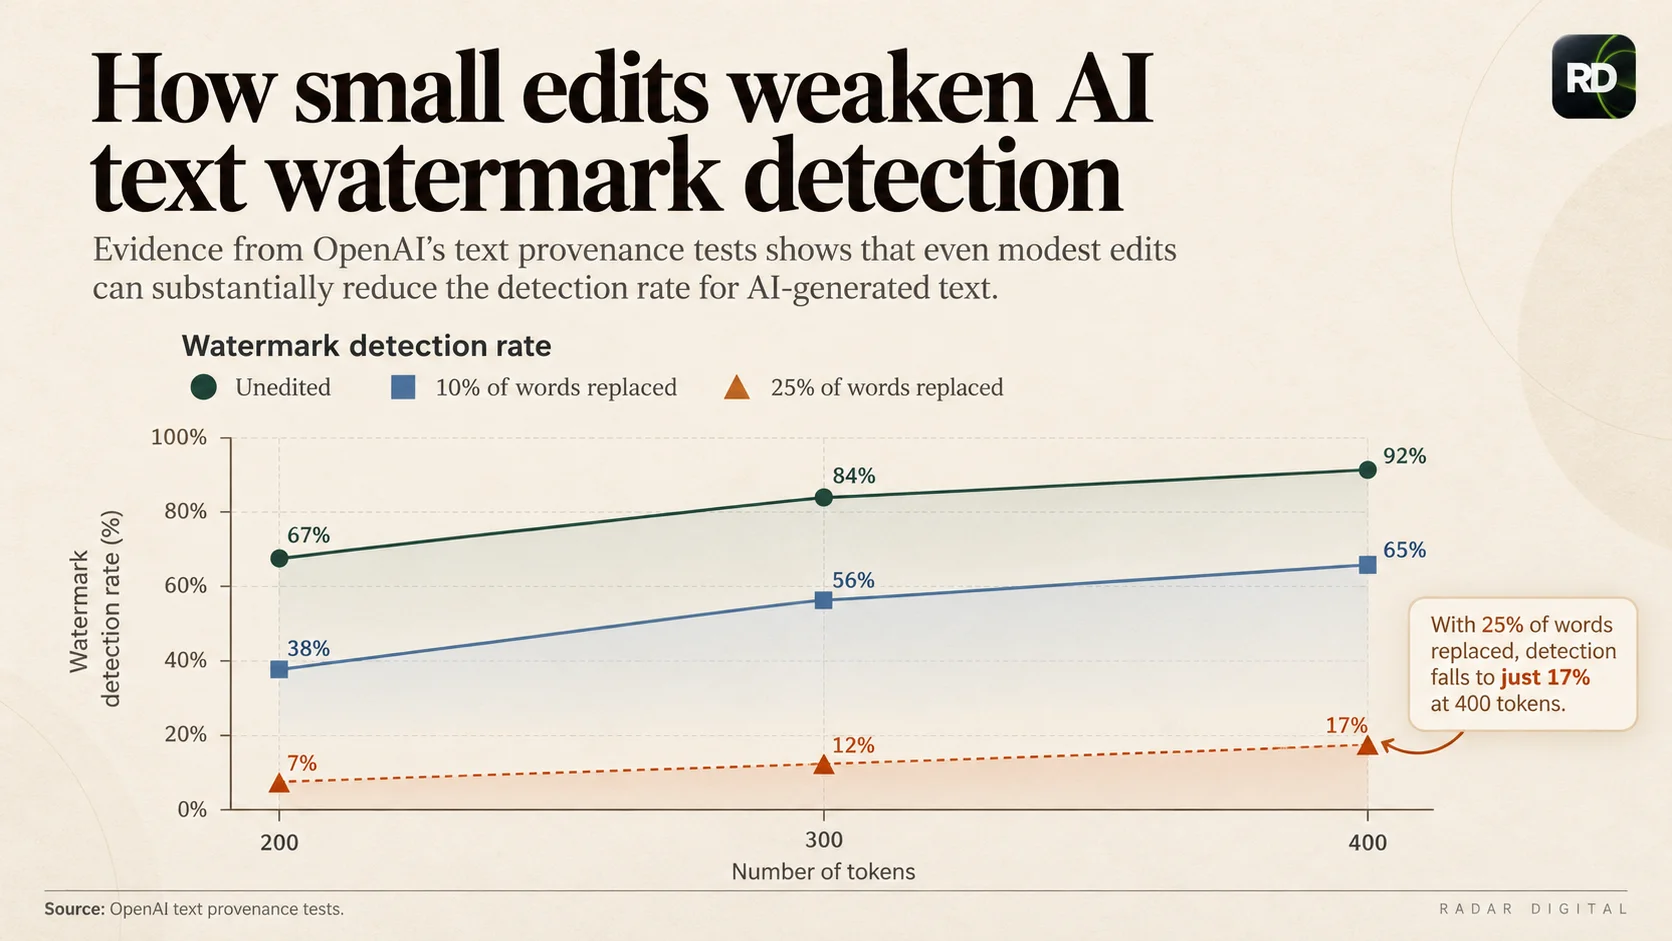
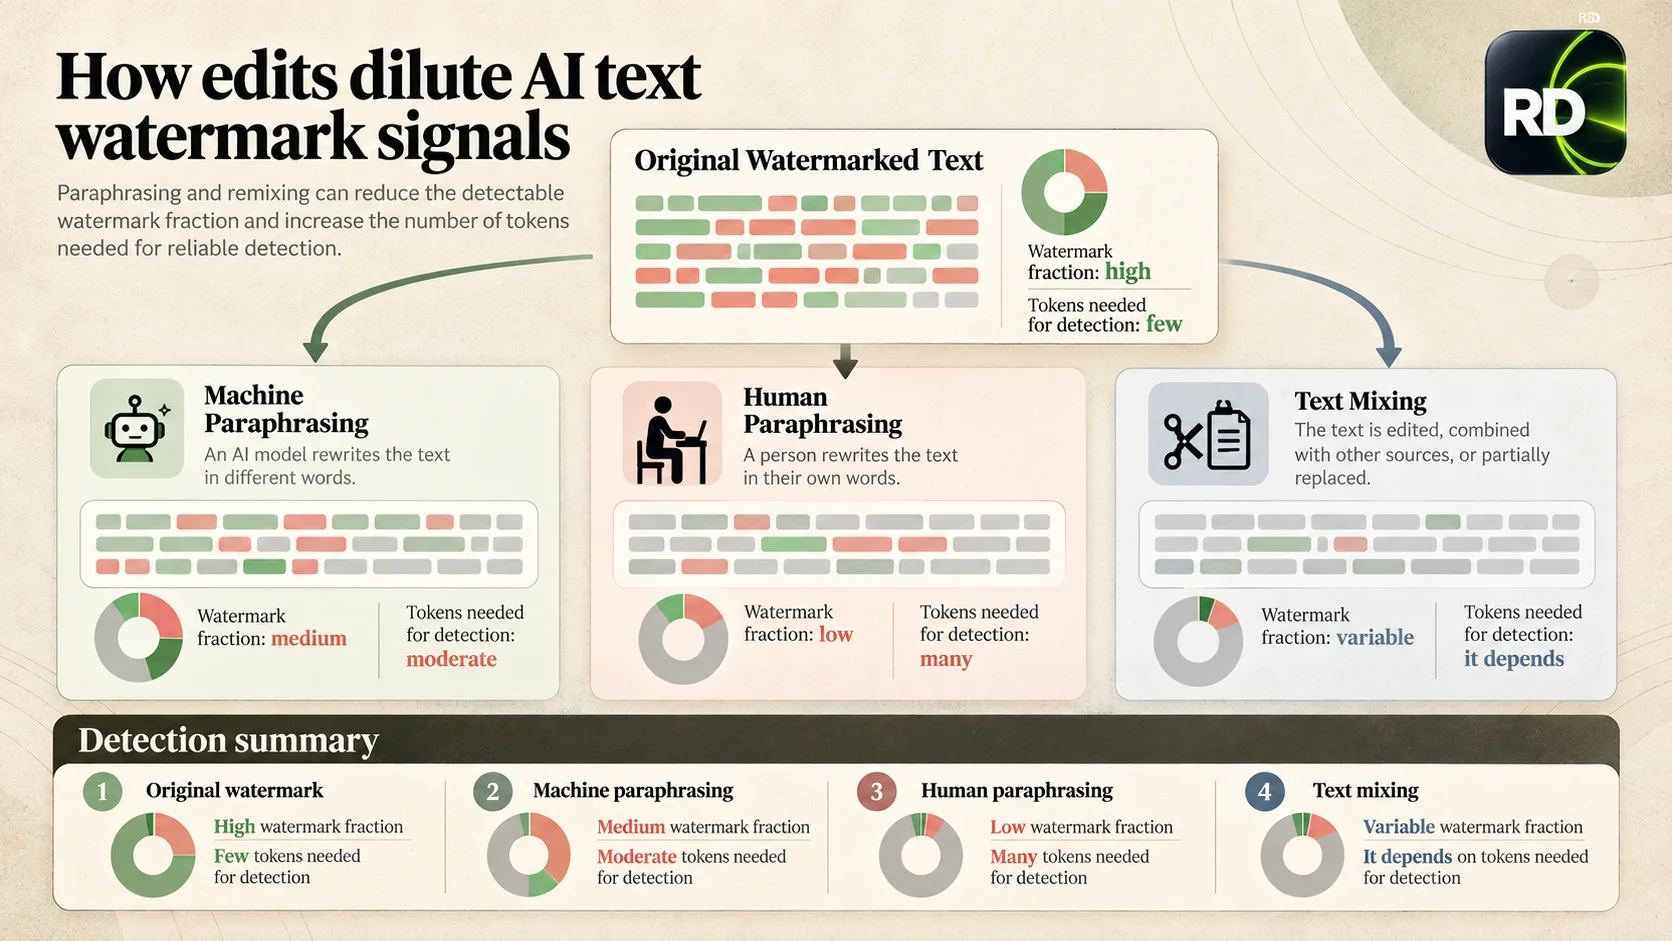
O mecanismo explica a fragilidade. O textGrain depende de padrões estatísticos distribuídos pelas escolhas linguísticas do modelo. Reescrever o texto significa substituir justamente parte dos elementos que carregam esse padrão.
Isso cria uma limitação particularmente importante para texto porque edição não é um cenário excepcional. Revisões humanas, ferramentas gramaticais, tradução, resumo e reformulação fazem parte do ciclo normal de produção e distribuição de conteúdo.
A dificuldade aumenta em textos curtos ou em conteúdos nos quais o modelo possui menos liberdade de escolha. Nos testes divulgados pela OpenAI, aproximadamente 80% dos textos de 200 tokens foram identificados, contra cerca de 95% entre passagens de 400 tokens, considerando uma taxa alvo de falso positivo de 1%.
Conteúdos matemáticos também apresentaram resultados inferiores aos de textos com maior flexibilidade linguística. Quanto menor o espaço de escolhas possíveis para o modelo, menor tende a ser o espaço disponível para inserir um sinal estatístico robusto.
O mesmo watermark não funciona igualmente em todos os idiomas
Há ainda uma dificuldade especificamente europeia: idioma.
Em testes realizados pela OpenAI nos 24 idiomas oficiais da União Europeia, a detecção inicial variou de 69% em espanhol a 42,2% em romeno, considerando novamente uma taxa alvo de falso positivo de 1%.
A empresa afirma que consegue reforçar o sinal em idiomas que apresentam desempenho menor. Mas a diferença entre os resultados revela outro obstáculo para uma implantação regulatória em escala continental.
O mesmo mecanismo não produz necessariamente a mesma confiabilidade em todo o mercado europeu.
Isso importa porque a obrigação regulatória é comum, enquanto as propriedades estatísticas dos idiomas não são. Uma tecnologia considerada suficientemente eficaz em inglês ou espanhol pode exigir ajustes adicionais para alcançar desempenho semelhante em outras línguas.
Na prática, avaliar conformidade poderá depender não apenas da existência de um watermark, mas também da forma como ele funciona em diferentes idiomas, comprimentos de texto e tipos de conteúdo.
Um watermark detectado não equivale a provar autoria
A OpenAI também evita apresentar seu detector como um teste definitivo de conteúdo artificial.
A presença da marca pode indicar que um sistema da OpenAI gerou ou processou parte do texto, mas não determina quanto trabalho humano foi realizado posteriormente, quem escreveu ou publicou o material, quem possui os direitos sobre ele ou se o conteúdo é verdadeiro.
O inverso é ainda mais importante: não encontrar o watermark não permite concluir que um texto foi escrito por uma pessoa.
O conteúdo pode ter sido editado, traduzido, reduzido, reescrito por outro modelo, produzido antes da implementação da tecnologia ou simplesmente ser curto demais para carregar um sinal estatístico suficientemente forte.
Essa limitação ajuda a explicar por que o detector não será disponibilizado imediatamente ao público. A OpenAI pretende restringir o acesso inicial a pesquisadores e organizações especializadas.
A escolha reduz o risco de que uma ferramenta probabilística seja transformada em um veredito automático sobre autoria, especialmente em ambientes como escolas, universidades, empresas ou processos jurídicos.
Watermarking consegue produzir evidência sobre proveniência. Ele não consegue, sozinho, reconstruir toda a história de criação de um texto.
Proveniência tende a funcionar como sinal, não como veredito
O desenho europeu também aponta nessa direção.
Além da obrigação técnica imposta aos provedores, o AI Act estabelece regras específicas para quem publica textos gerados ou manipulados por IA sobre assuntos de interesse público. Essa exigência possui exceção quando existe revisão humana, controle editorial e uma pessoa física ou jurídica assume responsabilidade pelo conteúdo.
Isso cria duas camadas distintas. Uma tenta preservar tecnicamente um sinal sobre a origem do material. A outra determina quem assume responsabilidade pela sua publicação.
O watermark não substitui essa segunda camada. A própria OpenAI afirma que marcas invisíveis e sistemas de proveniência não eliminam eventuais obrigações de divulgação visível.
A consequência é que a proveniência de texto tende a funcionar melhor como evidência complementar do que como mecanismo isolado para decidir se determinado conteúdo veio ou não de IA.
Esse modelo já aparece em outras estratégias de proveniência. Para imagens, por exemplo, empresas podem combinar credenciais de conteúdo, metadados e sinais técnicos porque qualquer mecanismo individual pode desaparecer durante edição, conversão ou publicação em determinadas plataformas.
No texto, o problema é ainda mais difícil. Copiar, resumir, traduzir e reescrever não são ataques sofisticados contra o sistema. São operações comuns.
O problema regulatório passa a ser definir o que é confiável o suficiente
É justamente aí que a implantação da OpenAI pode ganhar importância além dos próprios produtos da empresa.
O AI Act não exige uma tecnologia perfeita. Ele condiciona requisitos como robustez e confiabilidade ao que for tecnicamente viável e ao estado da arte disponível.
Isso protege a regulamentação de uma exigência impossível, mas também abre uma questão prática: qual desempenho será considerado suficiente para que uma empresa demonstre que realmente tomou medidas eficazes de identificação?
Uma taxa alta em textos intactos pode ser suficiente para demonstrar que o sistema insere um sinal detectável. Mas ela não resolve necessariamente o problema que motivou a regra se esse sinal desaparecer durante usos comuns do conteúdo.
Por outro lado, exigir que um watermark sobreviva a qualquer forma de transformação também seria tecnicamente difícil e poderia produzir outros problemas, como falsos positivos ou interferência excessiva na geração do texto.
A discussão regulatória tende, portanto, a se deslocar da existência do mecanismo para seu desempenho concreto.
Taxas de falso positivo, resistência à edição, diferenças entre idiomas, comprimento mínimo necessário e comportamento após tradução ou processamento por outros modelos podem se tornar critérios mais relevantes do que simplesmente perguntar se determinado sistema possui ou não um watermark.
O teste decisivo começa depois do lançamento
Os próximos indicadores relevantes não virão apenas de benchmarks controlados.
A implantação no ChatGPT e no Codex permitirá observar como o textGrain se comporta quando textos passam por editores, tradutores, ferramentas de resumo, modelos concorrentes e processos de revisão humana.
Também será importante acompanhar como autoridades europeias interpretarão o requisito de soluções robustas e confiáveis na medida em que sejam tecnicamente viáveis. A Comissão considera o Código de Prática sobre transparência uma ferramenta para auxiliar empresas a demonstrar conformidade, mas adesão ao código não representa, por si só, prova definitiva de cumprimento da legislação.
Outro sinal importante será a reação dos concorrentes. Se diferentes provedores adotarem sistemas incompatíveis de identificação, a interoperabilidade exigida pelo regime europeu poderá se tornar um problema adicional. Caso padrões compartilhados avancem, a proveniência poderá evoluir de soluções proprietárias para uma infraestrutura mais ampla de identificação.
A experiência da OpenAI coloca, portanto, um limite concreto sobre a discussão regulatória. A Europa já consegue exigir que grandes modelos deixem sinais técnicos de sua participação na criação de um texto. Ainda não existe, porém, evidência de que esses sinais consigam sobreviver de forma confiável ao ciclo normal de edição e circulação da linguagem.
O sucesso dessa política dependerá menos de transformar watermarking em uma prova absoluta de autoria e mais de definir quando um sinal imperfeito ainda é robusto o suficiente para ser útil, auditável e juridicamente relevante.