Google presentó el 30 de septiembre Gemini 4 Argon, su nuevo modelo de frontera, después de meses en los que la empresa dejó de lanzar Gemini 3.5 Pro mientras OpenAI y Anthropic renovaban sus modelos más avanzados. Argon llega con resultados competitivos en trabajo profesional, programación y seguridad, además de un límite anunciado de 1 millón de tokens de salida. Pero la característica más relevante del lanzamiento no radica en saber si Google ganó más líneas en una tabla de benchmarks.
La cuestión es otra: ¿Hasta dónde un modelo puede permanecer trabajando solo en una tarea larga, usando herramientas, consultando grandes volúmenes de información, corrigiendo sus propios pasos y llegando a un resultado verificable?
Es en ese punto donde Argon ofrece la señal más interesante. Google está tratando de transformar la capacidad de razonamiento prolongado en una característica comercial del modelo. Si ese rendimiento se sostiene fuera de las pruebas, la competencia entre los principales laboratorios pasa a depender cada vez menos de la calidad de una única respuesta y más del costo, la confiabilidad y la duración de procesos completos ejecutados por agentes.
El resultado más importante no está en el marcador de Google
El material de lanzamiento sitúa a Argon por delante de sus competidores en varias pruebas, pero las comparaciones producidas por el propio desarrollador deben tratarse con cuidado. Distintos modelos pueden usar herramientas, niveles de esfuerzo y estructuras de ejecución diferentes, y pequeñas diferencias de puntuación no siempre representan ventajas perceptibles en producción.
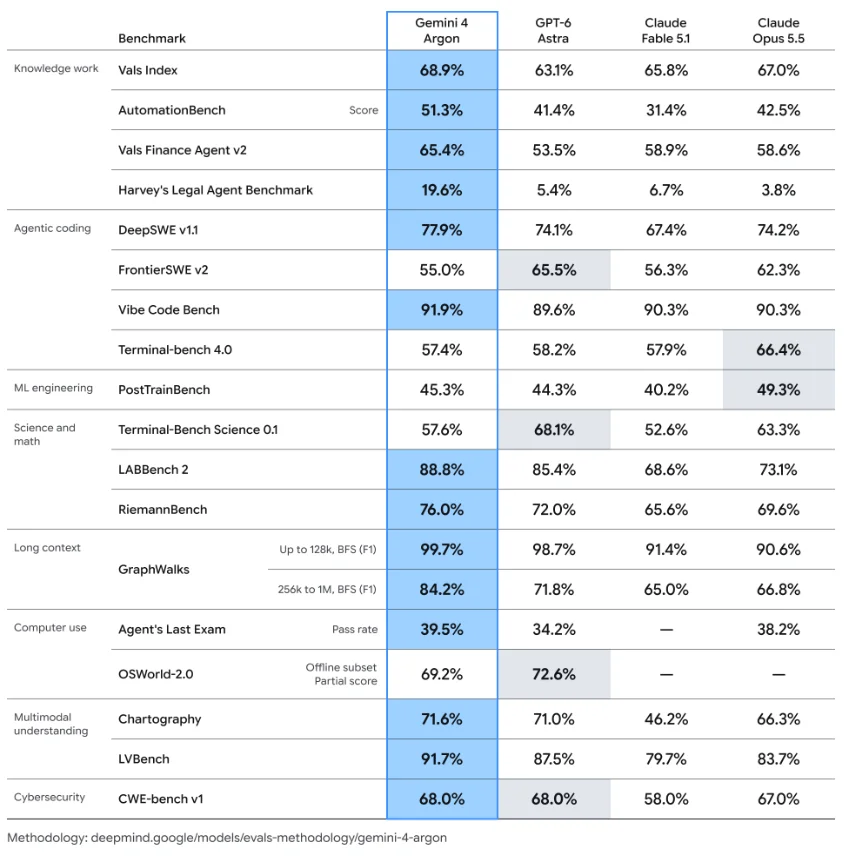
Vals AI evaluó Argon en su propia suite y colocó el modelo en la primera posición del Vals Index, con 68,9%, frente a 67,04% de Claude Sonnet 5.5 y 66,97% de Claude Opus 5.5. El índice combina tareas de finanzas, programación, derecho y tributación e intenta acercar la prueba al trabajo profesional con valor económico.
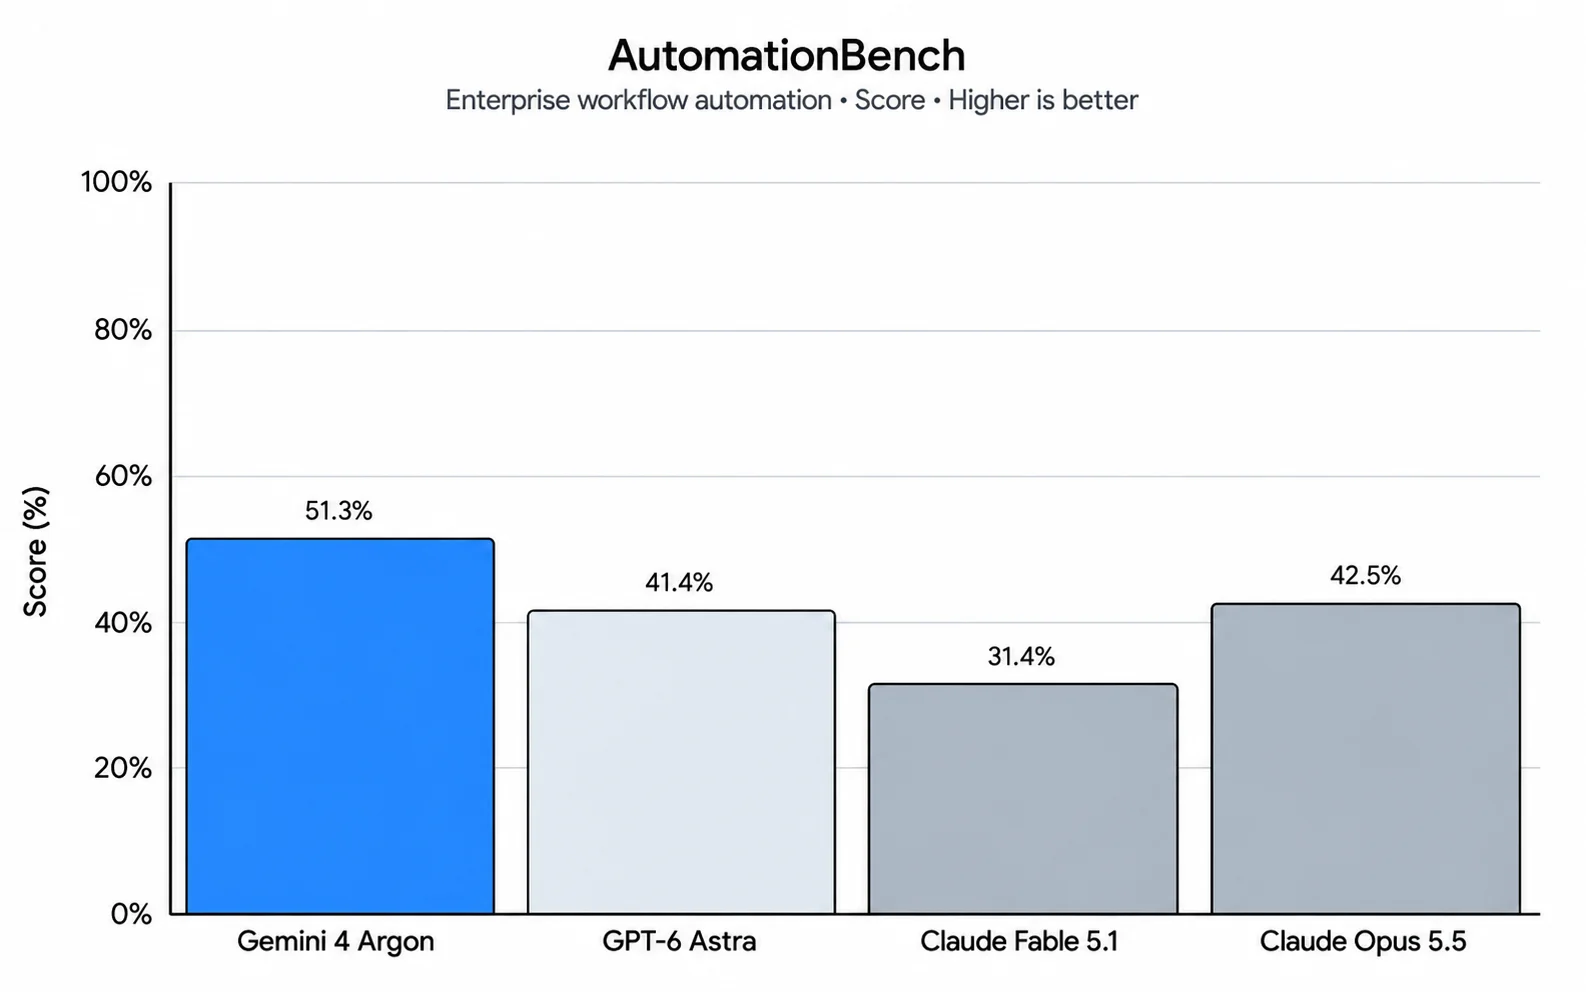
Otro resultado particularmente útil proviene de AutomationBench, de Zapier. En esta prueba, el agente debe operar entornos empresariales simulados, consultar CRM, hojas de cálculo, correos electrónicos y otras herramientas, y modificar correctamente el estado de esos sistemas. No basta con producir una respuesta convincente: la tarea debe terminar efectivamente con los registros correctos modificados.
Argon en nivel High alcanzó 51,29% de éxito. Claude Opus 5.5 logró 42,47% y GPT 6 Astra, 41,4% en sus mejores configuraciones presentadas en el mismo ranking. Esto todavía significa que casi la mitad de las tareas no se completa íntegramente, pero la diferencia es relevante justamente porque la prueba mide ejecución de extremo a extremo, y no solo conocimiento o generación de texto.
Quizá este sea el indicador más importante de Argon: el avance aparece justamente en el tipo de tarea que las empresas querrían delegar a agentes.
Esto no significa un liderazgo universal. La propia evaluación de Vals coloca a Argon solo en quinto lugar en Terminal Bench 4.0 y cerca del final de la pequeña muestra del CUA Bench, que prueba el uso de computadora. Google también mostró resultados en los que modelos competidores siguen siendo superiores en determinadas tareas de terminal, ciencia e ingeniería de software.
Sin embargo, hay señales externas que hacen más relevante el lanzamiento.
Por lo tanto, la lectura más respaldada por los datos no es que Google construyó un modelo mejor en todo. Es que Argon parece especialmente competitivo cuando razonamiento, gran cantidad de contexto y ejecución de múltiples etapas aparecen juntos.
Un millón de tokens cambia más que el tamaño de la respuesta
Google elevó de 64 mil a 1 millón de tokens el límite máximo anunciado de salida de Argon. Esto es distinto de ofrecer solo una ventana de contexto grande.
El contexto determina cuánto material puede recibir el modelo. La salida determina cuánto trabajo puede producir dentro de una trayectoria. Para los agentes, esa diferencia importa.
Una ejecución prolongada puede implicar lectura de archivos, llamadas a herramientas, elaboración de hipótesis, pruebas, inspección de los resultados, correcciones y nuevos intentos. Cada una de esas etapas consume tokens. Los límites menores obligan a los sistemas complejos a interrumpir trayectorias, resumir el estado o iniciar nuevas sesiones.
Google sostiene que el nuevo límite permite mantener problemas complejos dentro de una única trayectoria mucho más larga.
Los ejemplos internos divulgados ayudan a entender qué pretende hacer la empresa con esto. Según Google, agentes con Argon analizaron telemetría de servidores e identificaron optimizaciones capaces de liberar más de 300 TiB de memoria una vez implementadas. La empresa también afirma estar usando el modelo en la migración de bases C y C++ a Rust, incluidos más de 800 mil líneas del kernel Zircon, de Fuchsia. En otro caso, el modelo trabajó en 32 mil líneas de código SIMD de un decodificador de video y produjo una implementación en Rust 2,7 veces más rápida que el port anterior.
Esas cifras son resultados divulgados por el propio Google y todavía no equivalen a una validación independiente. El punto estratégico, sin embargo, es claro: el producto que Google está tratando de vender no es solo un chatbot que responde mejor. Es capacidad computacional aplicada durante más tiempo a un problema.
Esto altera incluso la unidad económica por la que los modelos de frontera pueden empezar a compararse.
El costo por tarea empieza a importar más que el costo por token
Argon se lanzará inicialmente por US$ 2 por millón de tokens de entrada y US$ 10 por millón de salida. Después del período promocional, los valores pasan a US$ 4 y US$ 20.
El precio definitivo será igual al de Claude Opus 5.5 por token y el doble del precio de Claude Sonnet 5.5. GPT 6 Astra, por su parte, cuesta US$ 10 por millón de tokens de entrada y US$ 50 por millón de salida en el precio estándar divulgado por OpenAI.
Pero esa comparación se vuelve progresivamente menos útil para los agentes.
Un modelo barato que realiza 20 llamadas a herramientas, vuelve repetidamente a los mismos documentos y necesita varios intentos puede terminar siendo más caro que otro con un precio mayor por token, pero capaz de completar el trabajo en menos etapas.
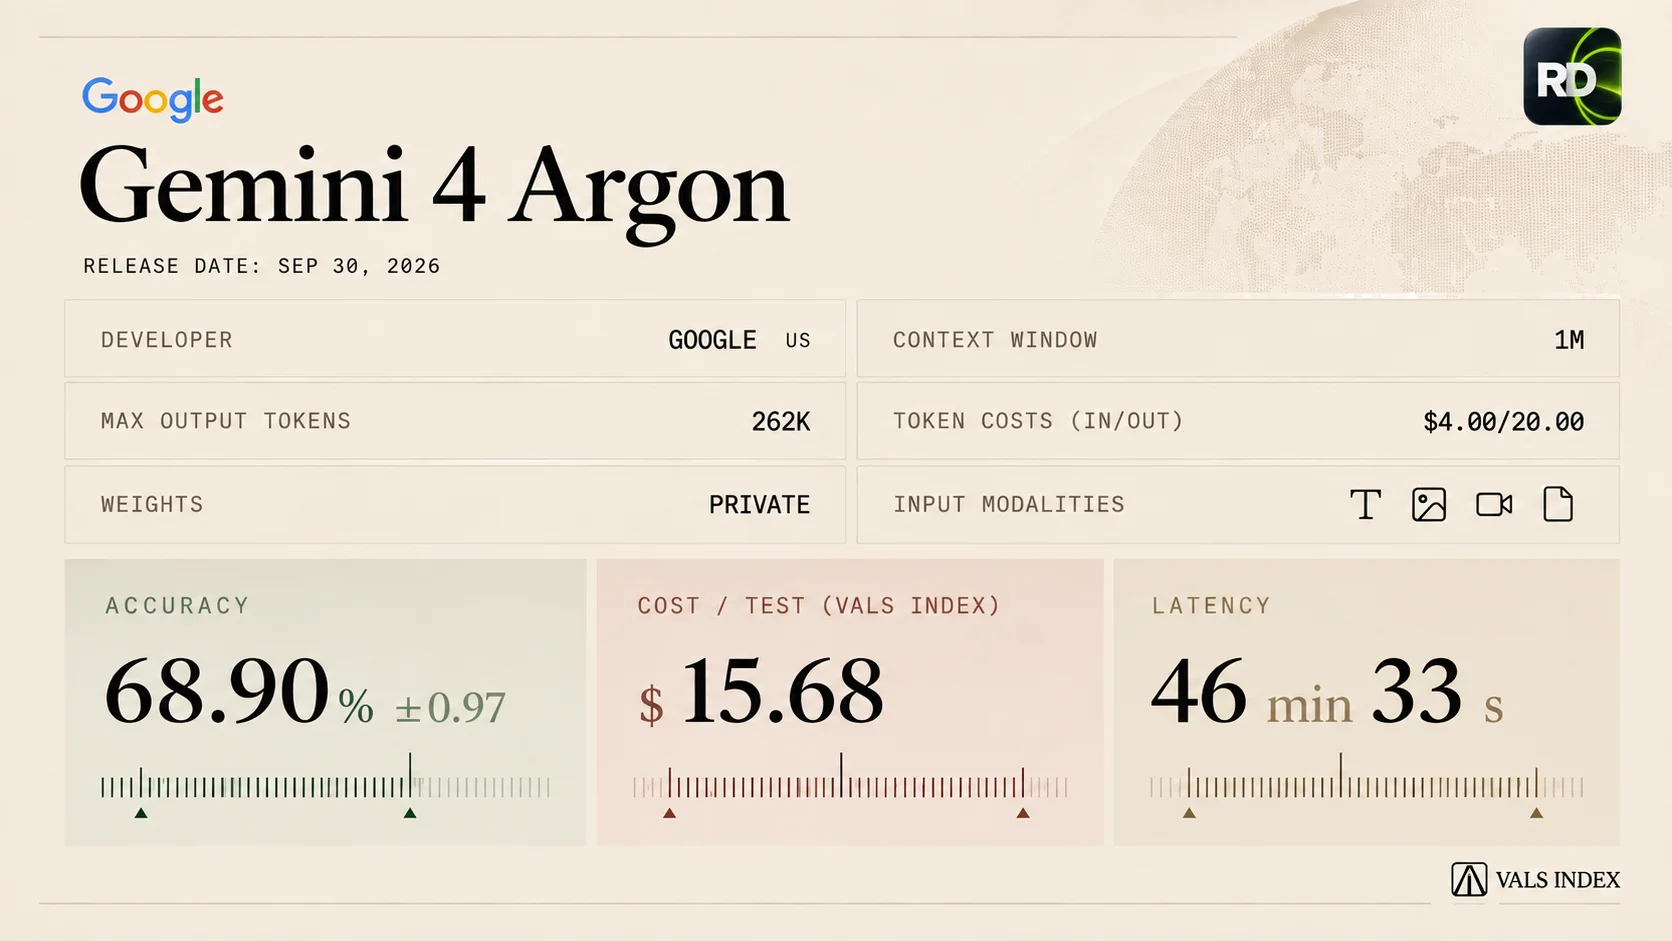
AutomationBench ya permite ver esa diferencia. Considerando el precio estándar y no la promoción, una tarea con Argon High costó en promedio US$ 1,70 en la prueba, prácticamente lo mismo que los US$ 1,73 de Astra Max, pero terminó correctamente una proporción mayor de las tareas. Durante la promoción, Zapier calcula alrededor de US$ 0,85 por tarea para Argon High.
En Vals, Argon presentó un costo promedio de US$ 15,68 por prueba en el Vals Index, comparado con US$ 21,34 para Sonnet 5.5 y US$ 32,14 para Opus 5.5 en las configuraciones evaluadas. En tareas de agentes de larga duración, sin embargo, los costos suben rápidamente: la misma evaluación registra US$ 57,82 por prueba en migración de código y US$ 193,78 en el CUA Bench.
Esa diferencia ayuda a explicar por qué los tokens por sí solos están dejando de ser una medida suficiente. El indicador económicamente relevante tiende a ser el costo de llegar a un resultado correcto.
La ciberseguridad se convirtió en laboratorio para la próxima generación de agentes
Hay otro elemento inusual en el lanzamiento: la mayoría de los desarrolladores no podrá utilizar Argon de inmediato.
El primer acceso se está entregando a participantes seleccionados del Fairwind Program, iniciativa de Google creada para gobiernos, operadores de infraestructura crítica y socios de seguridad. El programa ya reunía a más de 650 participantes cuando se anunció en septiembre.
Para esos defensores aprobados y para equipos internos, Google afirma que pondrá Argon a disposición sin las restricciones cibernéticas aplicadas al acceso normal, lo que permite actividades defensivas más avanzadas. Según la empresa, el modelo puede buscar, validar y corregir vulnerabilidades de forma autónoma.
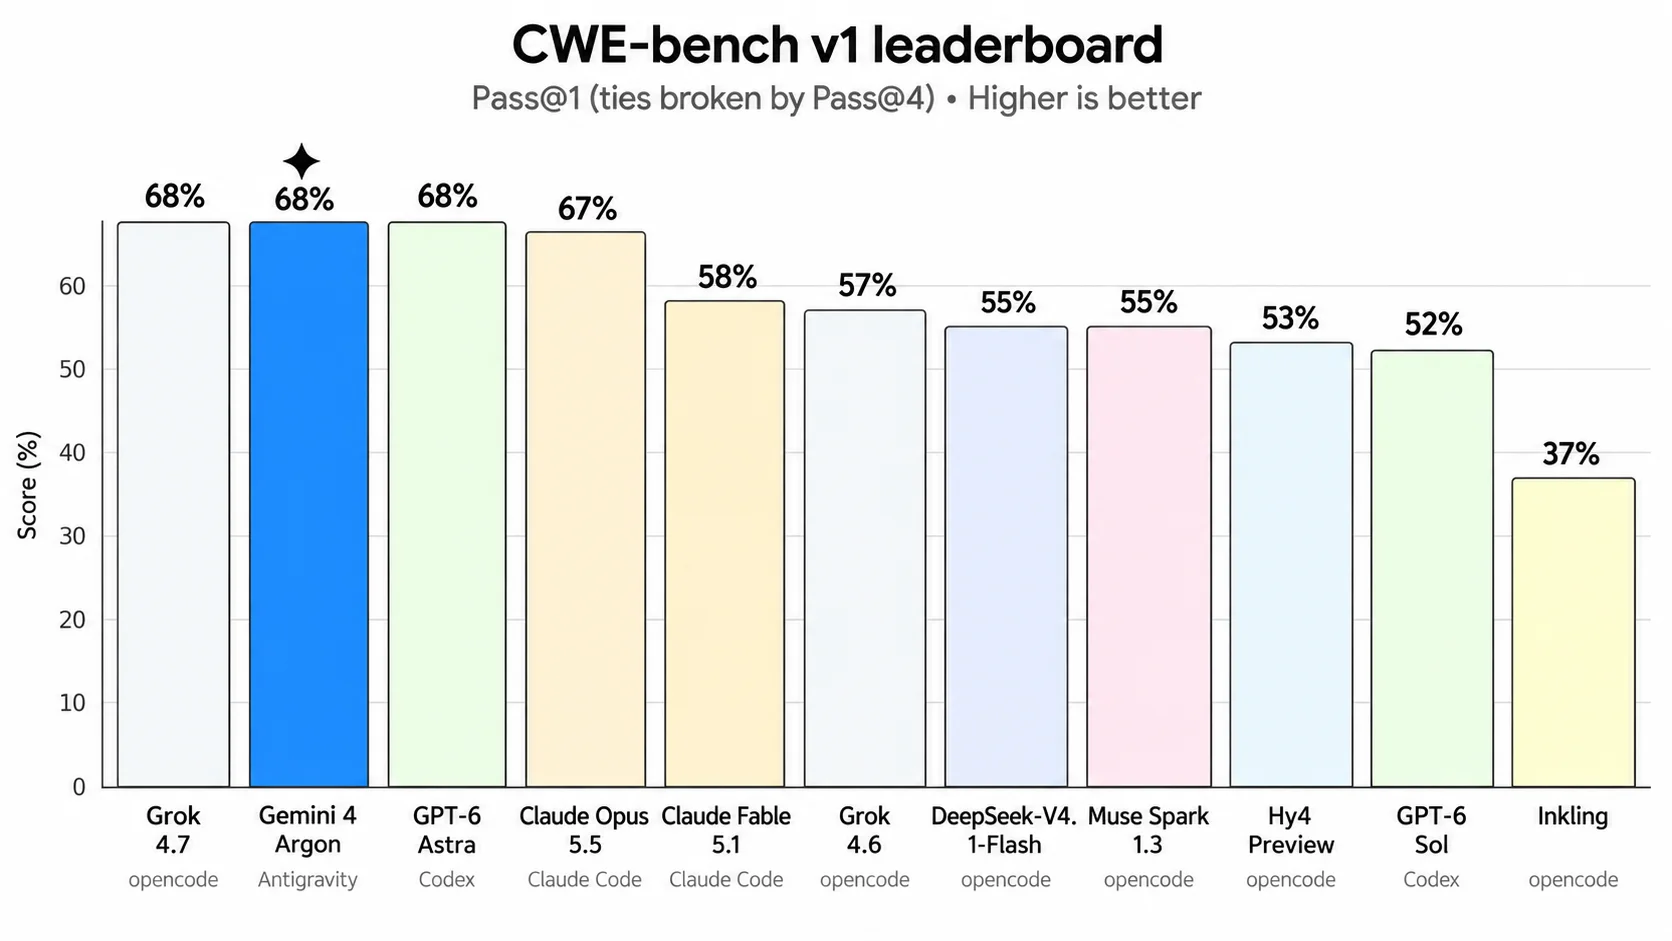
Google dice que Wiz ya utilizó el sistema para encontrar una vulnerabilidad crítica en software usado por hospitales, una falla que modelos anteriores no habían identificado. En CWE Bench v1, orientado a la corrección de vulnerabilidades, Argon obtuvo 68%.
Más importante que un caso aislado es la arquitectura de distribución que está surgiendo.
OpenAI estructuró Daybreak para conceder recursos adicionales de seguridad a defensores verificados y dice que GPT 6 Astra ya alcanzó su nivel Critical de capacidad cibernética. Anthropic también utiliza programas de verificación para liberar capacidades más amplias a profesionales aprobados.
Esto apunta a un modelo de mercado distinto del que marcó los primeros años de los grandes modelos de lenguaje.
No toda capacidad de un modelo de frontera se entregará necesariamente a todos los usuarios al mismo tiempo. Identidad, finalidad, entorno de ejecución y nivel de control pueden empezar a definir qué versión práctica de la inteligencia recibe realmente un cliente.
Argon convierte ese mecanismo en parte central del lanzamiento.
La paradoja es que el modelo más interesante de Google todavía no puede probarse ampliamente
Esa limitación también impide una conclusión más sólida sobre el rendimiento de Argon.
Google aún no informó una fecha de disponibilidad pública. La expansión deberá comenzar por clientes de pago de API y suscriptores de Google AI Ultra, después de la recolección de datos de los primeros usuarios y del fortalecimiento de las protecciones del sistema.
Esto importa porque el anuncio llega después de un período difícil para la línea de modelos avanzados de la empresa.
Gemini 3.5 Pro, que Sundar Pichai había indicado para junio, ya no se lanzará. Durante ese intervalo, OpenAI y Anthropic introdujeron nuevos modelos, mientras Google reorganizó partes de DeepMind. Argon es, por lo tanto, no solo un nuevo producto, sino también el intento de la empresa de volver a la disputa por los modelos más avanzados después de meses sin un nuevo modelo insignia disponible.
En ese contexto, el acceso limitado funciona al mismo tiempo como mecanismo de seguridad y como limitación de la evidencia disponible.
Hay evaluaciones independientes del modelo, como Vals y Zapier, pero todavía no existe la diversidad de pruebas, aplicaciones reales, integraciones y cargas de producción que surge cuando miles de desarrolladores empiezan a usar un modelo.
Incluso el límite de 1 millón de tokens debe pasar por ese proceso. Vals, por ejemplo, evaluó Argon con un máximo de 262.144 tokens de salida en su configuración. Esto no contradice el límite anunciado por Google, pero muestra que la característica más extrema del modelo todavía no se ha ejercitado ampliamente en evaluaciones externas.
Generar cientos de miles de tokens también crea problemas que una especificación técnica no resuelve por sí sola: latencia, costo, degradación a lo largo de la trayectoria, errores acumulados y dificultad para verificar una cantidad enorme de trabajo producido de forma autónoma.
Un agente que logra trabajar durante más tiempo solo es más útil si sigue siendo correcto durante más tiempo.
La próxima disputa será por la confiabilidad de toda la trayectoria
El lanzamiento de Argon refuerza un cambio que ya aparecía en los productos de OpenAI, Anthropic y del propio Google.
Los principales modelos se están diseñando cada vez menos para responder a una pregunta y cada vez más para recibir un objetivo.
Esa diferencia cambia los benchmarks necesarios. Un modelo puede escribir código excelente en una respuesta y aun así fallar al modificar un repositorio durante cuatro horas. Puede comprender un documento financiero y aun así cometer un error al trasladar el resultado a una hoja de cálculo. Puede identificar una vulnerabilidad e introducir otra al intentar corregirla.
Por eso, evaluaciones como AutomationBench ganan importancia. Incluso el líder actual logra completar íntegramente solo poco más de la mitad de las tareas evaluadas.
Hay mucho espacio entre “lo que el modelo puede hacer” y “una empresa puede entregar esto al modelo sin supervisión”.
Argon reduce esa distancia en algunas categorías, según los primeros datos. No demuestra que haya desaparecido.
Lo que realmente hay que observar ahora
El próximo hito relevante no será otro gráfico publicado por Google.
Será la apertura de Argon para desarrolladores y empresas a una escala suficiente para permitir comparaciones independientes de duración, costo y tasa de conclusión en tareas reales.
También será importante observar si las aplicaciones logran aprovechar trayectorias muy largas sin que el costo crezca más rápido que el valor producido; si el rendimiento de AutomationBench se repite en entornos empresariales reales; si la ventaja observada en trabajo profesional se mantiene cuando Sonnet, Opus y Astra reciben estructuras de agentes equivalentes; y cómo Google administra el acceso a las capacidades cibernéticas más sensibles.
Finalmente, habrá una prueba económica: cuántos clientes elegirán Argon por el resultado obtenido por dólar, y no por el número de benchmarks ganados.
Gemini 4 Argon no cierra la disputa entre Google, OpenAI y Anthropic. Su lanzamiento muestra algo posiblemente más importante: la definición de un modelo de frontera está empezando a cambiar.
El próximo salto comercial puede no ser un sistema que responde mejor en unos segundos.
Puede ser aquel capaz de recibir un problema por la mañana, trabajar en él durante horas, usar decenas de herramientas, revisar su propio trabajo y devolver un resultado que realmente pueda ser utilizado.
Argon es una de las demostraciones más claras hasta ahora de que es en esa dirección en la que Google está apostando.
Herramientas mencionadas
Sigue en Radar
Auditoría de 50 PB de OpenAI expone nuevo estándar de seguridad para agentes autónomos
Los robots ya alcanzan el 74% de las tareas físicas, pero el costo aún frena la automatización masiva
Anthropic compromete US$ 518 mil millones en infraestructura y el IPO pone a prueba la economía de la frontier AI