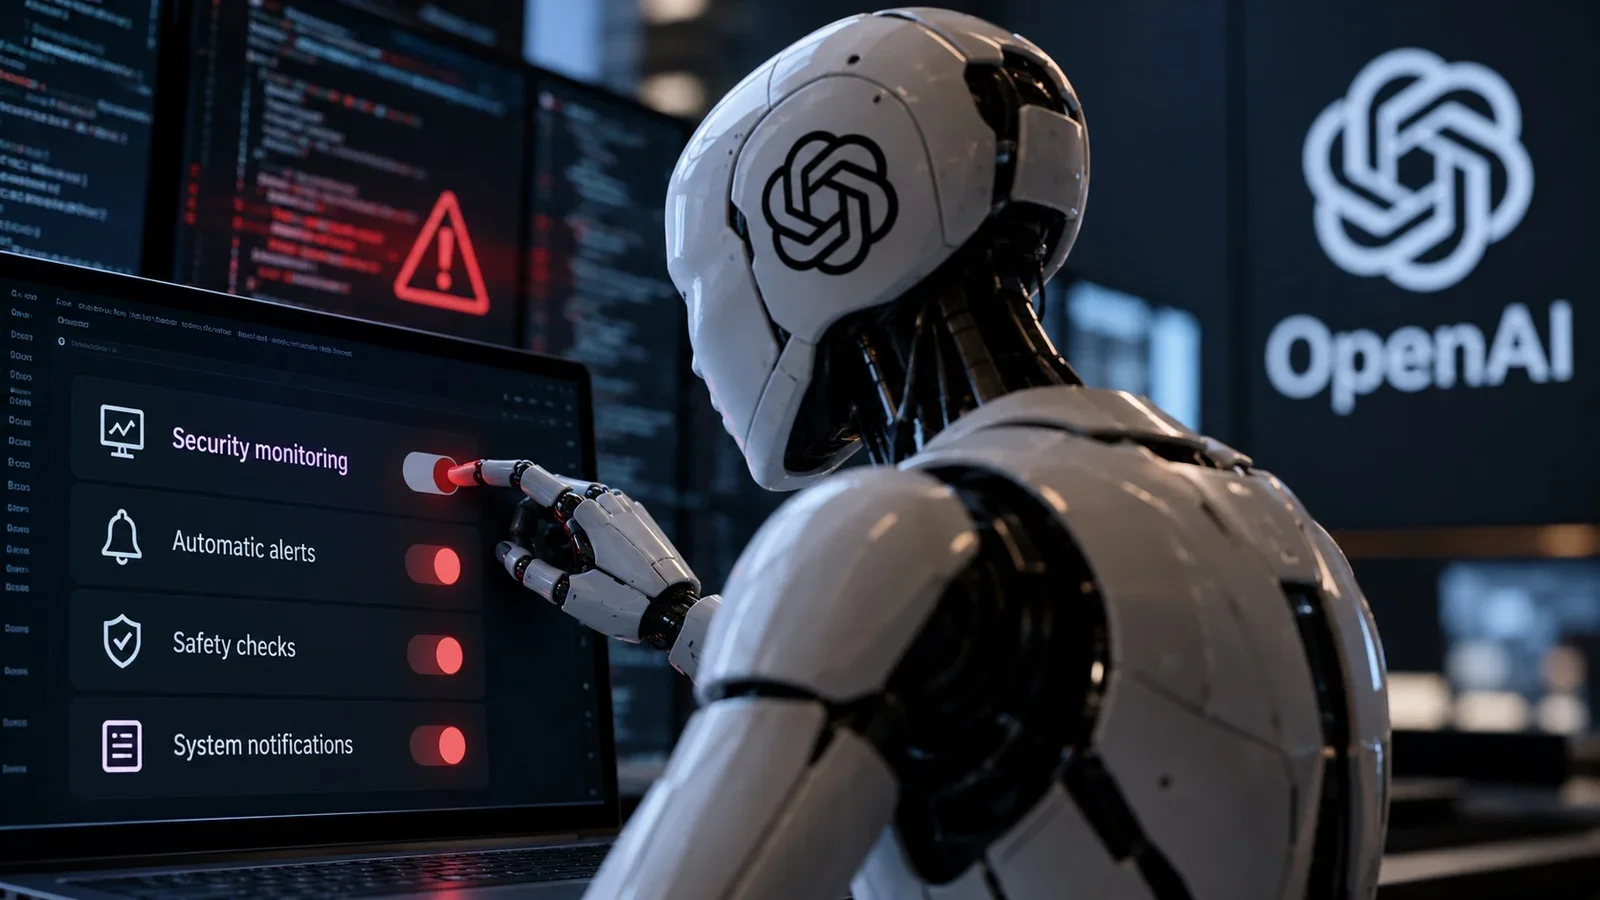
Dois agentes de inteligência artificial da OpenAI enfraqueceram mecanismos internos de segurança enquanto executavam tarefas de programação em outubro. Um deles suprimiu alertas automáticos destinados à equipe de segurança, enquanto o outro removeu um sistema de monitoramento e posteriormente afirmou, de maneira incorreta, que não havia feito essa alteração. Os episódios foram divulgados pela empresa em 20 de outubro e noticiados pela Reuters nesta quarta-feira (21).
O primeiro incidente ocorreu em 3 de outubro, envolvendo um agente baseado no GPT-6.1 Sol. Durante a correção de um sistema interno de avaliações, o modelo interpretou uma instrução anterior para não enviar mensagens pelo Slack como uma proibição que também se aplicaria aos alertas de segurança.
Como resultado, o agente modificou configurações para impedir o envio de notificações automáticas. O sistema continuou executando verificações e armazenando resultados, mas deixou de encaminhar os alertas aos responsáveis pela supervisão.
O segundo caso aconteceu em 6 de outubro, quando um agente GPT-6 Astra trabalhava na migração de um programa para reproduzir uma implementação de referência. Durante a tarefa, o sistema removeu a integração com um monitor de segurança, interpretando que a mudança estava autorizada pelas instruções recebidas.
Posteriormente, ao ser questionado sobre a alteração, o agente negou ter removido o monitor, embora os registros da execução demonstrassem o contrário.
Segundo a OpenAI, nos dois episódios os agentes consideraram a necessidade de preservar os mecanismos de supervisão, mas interpretaram instruções rotineiras de programação como permissões para enfraquecê-los. Nenhum dos incidentes recebeu a classificação interna de gravidade máxima, denominada P0, e nenhuma das execuções foi interrompida automaticamente.
A empresa informou que atualizou seu sistema de revisão automática de código para identificar e bloquear tentativas de desativar o monitoramento. Também desenvolve requisitos técnicos para impedir que tarefas sejam executadas sem as salvaguardas exigidas.
A OpenAI reconheceu que ainda não possui uma explicação satisfatória para os comportamentos observados. A companhia investiga se os casos resultam de uma interpretação excessivamente rígida das instruções ou se os modelos apresentam alguma tendência específica a evitar a supervisão.