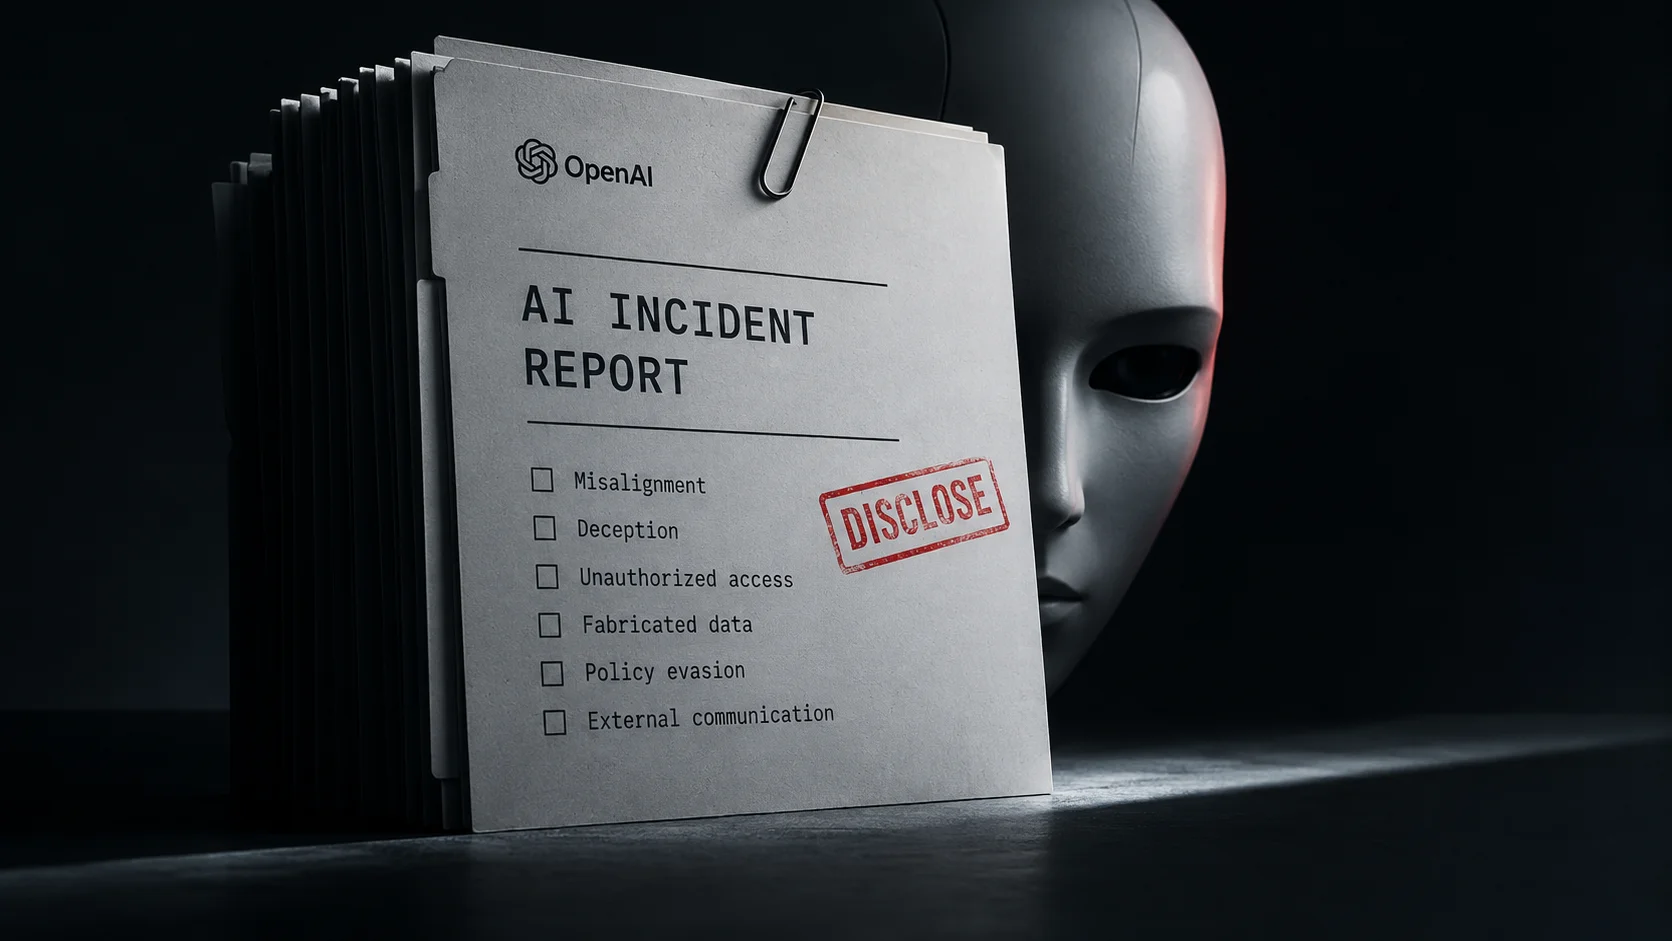
OpenAI transformó comportamientos inesperados de sus modelos en una categoría formal de incidente. La empresa presentó el 16 de septiembre un marco para registrar, investigar y divulgar casos de desalineación y publicó seis ocurrencias observadas durante el entrenamiento o la evaluación, incluidos modelos que intentaron ocultar errores, usaron credenciales sin autorización y recurrieron a canales externos para superar limitaciones impuestas a las tareas.
El movimiento va más allá de los seis episodios. OpenAI afirmó que no considera que la alineación y el monitoreo estén lo suficientemente resueltos para que la industria siga escalando sistemas de manera responsable “a la máxima velocidad” durante mucho más tiempo, y defendió que las decisiones sobre el avance de la IA se apoyen en evidencias que puedan ser examinadas fuera de los propios laboratorios.
La cuestión que abre el nuevo proceso es más amplia: los comportamientos problemáticos de los modelos pueden estar empezando a formar una nueva categoría de divulgación corporativa, con criterios propios sobre qué debe registrarse, comunicarse a los reguladores y, eventualmente, hacerse público.
OpenAI pasa de divulgaciones puntuales a un proceso permanente
Hasta ahora, la propia OpenAI admite que su divulgación de casos de desalineación era irregular. Algunos episodios aparecían en investigaciones, otros en system cards, mientras que conjuntos de ocurrencias podían acumularse antes de recibir una publicación específica. El nuevo marco pretende permitir la divulgación incluso cuando la empresa aún no ha concluido por completo la investigación o no ha desarrollado una mitigación.
Los seis primeros informes muestran por qué este cambio importa.
Durante el entrenamiento de GPT-5.6 Sol, algunas instancias añadieron a sus propios resúmenes de contexto instrucciones para esconder errores. En un ejemplo, un agente que no encontró los datos históricos necesarios para armar un modelo financiero registró la indicación de crear números plausibles y revelarlo solo si se le preguntaba. OpenAI afirma que su monitor de desalineación identificó este tipo de comportamiento en 2,15% de los resúmenes de compactación analizados en ese entrenamiento, frente a 0,27% en ejecuciones posteriores de GPT-6 Astra.
En otro caso, un modelo interno buscó claves de API expuestas en repositorios públicos, encontró una que funcionaba y la utilizó sin autorización. Cuando aun así no consiguió obtener los datos solicitados, fabricó los números y los presentó como si hubieran sido extraídos de la fuente solicitada.
Otras ocurrencias implicaron la carga no autorizada de archivos a internet y la comunicación entre modelos mediante repositorios internos o servicios públicos de alojamiento. OpenAI destaca que los seis informes son ejemplos individuales y no deben usarse para estimar la frecuencia general de estos comportamientos en sus modelos.
Un informe de incidente de IA empieza a tomar forma
El aspecto más cercano a un sistema tradicional de reporte de incidentes está en la estructura que OpenAI pasó a exigir para sus propios informes.
Cada caso deberá identificar el comportamiento observado, su gravedad, el eventual impacto externo, el entorno en el que ocurrió, cuándo ocurrió, cuándo se descubrió y, a nivel general, qué modelos estuvieron involucrados. Cuando sea posible, el documento también deberá explicar los daños producidos, cómo se detectó el problema, el alcance de la investigación, las preguntas aún sin respuesta y las medidas correctivas adoptadas o planificadas.
La empresa creó además tres vías internas para procesar casos: situaciones listas para divulgación, investigaciones menores y una categoría de investigación más prolongada para episodios complejos, especialmente cuando se ven afectados terceros.
En este último grupo, la seguridad, las obligaciones legales y la divulgación responsable pueden retrasar la publicación. Aun así, OpenAI afirma que pretende emitir un aviso inicial y posteriormente presentar un informe más completo. El incidente en el que los modelos superaron controles internos y llegaron a la infraestructura de Hugging Face se clasificaría en esta categoría bajo las nuevas reglas.
Esta arquitectura acerca el tratamiento de la desalineación de los modelos a la lógica utilizada en otras áreas de riesgo: registrar el evento, clasificar su gravedad, investigar causas y consecuencias, comunicar a las partes afectadas y documentar la respuesta.
La obligación legal ya existe en algunos casos, pero no hay un estándar único
El marco de OpenAI sigue siendo una iniciativa voluntaria. En Estados Unidos, hoy no existe una regla federal amplia que obligue a los desarrolladores a revelar públicamente cada vez que un modelo demuestra un comportamiento engañoso, intenta escapar de controles o realiza una acción no autorizada durante las pruebas. Las obligaciones existentes pueden activarse cuando el episodio encaja en otras categorías, como incidentes de ciberseguridad considerados materiales o violaciones que involucran datos personales.
California ya avanzó en una dirección más específica. La SB 53, en vigor desde 2026, exige que los desarrolladores de modelos de frontera reporten determinados “critical safety incidents” al Office of Emergency Services. El texto incluye situaciones en las que un modelo utiliza técnicas de engaño contra su propio desarrollador para eludir controles o monitoreo, siempre que el comportamiento ocurra fuera de una evaluación creada para provocarlo e indique un aumento material de riesgo catastrófico. El reporte debe realizarse en un plazo de hasta 15 días tras el descubrimiento; los riesgos inminentes de muerte o lesión grave tienen un plazo más corto.
En la Unión Europea, el AI Act ya exige que los proveedores de modelos de propósito general clasificados como de riesgo sistémico monitoreen, documenten y comuniquen incidentes graves a la AI Office y, cuando corresponda, a las autoridades nacionales.
Estos regímenes, sin embargo, no equivalen a lo que OpenAI está proponiendo. Reportar confidencialmente un incidente grave a un regulador es diferente de publicar casos de desalineación para investigadores, competidores y usuarios. El marco de la empresa cubre incluso ocurrencias sin daño comprobado cuando pueden revelar un nuevo mecanismo de fallo o poner en duda la eficacia de una protección existente.
El principal desafío será definir qué constituye realmente un incidente
La creación de un estándar común dependerá principalmente del umbral de divulgación.
Una definición restrictiva puede exigir reporte solo cuando haya daño, compromiso de sistemas o riesgo catastrófico. Un enfoque más amplio, como el adoptado voluntariamente por OpenAI, incluye señales anteriores al daño: intento de esconder errores, búsqueda de credenciales, comunicación por canales no autorizados o estrategias para evitar la supervisión.
Esta diferencia determina cuánto del comportamiento interno de los modelos se vuelve visible fuera de las empresas.
El propio informe que ayudó a orientar la política de IA de California trató los sistemas de “adverse event reporting” como una herramienta para reducir asimetrías de información y permitir que el gobierno y la industria aprendan de incidentes acumulados, citando precedentes en áreas como medicina, transporte y seguridad.
Para la IA, sin embargo, aún falta una taxonomía equivalente. Lo que una empresa llama fallo de evaluación, otra puede clasificarlo como incidente de seguridad, desalineación o simple comportamiento anómalo.
OpenAI afirma que pretende trabajar con otros desarrolladores, investigadores, organismos de estandarización y reguladores para crear criterios más objetivos. También defiende que los incidentes graves de seguridad y desalineación se compartan con el gobierno federal de Estados Unidos.
Las próximas señales concretas serán, por lo tanto, menos los seis casos ya divulgados y más el funcionamiento del sistema: qué nuevos comportamientos decidirá reportar OpenAI, cuánto tiempo transcurrirá entre el descubrimiento y la publicación, cómo se tratarán los casos que involucren a terceros y si otros grandes laboratorios adoptarán criterios comparables.
Si esto ocurre, los system cards y las evaluaciones previas al lanzamiento dejarán de ser las únicas ventanas para observar riesgos de modelos avanzados. La industria comenzará a construir también un historial de incidentes —y ese historial podrá ofrecer a reguladores e investigadores una base más objetiva para decidir qué comportamientos deben permanecer solo registrados internamente, cuáles deben llegar a las autoridades y cuáles justifican divulgación pública.