A chinesa Z.AI lançou nesta sexta-feira (18) o GLM-5.3-FlashX, nova versão de sua família de modelos voltada a aplicações que exigem menor latência. O modelo já está disponível via API e alcança até 200 tokens por segundo, segundo a documentação oficial da empresa.
O FlashX entrega velocidade de inferência cinco vezes maior que a do GLM-5.3-Flash, mas chega com preço 2,5 vezes superior ao da versão original, de acordo com informações divulgadas pela companhia e repercutidas nesta sexta-feira por veículos chineses.
A proposta é oferecer uma alternativa para desenvolvedores que priorizam velocidade de resposta, especialmente em agentes de IA, aplicações interativas e serviços nos quais a latência tem impacto direto na experiência do usuário.
FlashX troca custo menor por mais velocidade
Na documentação para desenvolvedores, a Z.AI lista os códigos glm-5.3-flash e glm-5.3-flashx para acesso pela API. O FlashX, porém, ainda não está disponível no GLM Coding Plan, assinatura da empresa voltada ao uso dos modelos em ferramentas de programação.
A família GLM-5.3-Flash/FlashX oferece janela de contexto de 1 milhão de tokens e suporta saídas de até 128 mil tokens. O modelo aceita texto, imagens, vídeo e arquivos como entrada, enquanto a saída é textual.
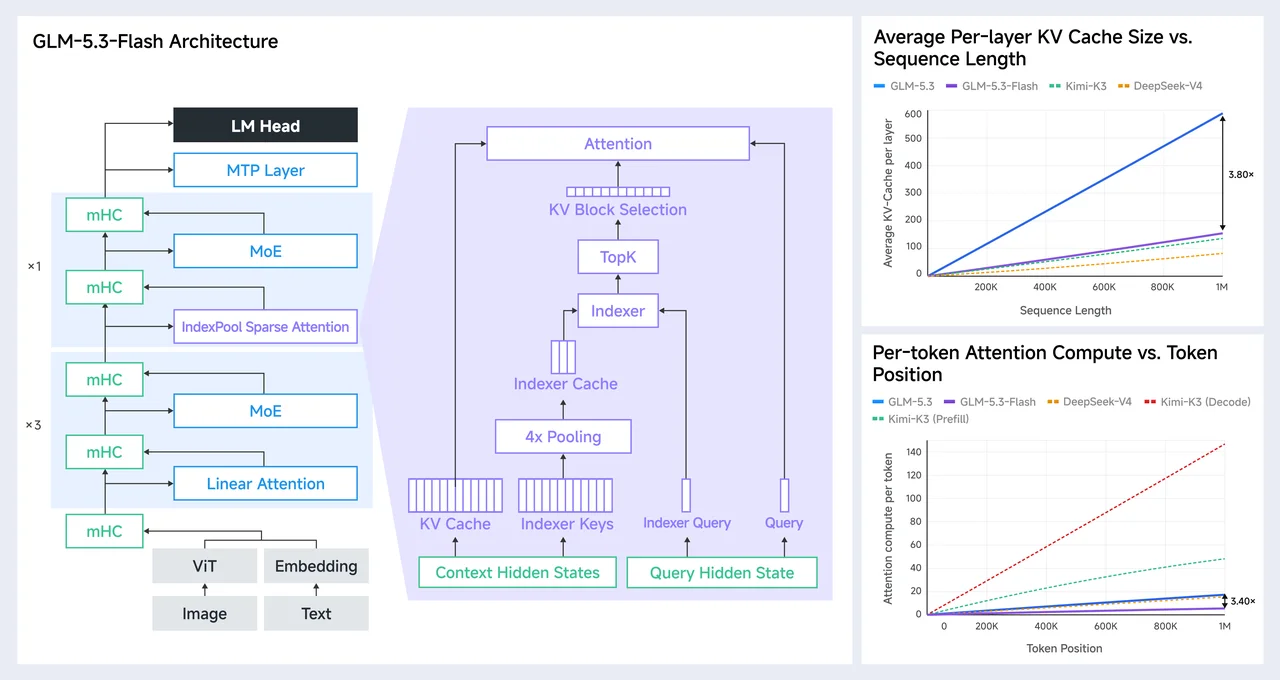
O GLM-5.3-Flash tem 320 bilhões de parâmetros no total, com 18 bilhões ativados, e utiliza uma arquitetura híbrida que combina atenção esparsa e linear. Segundo a Z.AI, esse desenho reduz o custo computacional da atenção e o tamanho do cache KV em comparação com o GLM-5.3.
O lançamento do FlashX ocorre em meio ao aumento da demanda pela versão Flash. A Z.AI afirma ter ampliado sua capacidade de computação para absorver o crescimento das chamadas, enquanto veículos chineses relatam que o cluster usado pela companhia, formado por cerca de 100 mil aceleradores produzidos na China, chegou rapidamente a alta utilização após a estreia do modelo.
Com a nova variante, a Z.AI passa a separar de forma mais clara duas prioridades: o GLM-5.3-Flash mantém foco em custo, enquanto o FlashX oferece maior velocidade de geração para aplicações dispostas a pagar mais por menor tempo de resposta.