A DeepSeek está próxima de captar ao menos 80 bilhões de yuans, cerca de US$ 12 bilhões, em uma nova rodada liderada por investidores que incluem Tencent e CATL, segundo a Bloomberg. A demanda poderia levar o montante final para perto de 100 bilhões de yuans. A Reuters não conseguiu verificar independentemente a informação, e as três empresas não comentaram o relato.
Se confirmada, a rodada marca uma mudança importante na lógica que transformou a DeepSeek em um dos principais laboratórios de IA da China. A empresa ganhou espaço demonstrando que arquitetura e eficiência poderiam compensar parte da desvantagem chinesa em acesso a chips avançados. Agora, a questão é o que acontece quando essa mesma estratégia passa a operar com dezenas de bilhões de dólares de capital.
A DeepSeek já deixou de depender apenas de capital próprio
Durante anos, a DeepSeek foi financiada principalmente pela High Flyer, o hedge fund de Liang Wenfeng. Essa estrutura começou a mudar em 2026, quando a empresa abriu espaço para investidores externos para financiar capacidade computacional, desenvolvimento de modelos e retenção de talentos.
Em junho, a Reuters informou que a primeira rodada externa deveria levantar aproximadamente 50 bilhões de yuans, ou US$ 7,4 bilhões. Liang teria comprometido 20 bilhões de yuans, enquanto Tencent e CATL entrariam com 10 bilhões e 5 bilhões, respectivamente.
Documentos posteriores forneceram uma confirmação parcial dessa mudança. Um filing da Anhui Korrun mostrou que um fundo no qual a empresa investiu adquiriu participação indireta na DeepSeek a uma avaliação implícita de aproximadamente 350,9 bilhões de yuans, ou US$ 51,8 bilhões. Outro investimento divulgado pela Jiuan Medical apontou para uma faixa semelhante.
Isso torna a nova captação menos uma ruptura isolada e mais a aceleração de uma estratégia iniciada meses atrás: a DeepSeek está deixando de financiar sua vantagem tecnológica apenas com eficiência operacional e passando a construir uma base de capital comparável à de uma empresa de infraestrutura de IA.
Mais dinheiro não significa abandonar a eficiência
A expansão de capital não elimina a característica que diferenciou a DeepSeek.
O DeepSeek V3, lançado em 2024, foi treinado com 2,788 milhões de horas de GPUs H800, segundo a documentação técnica da empresa. Já o V4.1 Flash, apresentado em setembro, usa uma arquitetura de 552 bilhões de parâmetros, mas ativa apenas 8 bilhões durante a entrada e 16 bilhões durante a geração. A empresa afirma ainda que o modelo reduz para um quarto o uso de memória HBM pelo cache e para um oitavo a necessidade de armazenamento SSD em comparação com a geração anterior.
Essas escolhas mostram que eficiência continua sendo parte da arquitetura, e não apenas uma resposta temporária à falta de dinheiro.
O capital adicional pode permitir que essa eficiência seja aplicada sobre uma infraestrutura muito maior. Treinamento com mais compute, reinforcement learning em escala, clusters maiores para experimentação, inferência para milhões de usuários e contratação de pesquisadores são despesas que continuam crescendo mesmo quando cada unidade de computação é usada melhor.
A própria DeepSeek já sinaliza essa direção. Ao apresentar o V4.1 Flash, mencionou cenários de implantação envolvendo mais de 2 mil GPUs e clusters de armazenamento.
O efeito potencial, portanto, não é substituir eficiência por força bruta. É combinar as duas.
O principal limite continua sendo o acesso a compute
Dinheiro, porém, não resolve automaticamente o maior obstáculo da DeepSeek.
As restrições americanas limitam o acesso de empresas chinesas aos chips mais avançados usados por laboratórios dos Estados Unidos. Essa diferença ajuda a explicar por que mesmo uma rodada de US$ 12 bilhões não coloca automaticamente a DeepSeek na mesma posição de competidores americanos com acesso direto a grandes clusters de GPUs Nvidia.
A resposta da companhia está começando a aparecer no próprio stack tecnológico. Em setembro, a DeepSeek anunciou uma parceria com a Huawei para desenvolver software otimizado para chips Ascend, incluindo bibliotecas de computação e comunicação. As duas empresas também trabalharam em uma configuração baseada em 128 chips Ascend 950, enquanto a DeepSeek abriu parte da infraestrutura desenvolvida para esse ecossistema.
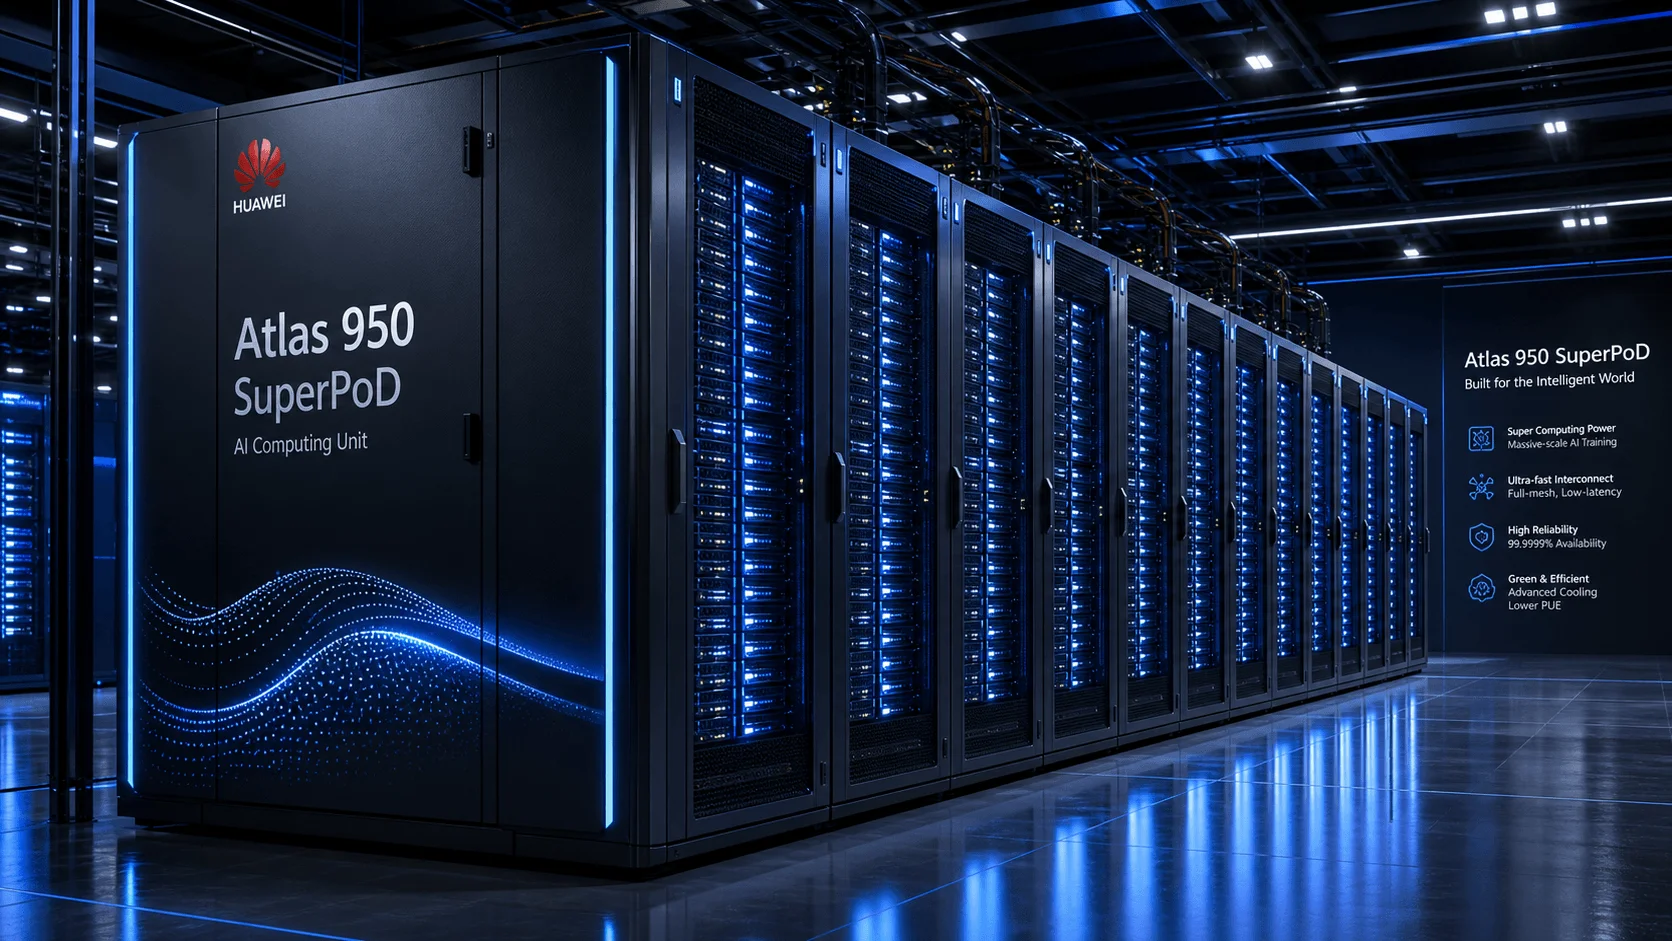
Isso muda a função do capital. Parte da vantagem de uma rodada desse tamanho pode não estar em comprar o mesmo hardware utilizado pelos concorrentes americanos, mas em financiar a construção de uma alternativa chinesa capaz de aproximar hardware, software, modelos e datacenters.
O desafio é que esse processo exige execução em várias camadas ao mesmo tempo. Capital reduz a restrição financeira, mas não elimina gargalos de semicondutores, rendimento dos chips, software, energia ou disponibilidade de clusters.
Tencent e CATL apontam para algo maior que uma rodada financeira
A composição dos investidores também merece atenção.
Tencent é uma das maiores plataformas digitais da China e desenvolve seus próprios modelos Hunyuan. CATL, por sua vez, vem ampliando sua atuação em infraestrutura energética para datacenters de IA. Na primeira rodada da DeepSeek, ambas já apareciam como os maiores investidores externos.
Isso não significa que exista um consórcio formal para transformar a DeepSeek em um campeão nacional. Nenhuma estrutura desse tipo foi anunciada, e os termos da nova rodada permanecem desconhecidos.
Mas o alinhamento é relevante. Uma empresa de foundation models financiada simultaneamente por grandes grupos de tecnologia, indústria e infraestrutura pode ter acesso a recursos que vão além do dinheiro, desde capacidade computacional e canais de distribuição até energia e implantação empresarial.
A diferença entre investimento financeiro e integração estratégica será um dos pontos mais importantes a observar. Participações acionárias, sozinhas, não garantem que DeepSeek será incorporada aos produtos da Tencent ou à infraestrutura ligada à CATL.
O IPO será o próximo teste da nova DeepSeek
A ampliação da rodada acontece enquanto a empresa também se aproxima do mercado público.
Em setembro, a Reuters informou que a DeepSeek contratou a CITIC Securities para preparar uma possível listagem na STAR Market de Xangai. O tamanho, a avaliação e o calendário da operação ainda não foram definidos. Naquele momento, a empresa já buscava capital para compute, desenvolvimento de modelos e retenção de pesquisadores.
Mesmo uma rodada próxima de US$ 12 bilhões continuaria abaixo das captações recentes atribuídas a alguns grandes laboratórios americanos. O ponto mais relevante, porém, está na mudança dentro da própria DeepSeek.
A empresa construiu sua posição demonstrando que menos compute poderia produzir resultados competitivos. Agora terá de mostrar se essa eficiência continua sendo uma vantagem quando o orçamento deixa de ser a principal restrição.
Os sinais concretos virão do tamanho final da rodada, da avaliação atribuída à empresa, dos direitos recebidos pelos novos investidores, do investimento em clusters e chips chineses e dos próximos modelos da família V4.1. Um eventual filing do IPO também deverá fornecer uma visão muito mais clara sobre custos, receitas e necessidade real de capital.
Se esses movimentos avançarem, a transformação da DeepSeek não será simplesmente de um laboratório eficiente para um laboratório que gasta mais. Será o teste de uma tese mais ambiciosa: se eficiência arquitetural combinada com capital em escala consegue reduzir parte da vantagem de infraestrutura que ainda separa a China dos maiores laboratórios americanos.