Alemania podría dejar de generar €155 mil millones al año en valor económico adicional si la Unión Europea endurece las normas de acceso a los datos utilizados en el entrenamiento de inteligencia artificial. La estimación fue dada a conocer este martes (13) por el instituto alemán ifo, a partir de una simulación de los efectos de posibles restricciones regulatorias.
El estudio calcula que la IA generativa podría añadir €440 mil millones anuales a la economía alemana hasta 2034. Las limitaciones más severas a los datos de entrenamiento reducirían ese potencial en aproximadamente 35%, principalmente debido al desarrollo de modelos menos eficientes y a la adopción más lenta de la tecnología por parte de las empresas.
Los investigadores identificaron tres fuentes para el potencial económico proyectado: €330 mil millones provenientes de la utilización generalizada de la IA, €65 mil millones de ganancias de productividad en la investigación y €45 mil millones del desarrollo de inteligencia artificial en Alemania.
Los modelos menos eficientes representan €75 mil millones de los €155 mil millones estimados
La mayor parte de la reducción proyectada está asociada a la calidad de los modelos. Según los cálculos, los sistemas entrenados con acceso más limitado a los datos podrían representar €75 mil millones anuales en ganancias económicas no realizadas.
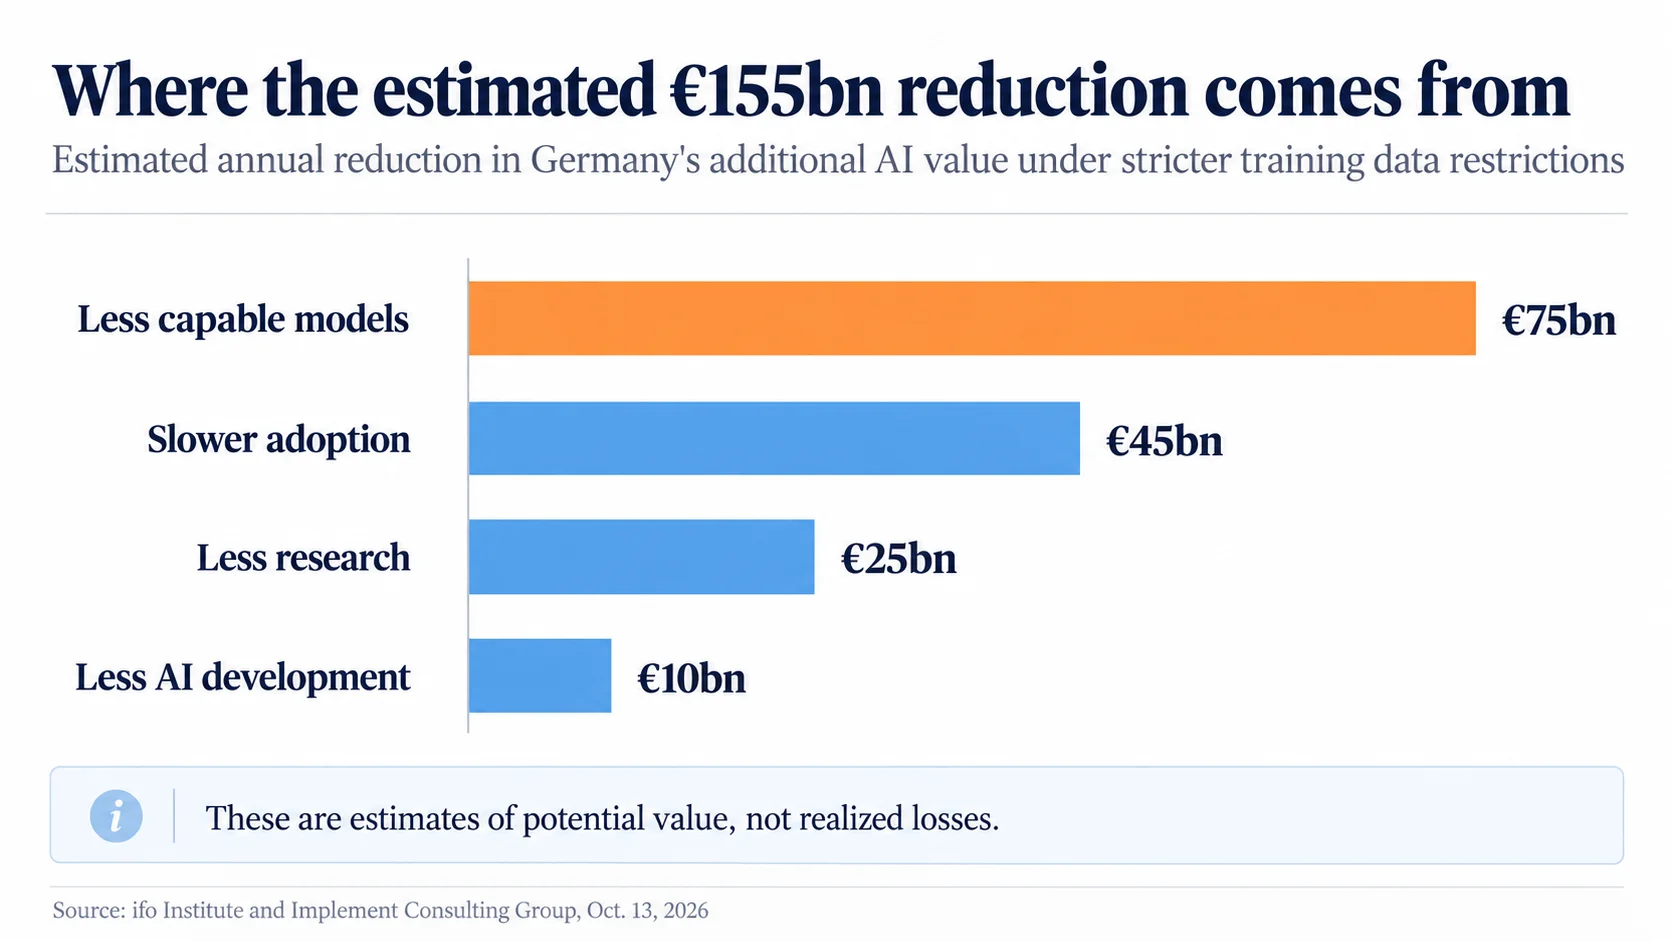
Otros €45 mil millones estarían relacionados con la adopción más lenta de la tecnología, mientras que €25 mil millones derivarían de la reducción del potencial de investigación. Los €10 mil millones restantes corresponderían a la menor actividad de desarrollo de IA en Europa.
La diferencia en la disponibilidad de datos ayuda a explicar la preocupación de los investigadores. El mayor conjunto europeo de datos libres de derechos de autor contiene aproximadamente 2 a 3 billones de tokens, unidades utilizadas en el procesamiento de textos por modelos de lenguaje. Los sistemas internacionales avanzados, en comparación, ya utilizan entre 15 y 36 billones de tokens en su entrenamiento.
Para Oliver Falck, director del Centro de Economía de la Innovación y Transformación Digital del ifo, dificultar el acceso a estos materiales compromete la capacidad europea de desarrollar modelos competitivos.
La discusión tiene lugar durante la revisión de la Directiva de Derechos de Autor por parte de la Comisión Europea, iniciada en mayo de 2026. Los autores defienden preservar la excepción que permite la minería de textos y datos con fines comerciales, combinada con requisitos proporcionales de transparencia, mecanismos de oposición de los titulares de derechos y acuerdos voluntarios de licencia.
Los €155 mil millones no representan pérdidas ya registradas ni una previsión económica definitiva. El propio ifo destaca que los valores son estimaciones de potencial, condicionadas a las hipótesis utilizadas en el modelado.
La investigación fue desarrollada por Implement Consulting Group en colaboración con el instituto ifo, por encargo de CCIA Europe y Google, organizaciones con intereses en el debate sobre el acceso a datos para el entrenamiento de IA.
Los resultados añaden una estimación económica al debate regulatorio europeo, pero no demuestran que las restricciones analizadas serán necesariamente adoptadas o producirán los efectos calculados.
Sigue en Radar
SK Hynix negocia licencias en China en un plan vinculado a una nueva fábrica en EE. UU., según Reuters
Microsoft desarticula una red de phishing vinculada a más de 1 mil millones de mensajes fraudulentos
La FTC acusa a una empresa de obtener US$ 60 millones con falsas promesas a víctimas de extorsión sexual