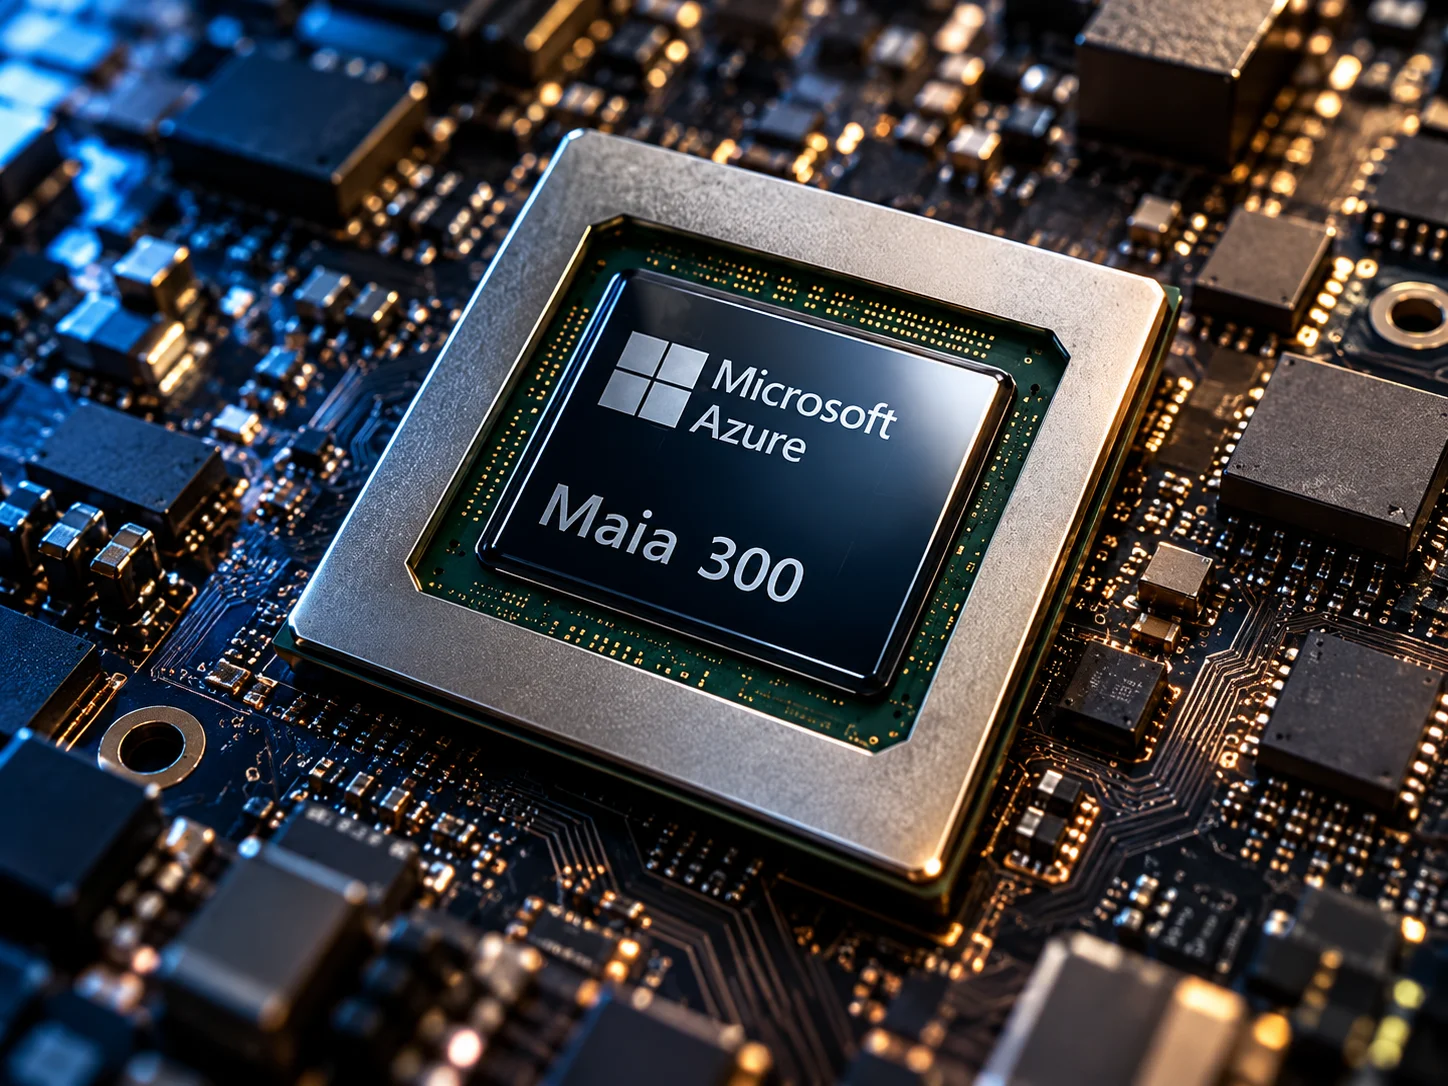
Microsoft presentó este lunes (12) el Maia 300, la tercera generación de sus aceleradores propios de inteligencia artificial. Desarrollado para ejecutar modelos de IA a gran escala, el sistema comenzará a desplegarse en producción en 2027, con la meta de convertirse en la principal infraestructura de inferencia de los productos y servicios de la compañía.
El proyecto reúne 96 aceleradores por rack, con un consumo energético previsto de hasta 167 kW y capacidad conjunta de 27,6 TB de memoria HBM. La configuración también ofrece un ancho de banda agregado de 1,7 PB/s, destinado al procesamiento simultáneo de grandes volúmenes de información.
El Maia 300 fue diseñado especialmente para inferencia, etapa en la que los modelos de inteligencia artificial generan respuestas y ejecutan tareas. Su arquitectura prioriza aplicaciones que exigen contextos extensos, respuestas con baja latencia y agentes capaces de realizar operaciones en múltiples etapas.
Según Reuters, Microsoft considera desplegar más de un millón de chips Maia 300 en 2027. La compañía confirmó planes de expandir su infraestructura Maia a instalaciones con capacidad energética de múltiples gigavatios a partir del próximo año, pero no estableció públicamente el millón de unidades como compromiso definitivo.
Maia 300 promete 40% más tokens por megavatio, pero aún no opera en producción
La principal apuesta de Microsoft está en la eficiencia energética. La empresa estima que el Maia 300 pueda procesar 40% más tokens por megavatio que los sistemas líderes basados en GPUs. En una configuración completa, también afirma que el rendimiento podrá alcanzar hasta siete veces el volumen de tokens por rack del Maia 200.
Esas comparaciones, sin embargo, aún no representan resultados operativos independientes. Microsoft no identificó públicamente qué sistemas competidores se utilizaron como referencia para la ventaja del 40%, y el Maia 300 permanece fuera de producción.
La diferencia entre capacidad proyectada y rendimiento efectivo es relevante porque las cifras divulgadas dependen tanto de los aceleradores como de la memoria, de la comunicación entre chips y de los modelos ejecutados.
En la arquitectura presentada, cada acelerador utiliza ocho módulos de memoria HBM4, con un ancho de banda máximo anunciado de 18 TB/s y un límite térmico de diseño de 950 vatios. Los componentes de procesamiento se fabrican con tecnología N2P de TSMC, mientras que diferentes funciones se distribuyen entre chips especializados.
A escala de rack, los 96 aceleradores se organizan en 24 módulos con cuatro unidades cada uno, duplicando la densidad de aceleradores respecto al Maia 200.
La generación anterior ya ejecuta cargas reales de productos como Microsoft Copilot, además de modelos de OpenAI y de la propia Microsoft. Su expansión también contempla GitHub Copilot y Microsoft Foundry, previstos para recibir soporte hasta finales de 2026.
El despliegue del Maia 300 comenzará en 2027, pero la empresa aún no ha divulgado un cronograma detallado de expansión por región ni resultados públicos de operación a gran escala de la nueva generación.