La firma china Z.AI lanzó este viernes (18) el GLM-5.3-FlashX, nueva versión de su familia de modelos orientada a aplicaciones que exigen menor latencia. El modelo ya está disponible vía API y alcanza hasta 200 tokens por segundo, según la documentación oficial de la empresa.
El FlashX entrega una velocidad de inferencia cinco veces mayor que la del GLM-5.3-Flash, pero llega con un precio 2,5 veces superior al de la versión original, de acuerdo con información divulgada por la compañía y replicada este viernes por medios chinos.
La propuesta es ofrecer una alternativa para desarrolladores que priorizan la velocidad de respuesta, especialmente en agentes de IA, aplicaciones interactivas y servicios en los que la latencia tiene un impacto directo en la experiencia del usuario.
FlashX cambia menor costo por mayor velocidad
En la documentación para desarrolladores, Z.AI enumera los códigos glm-5.3-flash y glm-5.3-flashx para el acceso vía API. Sin embargo, el FlashX aún no está disponible en el GLM Coding Plan, suscripción de la empresa orientada al uso de los modelos en herramientas de programación.
La familia GLM-5.3-Flash/FlashX ofrece una ventana de contexto de 1 millón de tokens y admite salidas de hasta 128 mil tokens. El modelo acepta texto, imágenes, video y archivos como entrada, mientras que la salida es textual.
El GLM-5.3-Flash tiene 320 mil millones de parámetros en total, con 18 mil millones activados, y utiliza una arquitectura híbrida que combina atención dispersa y lineal. Según Z.AI, este diseño reduce el costo computacional de la atención y el tamaño del caché KV en comparación con el GLM-5.3.
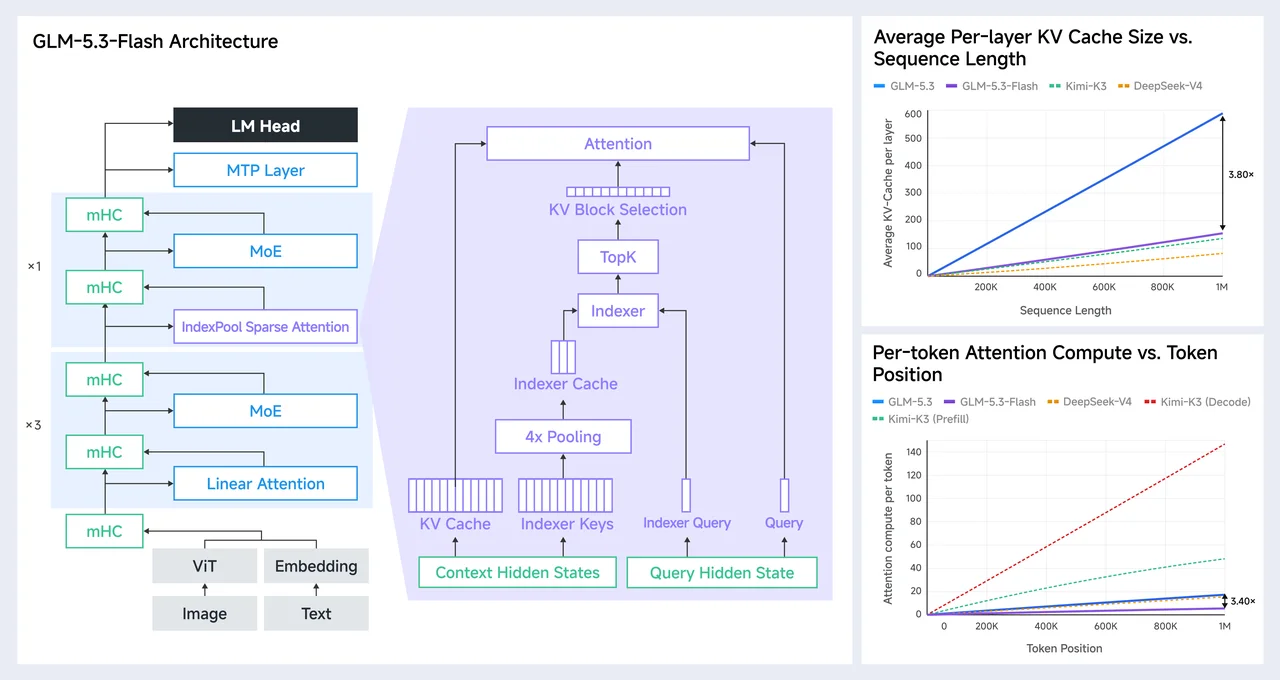
El lanzamiento del FlashX ocurre en medio del aumento de la demanda de la versión Flash. Z.AI afirma haber ampliado su capacidad de cómputo para absorber el crecimiento de las llamadas, mientras medios chinos reportan que el clúster utilizado por la compañía, formado por cerca de 100 mil aceleradores producidos en China, alcanzó rápidamente una alta utilización tras el estreno del modelo.
Con la nueva variante, Z.AI separa ahora con mayor claridad dos prioridades: el GLM-5.3-Flash mantiene el foco en el costo, mientras que el FlashX ofrece mayor velocidad de generación para aplicaciones dispuestas a pagar más por un menor tiempo de respuesta.