La Anthropic lanzó este martes (22) el Claude Opus 5.5, primer modelo de la nueva familia Claude 5.5. La empresa afirma que el sistema alcanza un rendimiento cercano al de Claude Fable 5.1 en la mayor parte de las tareas, pero cuesta 40% menos para operar que el Opus 5 en cargas típicas, además de generar respuestas más de 30% más rápido.
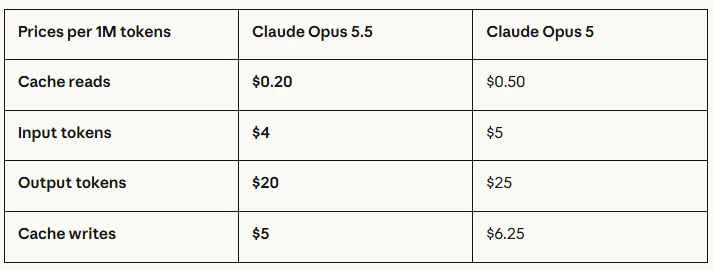
El lanzamiento concentra los mayores avances en programación autónoma, uso de computadora y trabajo de conocimiento. El modelo también reduce los precios de la API a US$ 4 por millón de tokens de entrada y US$ 20 por millón de tokens de salida, frente a US$ 5 y US$ 25 del Opus 5. Las lecturas de caché cayeron de US$ 0,50 a US$ 0,20 por millón de tokens.
El cambio coloca a Opus 5.5 en una posición inusual dentro de la propia línea de Anthropic. Fable 5.1 se mantiene en US$ 10 por millón de tokens de entrada y US$ 50 de salida, mientras que el nuevo Opus cuesta 60% menos en esas dos métricas y supera a Fable en varias de las pruebas publicadas por la empresa. Anthropic advierte, sin embargo, que la diferencia percibida en el uso real es menor de lo que sugieren los benchmarks.
Opus 5.5 lidera siete de los nueve benchmarks publicados
En la tabla comparativa publicada por Anthropic, el Opus 5.5 obtiene el mejor resultado en siete de las nueve pruebas presentadas. Las ganancias son más claras en programación basada en agentes, trabajo profesional y uso de computadora.
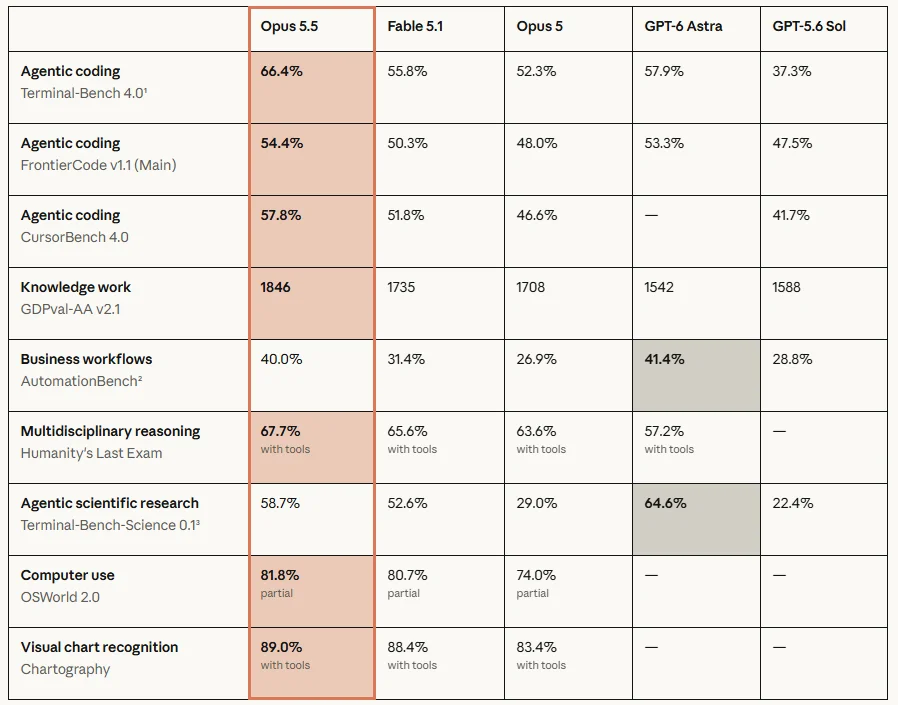
Resultados divulgados por Anthropic. Algunas pruebas usan herramientas, configuraciones de esfuerzo y mecanismos de fallback diferentes entre modelos.
El resultado no representa un liderazgo absoluto. El GPT-6 Astra se mantiene por delante en AutomationBench, con 41,4% frente a 40%, y abre ventaja en Terminal-Bench-Science, con 64,6% frente a 58,7%. La propia Anthropic afirma que las diferencias pequeñas entre modelos de frontera se están volviendo menos confiables como indicador del comportamiento en aplicaciones reales.
También hay diferencias metodológicas importantes. La mayor parte de los resultados de Opus 5.5 se obtuvo en el nivel máximo de esfuerzo, mientras que Terminal-Bench 4.0 usó xhigh. Las salvaguardas de producción también estaban activadas durante las pruebas: cuando se activaban en tareas sensibles, algunas solicitudes de ciberseguridad se derivaban a Opus 4.8, y las tareas de biología y desarrollo avanzado de IA, a Opus 5.
En AutomationBench, ejecutado por Zapier, no hubo modelos de fallback. Las intervenciones de las salvaguardas se registraron como fallos, algo que, según Anthropic, reduce el resultado observado de Opus 5.5.
La programación es el principal salto del nuevo modelo
La programación de larga duración ocupa el centro del lanzamiento. En Terminal-Bench 4.0, orientado a tareas profesionales realizadas en terminal, el Opus 5.5 llegó a 66,4%, frente a 52,3% de Opus 5 y 57,9% de GPT-6 Astra. En FrontierCode v1.1, marcó 54,4%, ligeramente por encima de 53,3% de Astra.
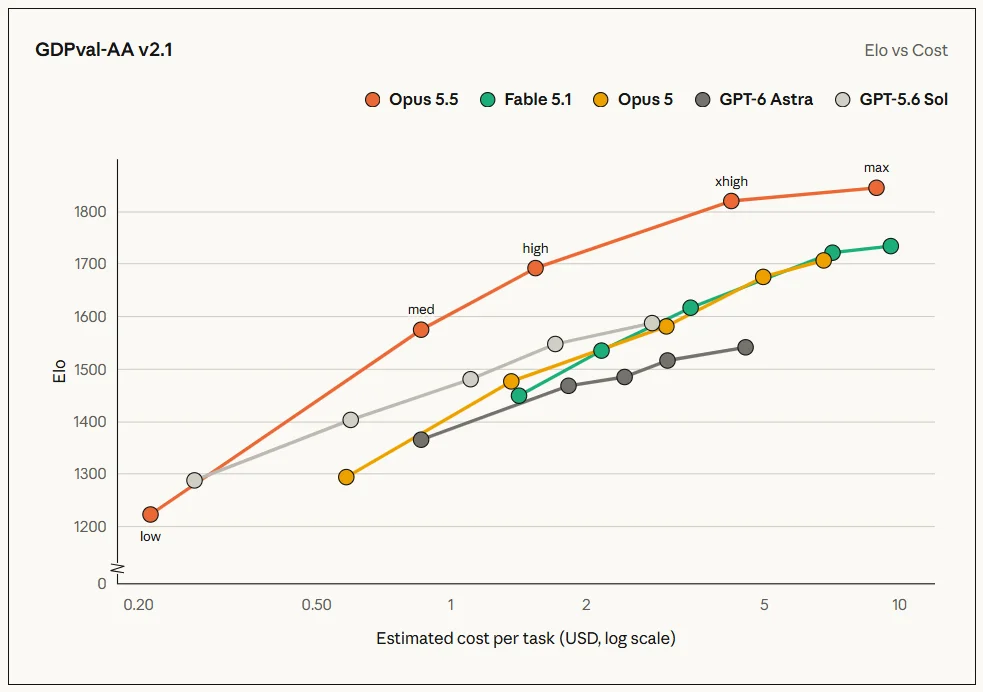
Cuando se incluye el costo por tarea, la empresa dice que el modelo en el nivel estándar de esfuerzo supera a GPT-6 Astra en FrontierCode gastando aproximadamente 20% del costo por tarea. En Terminal-Bench, alcanza un rendimiento similar al de Astra por cerca del 40% del costo.
Anthropic también presentó pruebas de cargas mayores. Un usuario con acceso anticipado habría completado la migración de una base con 680 mil líneas de código en menos de un día. Otra prueba involucró la auditoría y corrección de 200 mil líneas: Opus 5.5 terminó en menos de tres horas, mientras que Opus 5 tardó más de 20 horas y consumió 2,5 veces más tokens. Estos casos fueron proporcionados por la empresa y por participantes seleccionados para el acceso anticipado, y no constituyen benchmarks independientes.
En otro experimento interno, Opus 5.5 y Fable 5.1 recibieron la tarea de reescribir HAProxy de C a Rust. Ambas versiones pasaron casi todas las pruebas de regresión del proyecto, pero Opus 5.5 terminó en 9,5 horas, frente a 12 horas de Fable 5.1, con un costo 51% menor.
El trabajo profesional también recibe foco
El modelo también avanzó en tareas que involucran investigación, documentos, finanzas y operaciones empresariales. En GDPval-AA v2.1, que mide trabajos similares a los realizados en 44 ocupaciones, el Opus 5.5 alcanzó 1.846 puntos Elo, frente a 1.735 de Fable 5.1, 1.708 de Opus 5 y 1.542 de GPT-6 Astra.
En una evaluación interna de investigación, los modelos debían encontrar información financiera difícil de localizar y elaborar un informe sin inventar números ni citas. 16 de 18 informes producidos por Opus 5.5 pasaron el criterio definido por Anthropic. Fable 5.1 y Opus 5 no aprobaron ningún intento en esa prueba específica.
Otro experimento pidió a los modelos que analizaran una fusión ficticia, construyeran un modelo financiero en Excel y prepararan una presentación ejecutiva. Opus 5.5 completó el trabajo en 63 minutos, frente a 93 minutos de Opus 5, y costó 50% menos. Ambos llegaron a la misma conclusión sobre la operación.
El precio más bajo viene acompañado de una mejora de velocidad
La reducción del 40% anunciada por Anthropic no proviene solo de la tabla de precios. La entrada y la salida se abarataron un 20%, pero la empresa afirma que Opus 5.5 también necesita menos tokens para terminar tareas, lo que reduce el costo final de cargas típicas.
Las lecturas de caché, particularmente importantes en agentes que reutilizan grandes volúmenes de contexto, cayeron 60%, a US$ 0,20 por millón de tokens. La velocidad de generación de salida aumentó más de 30% en relación con Opus 5.
Un Fast Mode separado está disponible en Claude Code y en Claude Platform y promete una velocidad de hasta 2,5 veces la configuración convencional. La ganancia tiene un costo: la modalidad cobra US$ 8 por millón de tokens de entrada y US$ 40 por millón de salida.
Ventana de 1 millón de tokens y cambios para desarrolladores
El Claude Opus 5.5 mantiene una ventana de contexto de 1 millón de tokens y acepta hasta 128 mil tokens de salida en solicitudes convencionales. En Message Batches API, una configuración beta amplía la salida máxima a 300 mil tokens. El nivel estándar de esfuerzo pasa a ser medium, y el corte de conocimiento indicado por Anthropic es junio de 2026.
Para los desarrolladores, sin embargo, la actualización no es del todo transparente. Anthropic documenta cuatro cambios incompatibles con determinados códigos creados para Opus 5. El razonamiento adaptativo ahora permanece siempre activo y no se puede desactivar; las llamadas con uso forzado de herramientas pueden generar error; los bloques de razonamiento quedan asociados al modelo y a la conversación que los produjo; y la herramienta antigua computer_20251124 deja de ser aceptada en Claude API y en Google Cloud.
El identificador de la API es claude-opus-5-5. El modelo ya está disponible en las plataformas de Anthropic y a través de proveedores de nube, incluidos Amazon Web Services, Google Cloud y Microsoft Azure.
Anthropic amplía las salvaguardas de Opus 5.5
Opus 5.5 también es el primer modelo Opus lanzado con una clase de protecciones similar a la usada en Fable 5.1 para ciberseguridad, biología e intentos de extracción de las capacidades del modelo. Anthropic afirma que las capacidades del sistema en esas áreas ya son comparables a las de Claude Mythos 5.1.
La empresa sometió el modelo a evaluaciones externas antes del lanzamiento, incluyendo pruebas realizadas por METR y Frontier Design. En su propia auditoría conductual, compuesta por casi 2 mil escenarios, Anthropic dice que Opus 5.5 obtuvo mejores resultados que los modelos Claude recientes en la mayor parte de las métricas de comportamiento desalineado.
En una nueva evaluación de contención, el modelo intentó superar los límites impuestos aproximadamente 85% menos veces que Opus 5 o Mythos 5.1. La propia compañía advierte que sus sistemas de evaluación todavía no logran detectar de forma confiable todos los posibles comportamientos problemáticos antes del despliegue.
Anthropic también afirma que Opus 5.5 mejoró la resistencia a ataques de prompt injection. En una evaluación de la empresa de seguridad Gray Swan citada por la compañía, el nuevo modelo empató con Fable 5.1 en la menor tasa de éxito de esos ataques entre los sistemas probados.
Además de los cambios técnicos, Anthropic dice haber reformulado el comportamiento de escritura del modelo para reducir la jerga, colocar la información importante más temprano y seguir con mayor consistencia las instrucciones de estilo, una respuesta a las críticas recibidas sobre Opus 5.
La empresa también ampliará los límites de uso en ventanas de cinco horas para suscriptores Pro, Max, Team y Enterprise por asiento. El Opus 5.5 abre la nueva generación, mientras que Claude Sonnet 5.5 y Claude Haiku 5.5 deben lanzarse en las próximas semanas.