A Anthropic lançou nesta terça-feira (22) o Claude Opus 5.5, primeiro modelo da nova família Claude 5.5. A empresa afirma que o sistema alcança desempenho próximo ao Claude Fable 5.1 na maior parte das tarefas, mas custa 40% menos para operar que o Opus 5 em cargas típicas, além de gerar respostas mais de 30% mais rápido.
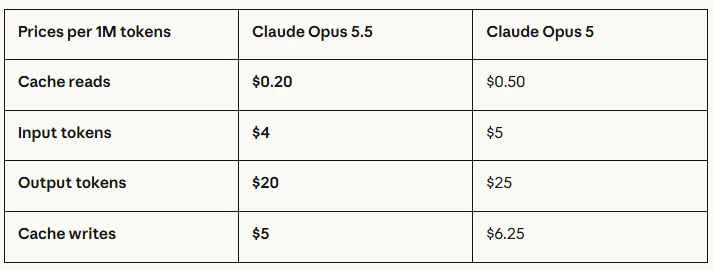
O lançamento concentra os maiores avanços em programação autônoma, uso de computador e trabalho de conhecimento. O modelo também reduz os preços da API para US$ 4 por milhão de tokens de entrada e US$ 20 por milhão de tokens de saída, contra US$ 5 e US$ 25 do Opus 5. Leituras de cache caíram de US$ 0,50 para US$ 0,20 por milhão de tokens.
A mudança coloca o Opus 5.5 em uma posição incomum dentro da própria linha da Anthropic. O Fable 5.1 permanece tabelado a US$ 10 por milhão de tokens de entrada e US$ 50 de saída, enquanto o novo Opus custa 60% menos nessas duas métricas e supera o Fable em vários dos testes publicados pela empresa. A Anthropic ressalva, porém, que a diferença percebida no uso real é menor do que os benchmarks sugerem.
Opus 5.5 lidera sete dos nove benchmarks divulgados
Na tabela comparativa publicada pela Anthropic, o Opus 5.5 obtém o melhor resultado em sete dos nove testes apresentados. Os ganhos são mais claros em programação baseada em agentes, trabalho profissional e uso de computador.
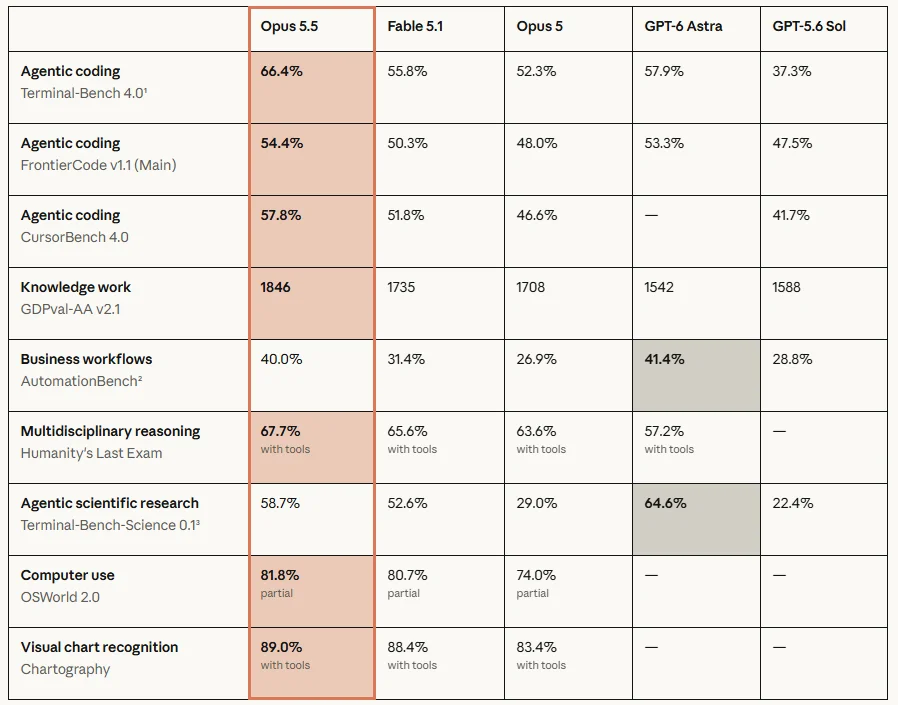
Resultados divulgados pela Anthropic. Alguns testes usam ferramentas, configurações de esforço e mecanismos de fallback diferentes entre modelos.
O resultado não representa uma liderança absoluta. O GPT-6 Astra permanece à frente no AutomationBench, com 41,4% contra 40%, e abre vantagem no Terminal-Bench-Science, com 64,6% contra 58,7%. A própria Anthropic afirma que diferenças pequenas entre modelos de fronteira estão se tornando menos confiáveis como indicador do comportamento em aplicações reais.
Há ainda diferenças metodológicas importantes. A maior parte dos resultados do Opus 5.5 foi obtida no nível máximo de esforço, enquanto o Terminal-Bench 4.0 usou xhigh. As salvaguardas de produção também estavam ligadas durante os testes: quando acionadas em tarefas sensíveis, algumas solicitações de cibersegurança foram encaminhadas ao Opus 4.8, e tarefas de biologia e desenvolvimento avançado de IA ao Opus 5.
No AutomationBench, executado pela Zapier, não houve modelos de fallback. Intervenções das salvaguardas foram registradas como falhas, algo que, segundo a Anthropic, reduz o resultado observado do Opus 5.5.
Programação é o principal salto do novo modelo
A programação de longa duração ocupa o centro do lançamento. No Terminal-Bench 4.0, voltado a tarefas profissionais realizadas em terminal, o Opus 5.5 chegou a 66,4%, contra 52,3% do Opus 5 e 57,9% do GPT-6 Astra. No FrontierCode v1.1, marcou 54,4%, ligeiramente acima dos 53,3% do Astra.
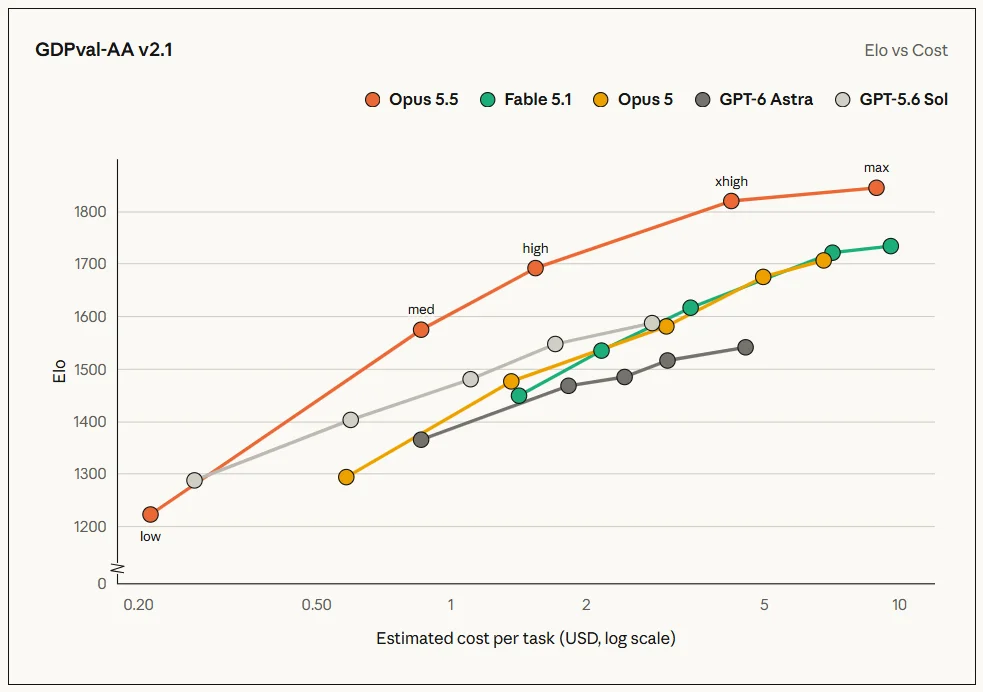
Quando o custo por tarefa é incluído, a empresa diz que o modelo no nível padrão de esforço supera o GPT-6 Astra no FrontierCode gastando aproximadamente 20% do custo por tarefa. No Terminal-Bench, alcança desempenho semelhante ao Astra por cerca de 40% do custo.
A Anthropic também apresentou testes de cargas maiores. Um usuário em acesso antecipado teria concluído a migração de uma base com 680 mil linhas de código em menos de um dia. Outro teste envolveu auditoria e correção de 200 mil linhas: o Opus 5.5 terminou em menos de três horas, enquanto o Opus 5 levou mais de 20 horas e consumiu 2,5 vezes mais tokens. Esses casos foram fornecidos pela empresa e por participantes escolhidos para o acesso antecipado, e não constituem benchmarks independentes.
Em outro experimento interno, Opus 5.5 e Fable 5.1 receberam a tarefa de reescrever o HAProxy de C para Rust. As duas versões passaram em quase todos os testes de regressão do projeto, mas o Opus 5.5 terminou em 9,5 horas, ante 12 horas do Fable 5.1, com custo 51% menor.
Trabalho profissional também recebe foco
O modelo também avançou em tarefas que envolvem pesquisa, documentos, finanças e operações empresariais. No GDPval-AA v2.1, que mede trabalhos próximos aos realizados em 44 ocupações, o Opus 5.5 alcançou 1.846 pontos Elo, contra 1.735 do Fable 5.1, 1.708 do Opus 5 e 1.542 do GPT-6 Astra.
Em uma avaliação interna de pesquisa, os modelos precisavam encontrar informações financeiras difíceis de localizar e elaborar um relatório sem inventar números ou citações. 16 de 18 relatórios produzidos pelo Opus 5.5 passaram pelo critério definido pela Anthropic. Fable 5.1 e Opus 5 não passaram em nenhuma tentativa nesse teste específico.
Outro experimento pediu aos modelos que analisassem uma fusão fictícia, construíssem um modelo financeiro em Excel e preparassem uma apresentação executiva. Opus 5.5 completou o trabalho em 63 minutos, contra 93 minutos do Opus 5, e custou 50% menos. Os dois chegaram à mesma conclusão sobre a operação.
Preço menor vem acompanhado de ganho de velocidade
A redução de 40% anunciada pela Anthropic não vem apenas da tabela de preços. Entrada e saída ficaram 20% mais baratas, mas a empresa afirma que o Opus 5.5 também necessita de menos tokens para terminar tarefas, diminuindo o custo final de cargas típicas.
As leituras de cache, particularmente importantes em agentes que reutilizam grandes volumes de contexto, caíram 60%, para US$ 0,20 por milhão de tokens. A velocidade de geração de saída aumentou mais de 30% em relação ao Opus 5.
Um Fast Mode separado está disponível no Claude Code e na Claude Platform e promete velocidade de até 2,5 vezes a configuração convencional. O ganho tem custo: a modalidade cobra US$ 8 por milhão de tokens de entrada e US$ 40 por milhão de saída.
Janela de 1 milhão de tokens e mudanças para desenvolvedores
O Claude Opus 5.5 mantém uma janela de contexto de 1 milhão de tokens e aceita até 128 mil tokens de saída em requisições convencionais. Na Message Batches API, uma configuração beta amplia a saída máxima para 300 mil tokens. O nível padrão de esforço passa a ser medium, e o corte de conhecimento indicado pela Anthropic é junho de 2026.
Para desenvolvedores, porém, a atualização não é inteiramente transparente. A Anthropic documenta quatro mudanças incompatíveis com determinados códigos criados para o Opus 5. O raciocínio adaptativo agora permanece sempre ativo e não pode ser desligado; chamadas com uso forçado de ferramentas podem gerar erro; blocos de raciocínio ficam associados ao modelo e à conversa que os produziu; e a ferramenta antiga computer_20251124 deixa de ser aceita na Claude API e no Google Cloud.
O identificador da API é claude-opus-5-5. O modelo já está disponível nas plataformas da Anthropic e por provedores de nuvem, incluindo Amazon Web Services, Google Cloud e Microsoft Azure.
Anthropic amplia salvaguardas do Opus 5.5
O Opus 5.5 também é o primeiro modelo Opus lançado com uma classe de proteções semelhante à usada no Fable 5.1 para cibersegurança, biologia e tentativas de extração das capacidades do modelo. A Anthropic afirma que as capacidades do sistema nessas áreas já são comparáveis às do Claude Mythos 5.1.
A empresa submeteu o modelo a avaliações externas antes do lançamento, incluindo testes conduzidos por METR e Frontier Design. Em sua própria auditoria comportamental, composta por quase 2 mil cenários, a Anthropic diz que o Opus 5.5 obteve resultados melhores que os modelos Claude recentes na maior parte das métricas de comportamento desalinhado.
Em uma nova avaliação de contenção, o modelo tentou ultrapassar os limites impostos aproximadamente 85% menos vezes que Opus 5 ou Mythos 5.1. A própria companhia ressalva que seus sistemas de avaliação ainda não conseguem detectar de forma confiável todos os possíveis comportamentos problemáticos antes da implantação.
A Anthropic também afirma que o Opus 5.5 melhorou a resistência a ataques de prompt injection. Em uma avaliação da empresa de segurança Gray Swan citada pela companhia, o novo modelo empatou com o Fable 5.1 na menor taxa de sucesso desses ataques entre os sistemas testados.
Além das mudanças técnicas, a Anthropic diz ter reformulado o comportamento de escrita do modelo para reduzir jargão, colocar informações importantes mais cedo e seguir com maior consistência instruções de estilo, uma resposta a críticas recebidas sobre o Opus 5.
A empresa também ampliará os limites de uso em janelas de cinco horas para assinantes Pro, Max, Team e Enterprise por assento. O Opus 5.5 abre a nova geração, enquanto Claude Sonnet 5.5 e Claude Haiku 5.5 devem ser lançados nas próximas semanas.