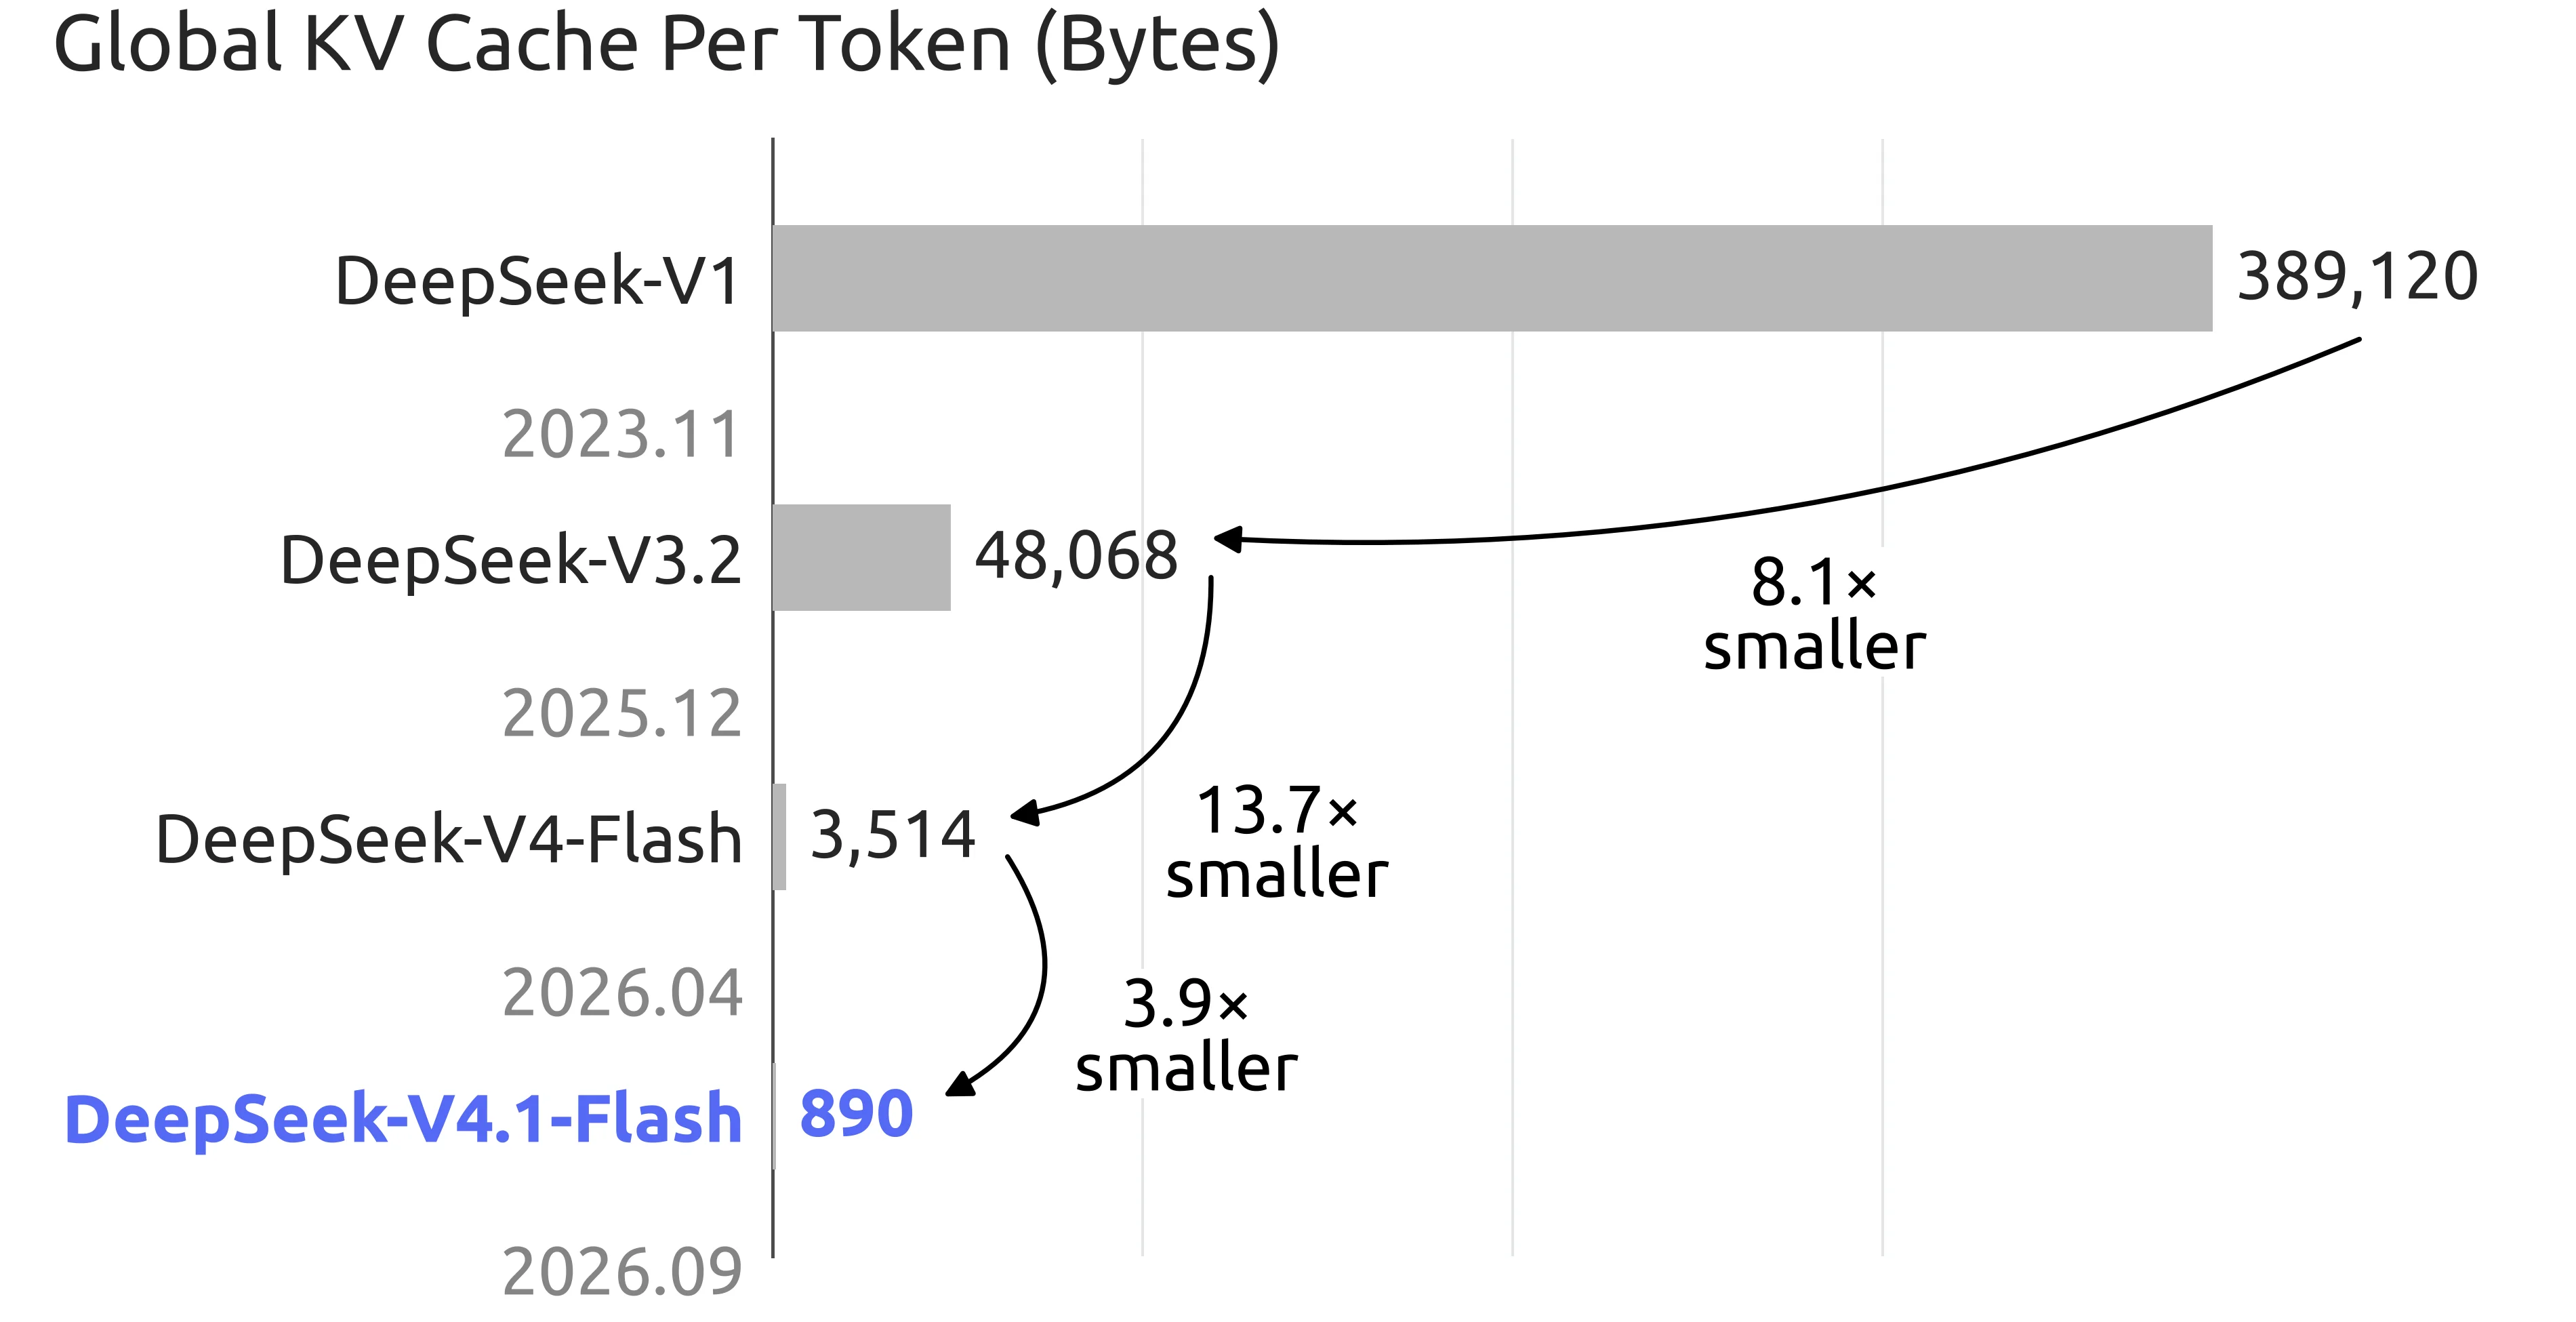
A DeepSeek anunciou o V4.1-Flash, primeiro modelo de uma nova arquitetura da empresa, com desempenho acima do V4-Pro em diferentes benchmarks e uma redução significativa no consumo de memória. O novo modelo exige cerca de um quarto da HBM e um oitavo do armazenamento SSD usados pelo KV cache da geração anterior.
O V4.1-Flash utiliza arquitetura Mixture-of-Experts (MoE) com 552 bilhões de parâmetros, mas ativa apenas 8 bilhões no processamento da entrada e 16 bilhões durante a geração da resposta. A proposta é reduzir o custo computacional sem comprometer o desempenho.
O modelo também traz visão multimodal nativa e suporte a contextos de até 1 milhão de tokens. Segundo a DeepSeek, mudanças no pré-treinamento e no pós-treinamento permitiram ao Flash superar o V4-Pro em diferentes avaliações.
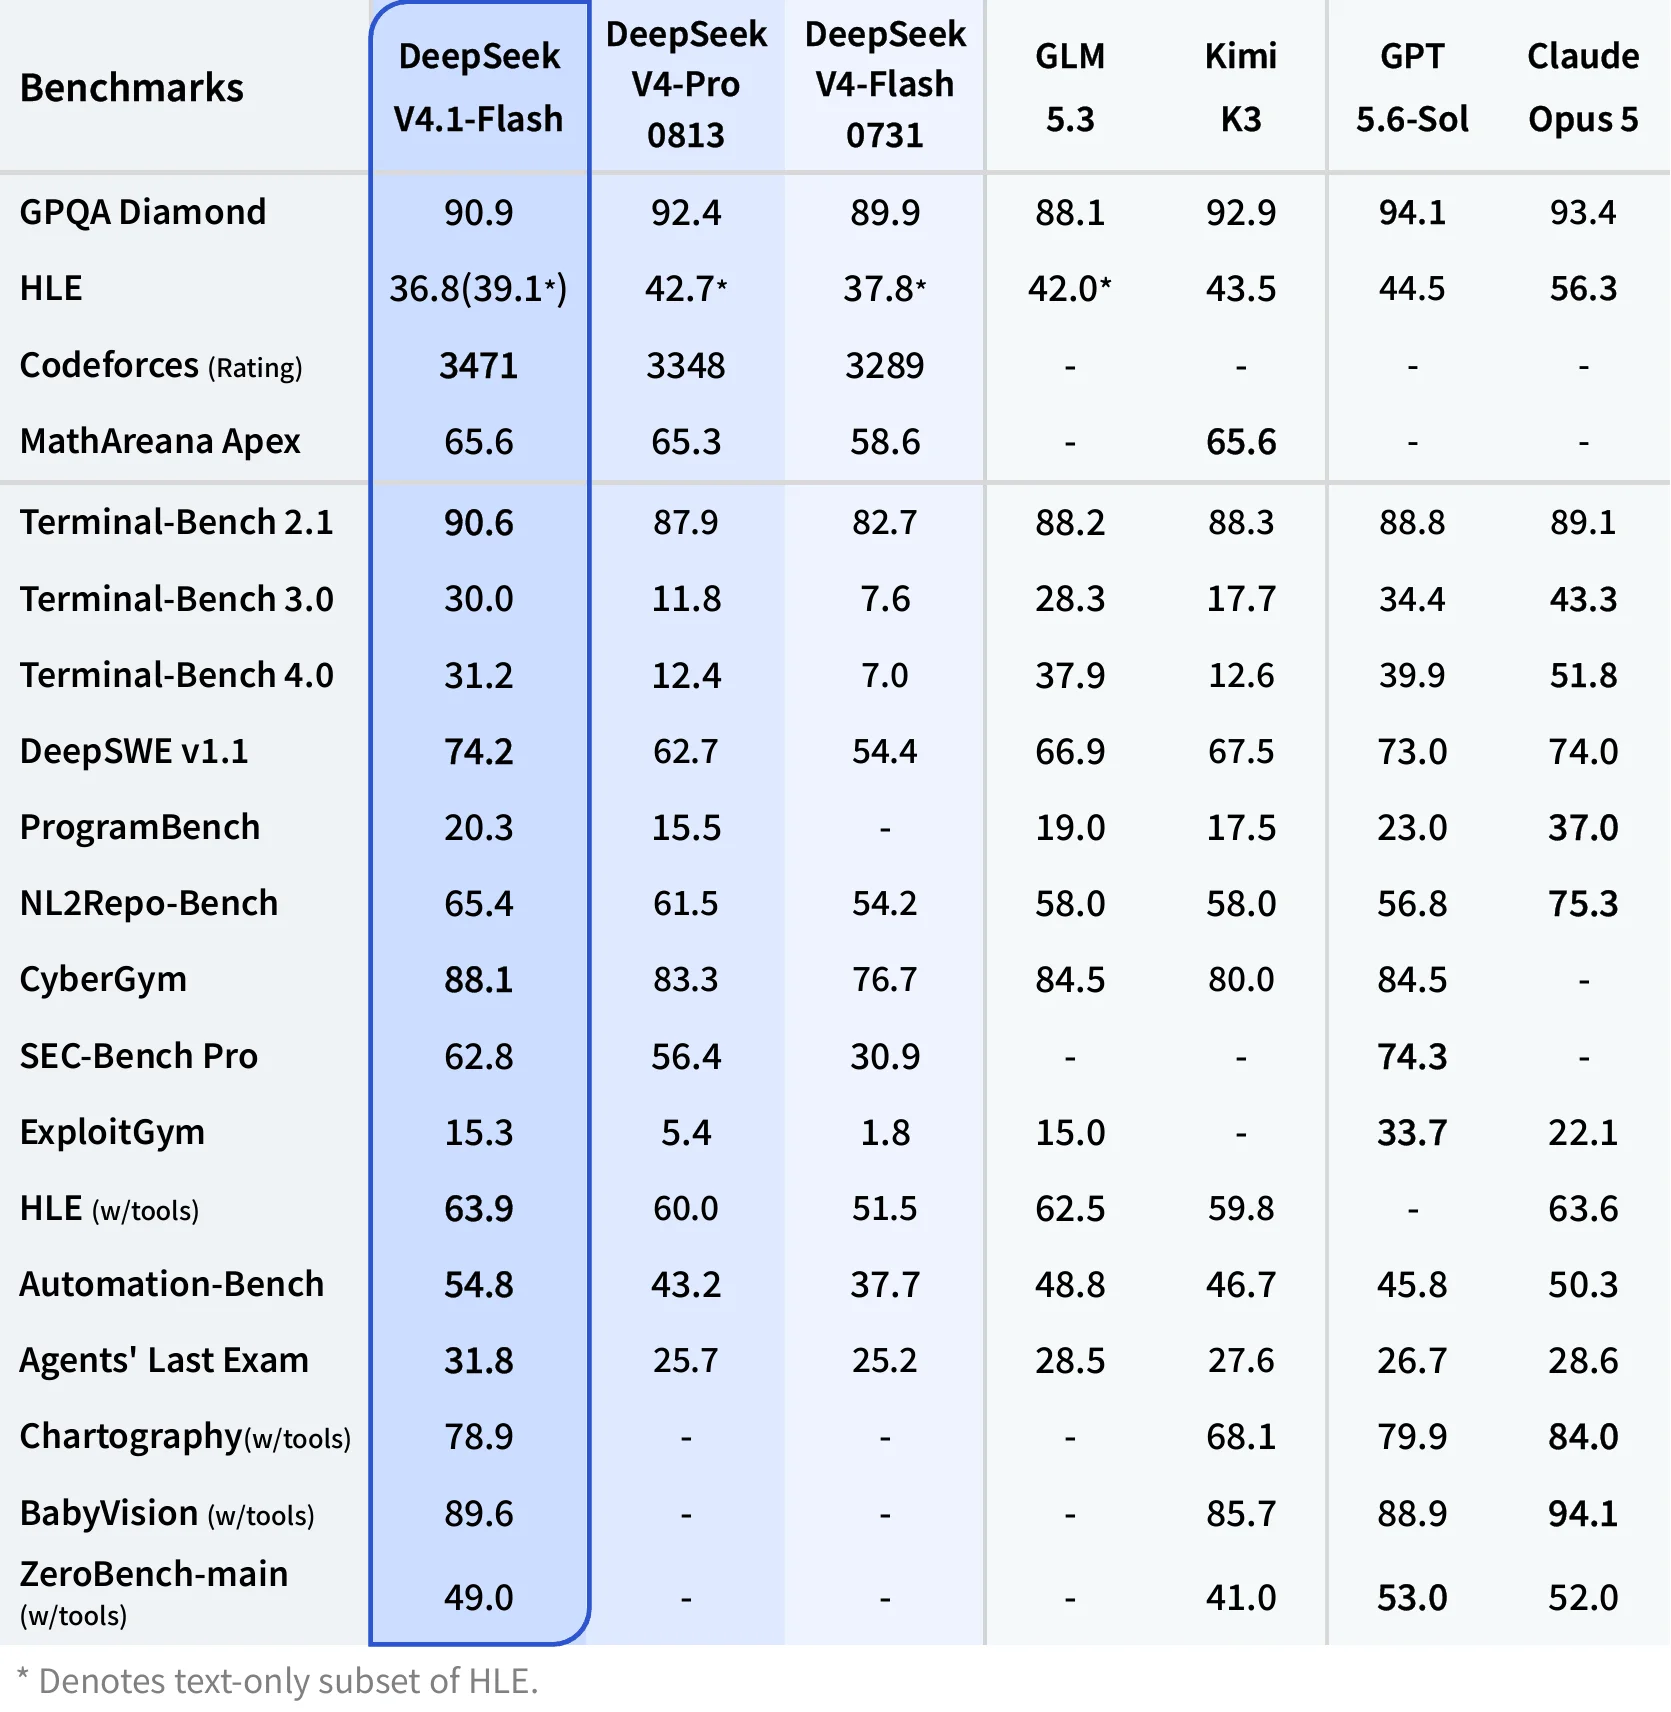
Flash vai substituir temporariamente o V4-Pro
A partir de 14 de setembro, requisições enviadas ao identificador deepseek-v4-pro serão direcionadas ao V4.1-Flash. O redirecionamento continuará até o lançamento do futuro V4.1-Pro.
A decisão coloca o novo Flash temporariamente no lugar do modelo Pro da empresa, mesmo pertencendo a uma linha voltada a maior eficiência.
A nova arquitetura também reduz a quantidade de memória necessária para manter o KV cache, estrutura usada para armazenar o contexto durante a inferência. Esse ganho é especialmente relevante em cargas com grandes volumes de tokens.
A DeepSeek também reduziu os preços da API. O V4.1-Flash já está disponível pelo identificador deepseek-flash, e os pesos do modelo foram liberados para uso fora da infraestrutura da companhia.


