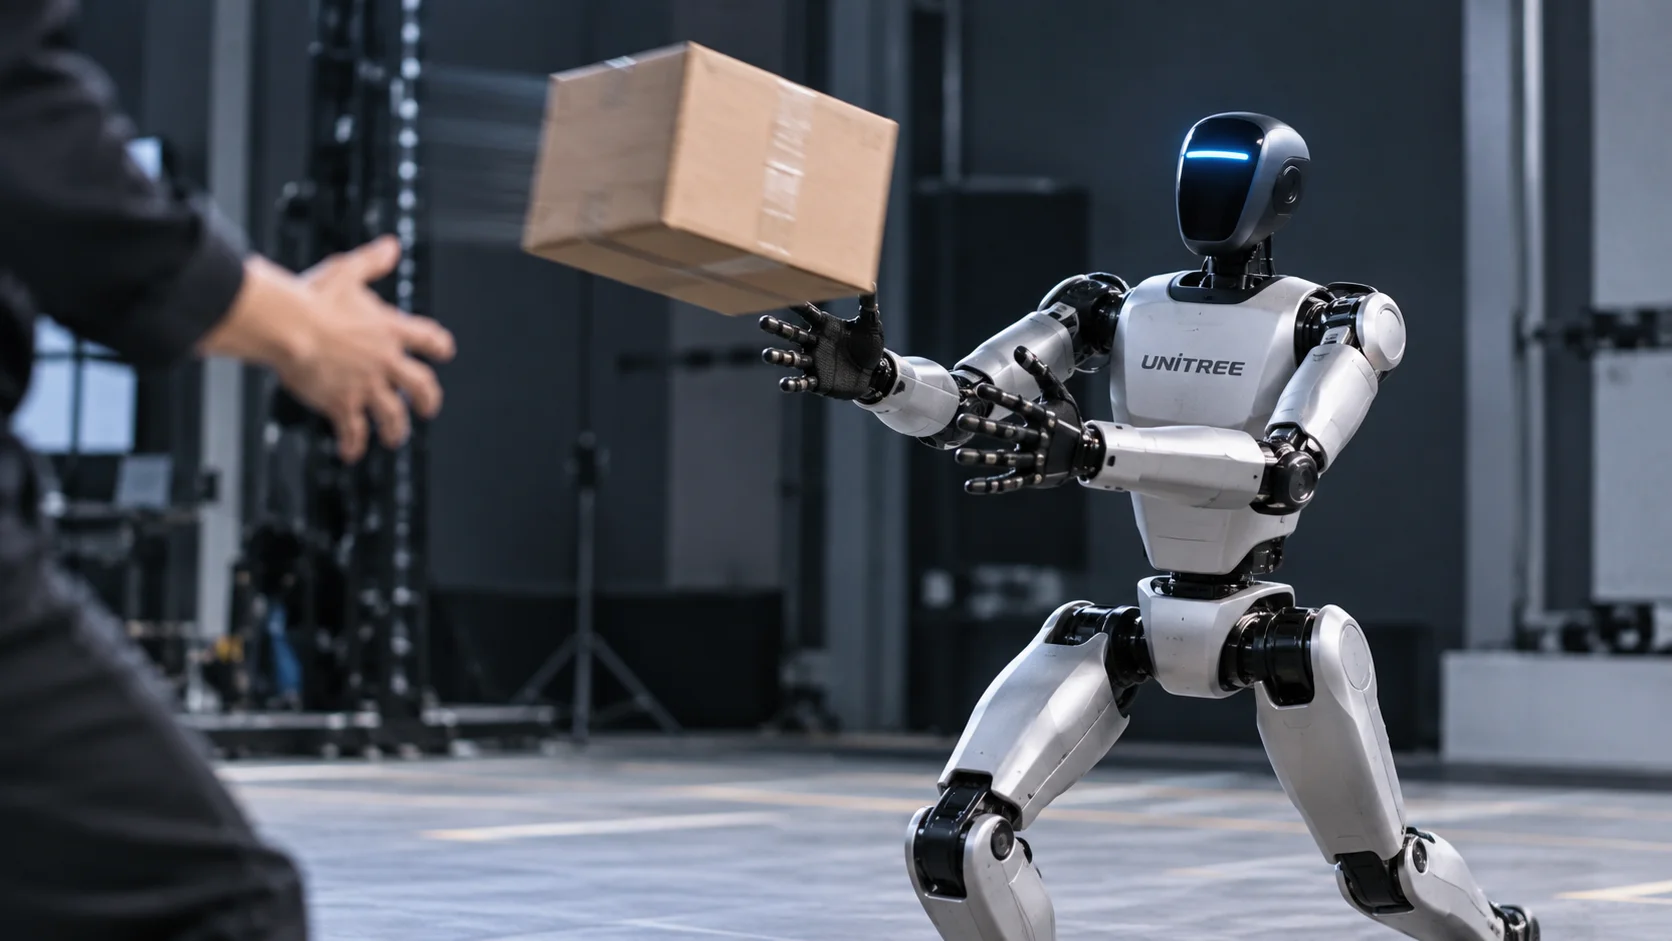
Uma caixa é arremessada na direção de um robô humanoide. Ele tem aproximadamente um segundo para identificar o objeto, prever sua trajetória e movimentar braços, pernas e tronco antes do impacto. Nos experimentos, o Unitree G1 conseguiu capturar 13 de 20 caixas lançadas a 2,5 metros, utilizando apenas sensores instalados no próprio corpo.
A capacidade foi demonstrada pelo Reflex, um sistema de inteligência artificial desenvolvido por pesquisadores de instituições como University of Washington, Stanford University e University of Southern California. O trabalho, disponibilizado no arXiv em 8 de outubro de 2026, investiga como robôs humanoides podem reagir fisicamente a objetos em movimento sem depender de câmeras externas ou sistemas de rastreamento.
O desafio vai além de alcançar uma caixa no ar. Para completar a tarefa, o robô precisa posicionar os antebraços, utilizar o tronco como apoio, absorver o impacto e manter o objeto seguro sem perder o equilíbrio. Encostar na caixa não basta: é necessário capturá-la e sustentá-la.
Robô alcançou 65% de acerto, contra 85% dos participantes humanos
Nos testes físicos, os pesquisadores compararam o desempenho do Unitree G1 com o de três participantes humanos, submetidos a arremessos semelhantes.
A 2,5 metros, o robô registrou 65% de sucesso, contra 85% dos humanos. Quando a distância aumentou para 5 metros, as taxas caíram para 40% e 68,3%, respectivamente.
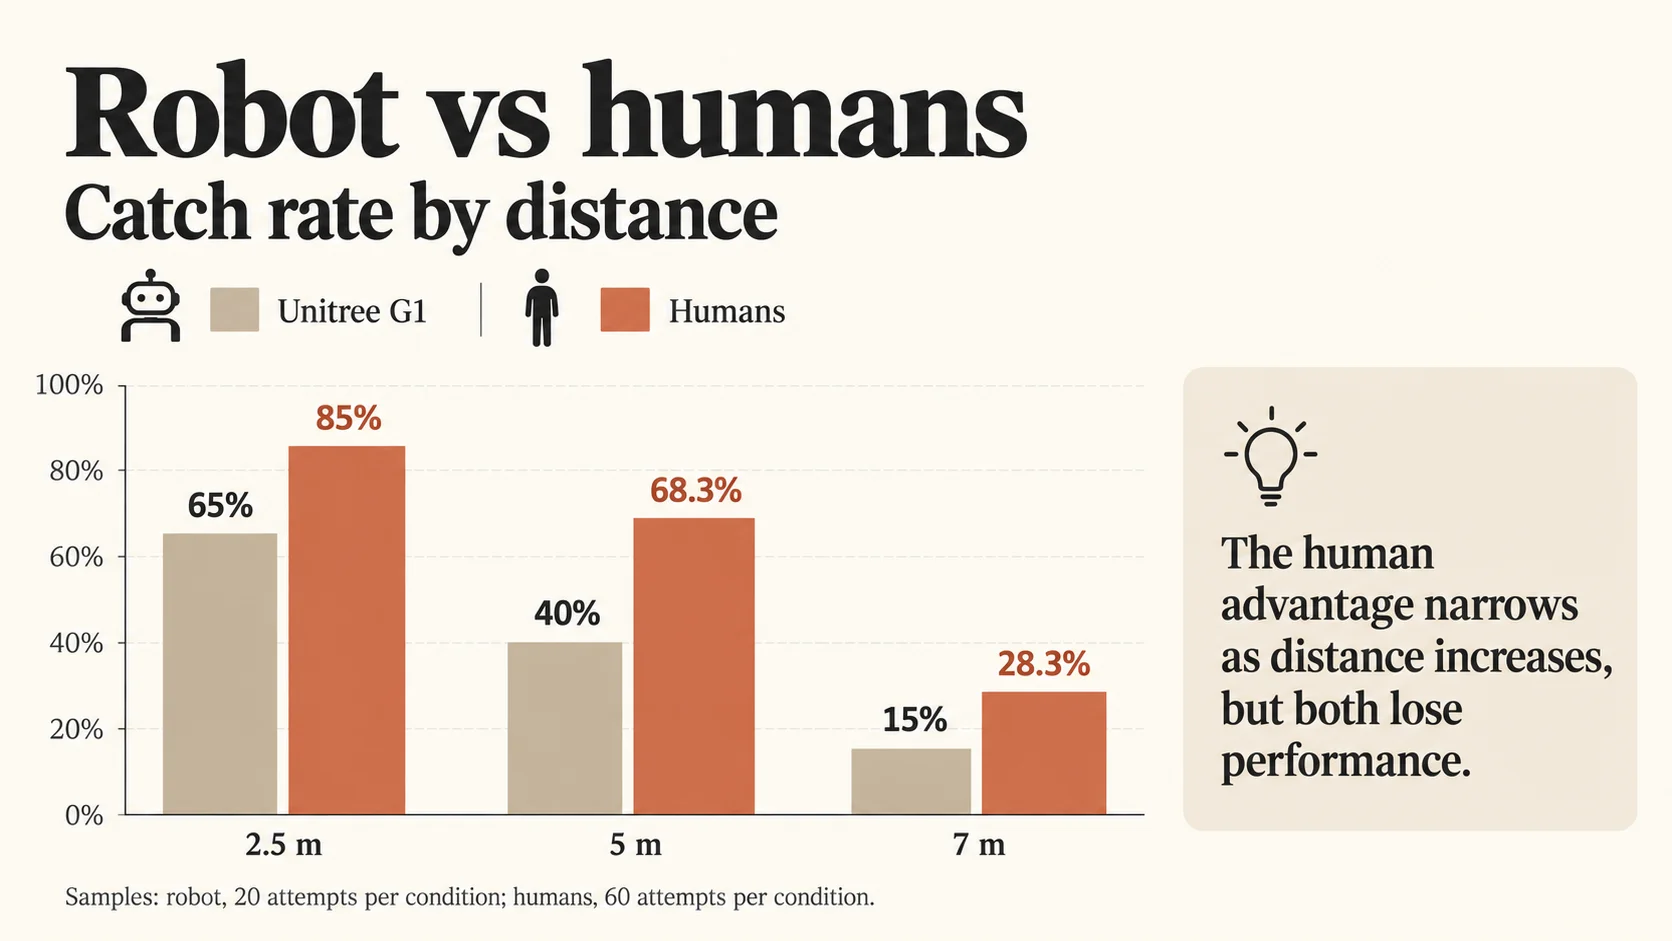
Aos 7 metros, a dificuldade ficou evidente para ambos: o G1 capturou apenas 15% das caixas, enquanto os participantes humanos alcançaram 28,3%.
Cada condição envolveu 20 tentativas com o robô e 60 com os humanos. Os resultados mostram uma capacidade física efetivamente demonstrada, mas ainda distante da consistência humana nas condições avaliadas.
O desempenho também variou conforme as características dos objetos. Nos testes com caixas de diferentes dimensões, o robô conseguiu capturar 20% das menores e 45% das maiores, mesmo alcançando fisicamente algumas que não conseguiu segurar.
Essa diferença revela uma dificuldade importante: interceptar um objeto em movimento não significa necessariamente conseguir retê-lo.
O segredo está em prever o movimento, não apenas enxergar a caixa
A principal contribuição científica do Reflex está na maneira como percepção visual e controle corporal trabalham juntos.
O sistema foi desenvolvido em três etapas. Primeiro, o robô aprendeu movimentos de captura por meio de aprendizado por reforço em simulação, recebendo informações detalhadas sobre a posição da caixa. Depois, foi treinado para lidar com informações incompletas e atrasadas sobre o movimento do objeto.
Na última etapa, os pesquisadores ensinaram um modelo visual a extrair essas informações das imagens produzidas pela câmera do próprio robô, que combina cores e profundidade.
Isso é especialmente difícil porque a câmera fica instalada no tronco. Quando o G1 se movimenta, o cenário também muda de posição nas imagens. Além disso, os próprios braços podem esconder parcialmente a caixa nos instantes anteriores ao contato.
Para superar essas dificuldades, o Reflex considera uma sequência de imagens, permitindo estimar como o objeto se desloca ao longo do tempo.
Um experimento revelou a importância dessa estratégia.
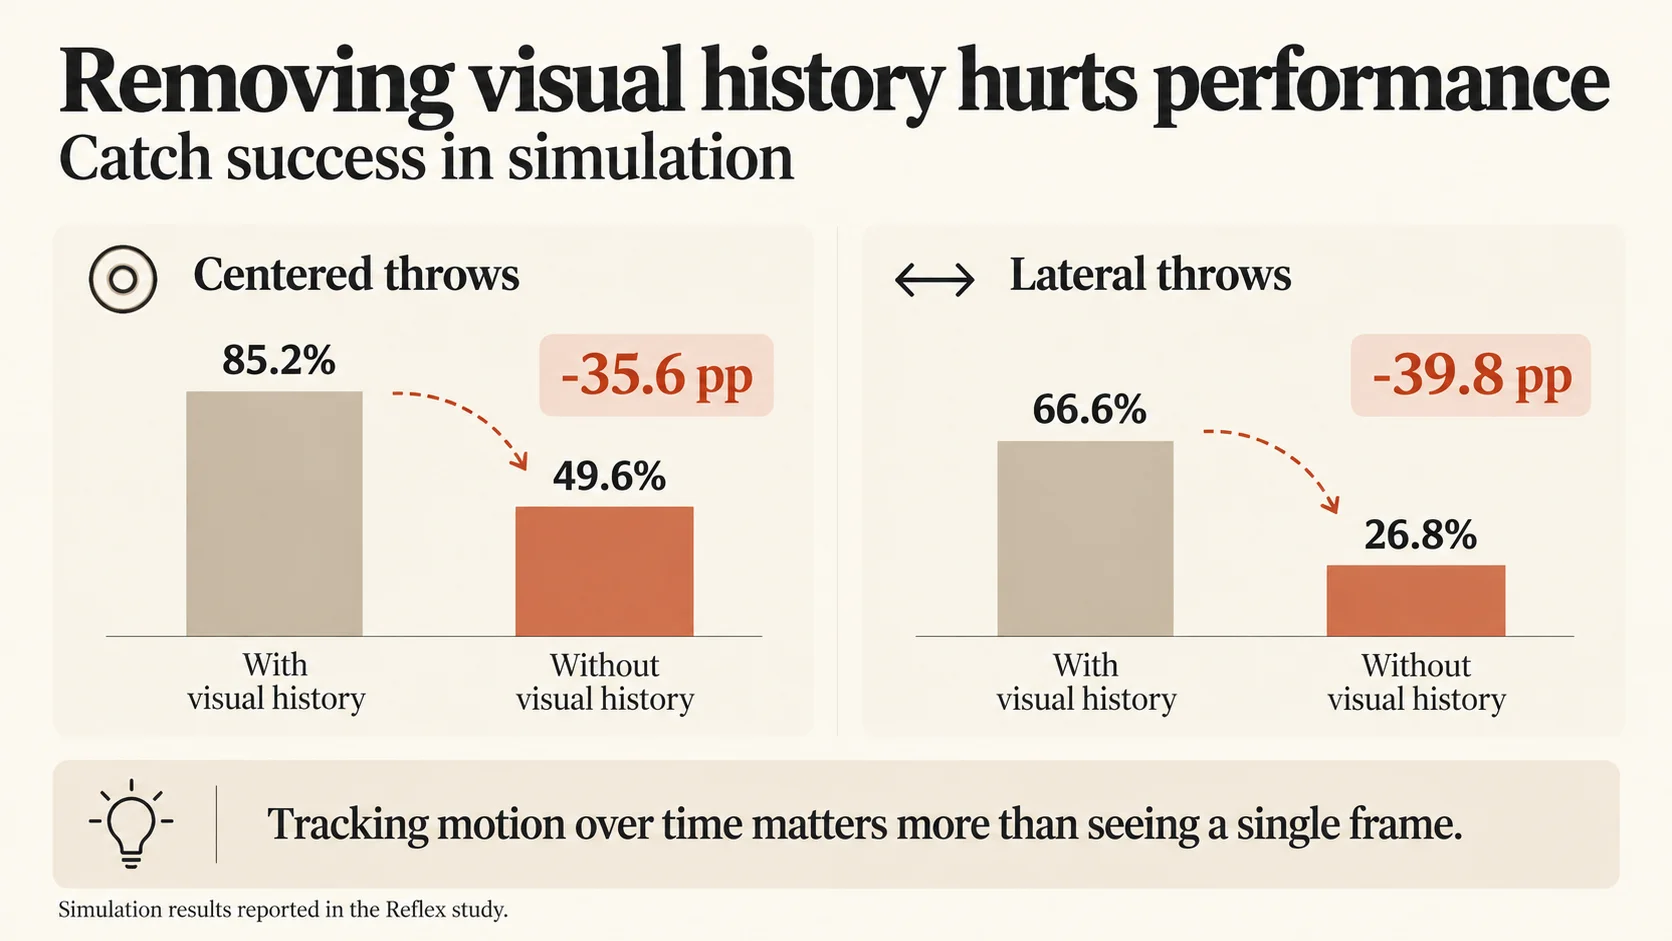
Em simulação, quando os pesquisadores eliminaram o histórico visual e deixaram o sistema trabalhar apenas com uma imagem instantânea, a taxa de captura caiu de 85,2% para 49,6% nos arremessos centralizados.
Nos lançamentos deslocados lateralmente, a queda foi ainda maior: de 66,6% para 26,8%.
São reduções de 35,6 e 39,8 pontos percentuais, respectivamente. O resultado mostra que reconhecer a posição atual da caixa é insuficiente para executar a tarefa com a mesma eficácia. O robô precisa acompanhar seu deslocamento e antecipar onde ocorrerá o contato.
Na avaliação principal em simulação, o sistema completo alcançou 85,7% de sucesso em 3.840 arremessos, desempenho próximo dos 87,9% obtidos por uma configuração que recebia informações privilegiadas sobre o objeto.
A proximidade entre os resultados sugere que o modelo visual conseguiu recuperar grande parte das informações necessárias ao controle corporal. Isso, entretanto, não significa que a mesma precisão tenha sido reproduzida nos testes físicos.
Capturar a caixa é apenas parte do desafio
Os pesquisadores também demonstraram uma sequência mais complexa: o Unitree G1 capturava uma caixa, caminhava carregando o objeto, entregava-o a uma pessoa e retornava à posição inicial.
Para realizar essa sequência, o Reflex foi combinado com outro controlador responsável pela locomoção e pela entrega.
O resultado expôs uma limitação importante. Das 20 tentativas realizadas, apenas cinco completaram todas as etapas, uma taxa de sucesso de 25%.
A pesquisa também apresenta restrições estatísticas. Com apenas 20 tentativas por condição nos experimentos físicos, as taxas observadas apresentam intervalos de incerteza consideráveis, que podem chegar a aproximadamente 20 pontos percentuais para mais ou para menos.
Outra dificuldade está na percepção visual em distâncias maiores. Nos testes simulados, a precisão caiu significativamente com arremessos mais longos e rápidos do que aqueles utilizados no treinamento visual. Ampliar esses dados melhorou os resultados em simulação, mas essa melhoria ainda não foi validada no robô físico.
O trabalho permanece disponível como preprint, sem validação independente identificada.
O Reflex, portanto, não demonstra que humanoides já conseguem manipular objetos arremessados com confiabilidade geral. Seu resultado mais relevante é outro: um robô conseguiu combinar visão própria, previsão de trajetória e movimentos coordenados do corpo inteiro para reagir a um objeto em aproximadamente um segundo, uma capacidade fundamental para interações físicas mais dinâmicas.