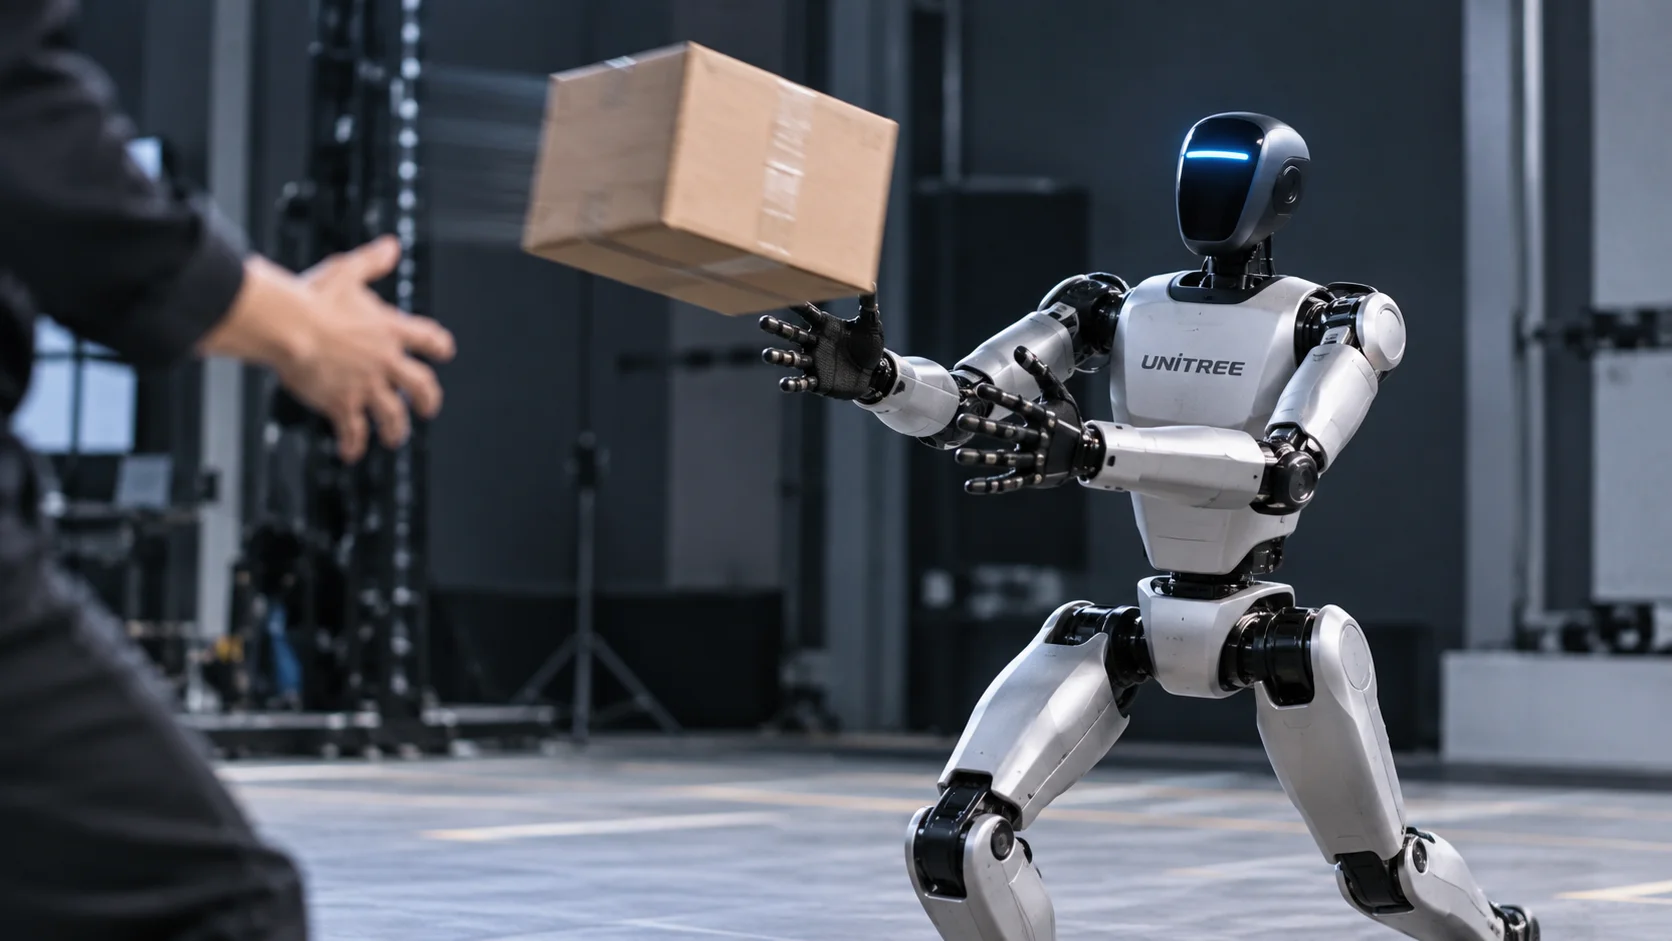
Una caja es lanzada en dirección a un robot humanoide. Este tiene aproximadamente un segundo para identificar el objeto, prever su trayectoria y mover brazos, piernas y tronco antes del impacto. En los experimentos, el Unitree G1 logró capturar 13 de 20 cajas lanzadas a 2,5 metros, utilizando únicamente sensores instalados en su propio cuerpo.
La capacidad fue demostrada por el Reflex, un sistema de inteligencia artificial desarrollado por investigadores de instituciones como University of Washington, Stanford University y University of Southern California. El trabajo, disponible en arXiv el 8 de octubre de 2026, investiga cómo los robots humanoides pueden reaccionar físicamente ante objetos en movimiento sin depender de cámaras externas ni sistemas de seguimiento.
El desafío va más allá de alcanzar una caja en el aire. Para completar la tarea, el robot debe posicionar los antebrazos, utilizar el tronco como apoyo, absorber el impacto y mantener el objeto seguro sin perder el equilibrio. Tocar la caja no basta: es necesario capturarla y sostenerla.
El robot alcanzó un 65% de aciertos, frente al 85% de los participantes humanos
En las pruebas físicas, los investigadores compararon el rendimiento del Unitree G1 con el de tres participantes humanos, sometidos a lanzamientos similares.
A 2,5 metros, el robot registró 65% de éxito, frente al 85% de los humanos. Cuando la distancia aumentó a 5 metros, las tasas cayeron a 40% y 68,3%, respectivamente.
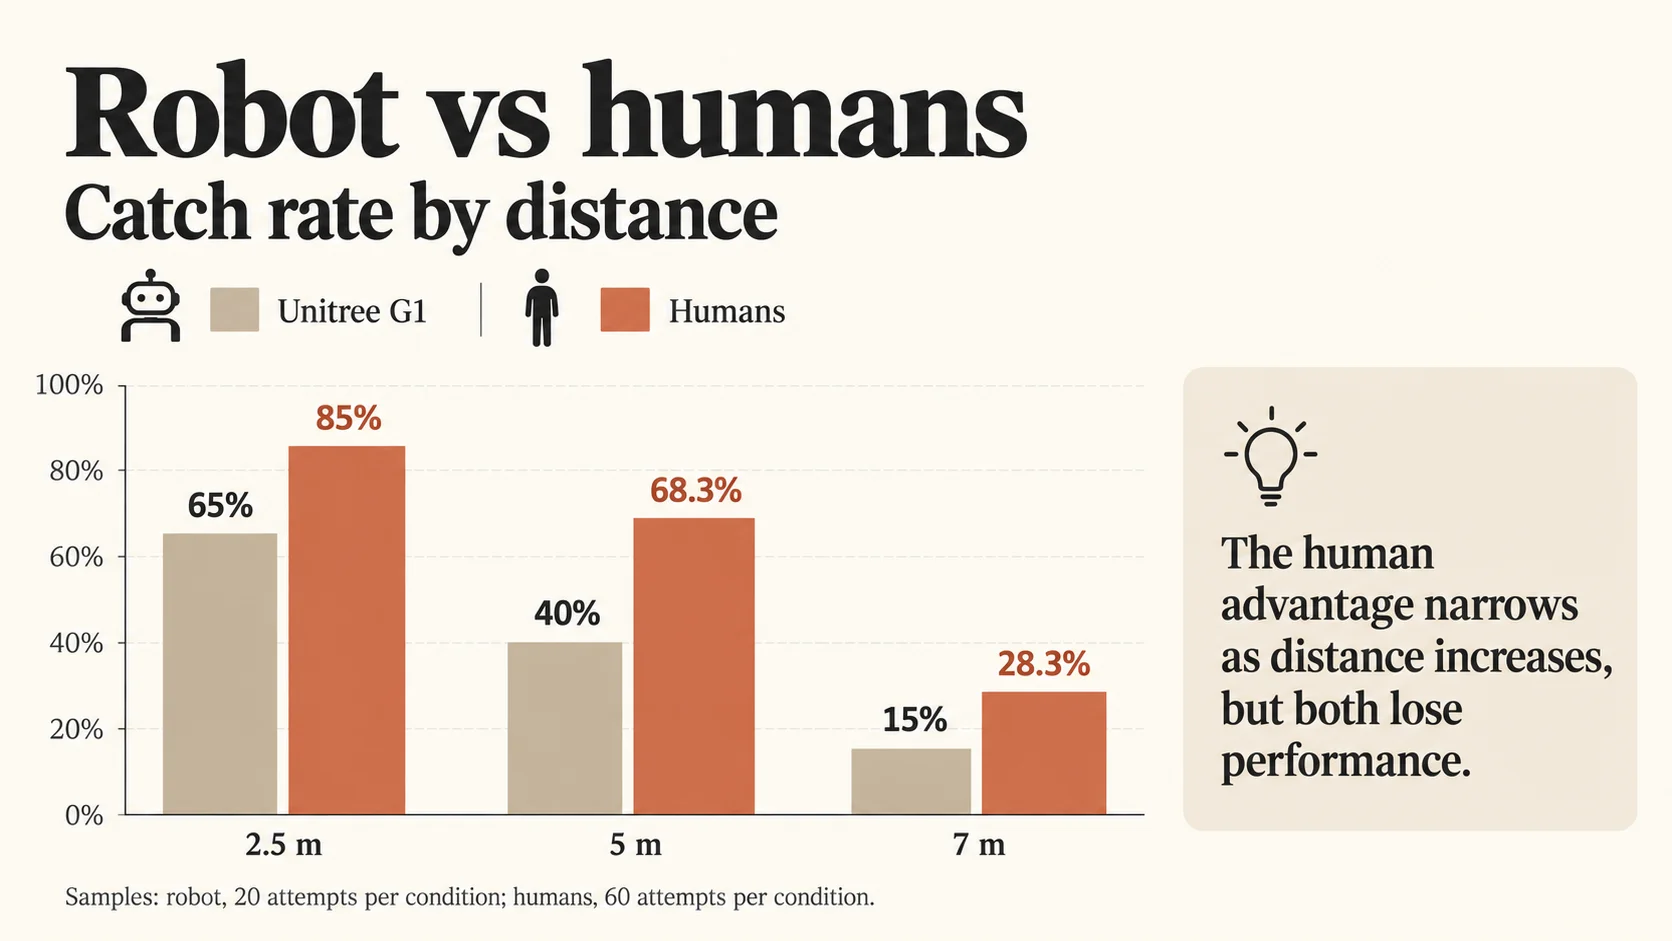
A los 7 metros, la dificultad fue evidente para ambos: el G1 capturó apenas el 15% de las cajas, mientras que los participantes humanos alcanzaron el 28,3%.
Cada condición involucró 20 intentos con el robot y 60 con los humanos. Los resultados muestran una capacidad física efectivamente demostrada, pero aún distante de la consistencia humana en las condiciones evaluadas.
El rendimiento también varió según las características de los objetos. En las pruebas con cajas de diferentes dimensiones, el robot logró capturar el 20% de las más pequeñas y el 45% de las más grandes, aunque alcanzó físicamente algunas que no logró sostener.
Esa diferencia revela una dificultad importante: interceptar un objeto en movimiento no significa necesariamente conseguir retenerlo.
El secreto está en prever el movimiento, no solo en ver la caja
La principal contribución científica de Reflex está en la manera en que percepción visual y control corporal trabajan juntos.
El sistema se desarrolló en tres etapas. Primero, el robot aprendió movimientos de captura mediante aprendizaje por refuerzo en simulación, recibiendo información detallada sobre la posición de la caja. Después, fue entrenado para lidiar con información incompleta y retrasada sobre el movimiento del objeto.
En la última etapa, los investigadores enseñaron a un modelo visual a extraer esa información de las imágenes producidas por la cámara del propio robot, que combina colores y profundidad.
Esto es especialmente difícil porque la cámara está instalada en el tronco. Cuando el G1 se mueve, el escenario también cambia de posición en las imágenes. Además, los propios brazos pueden ocultar parcialmente la caja en los instantes previos al contacto.
Para superar esas dificultades, Reflex considera una secuencia de imágenes, lo que permite estimar cómo se desplaza el objeto a lo largo del tiempo.
Un experimento reveló la importancia de esa estrategia.
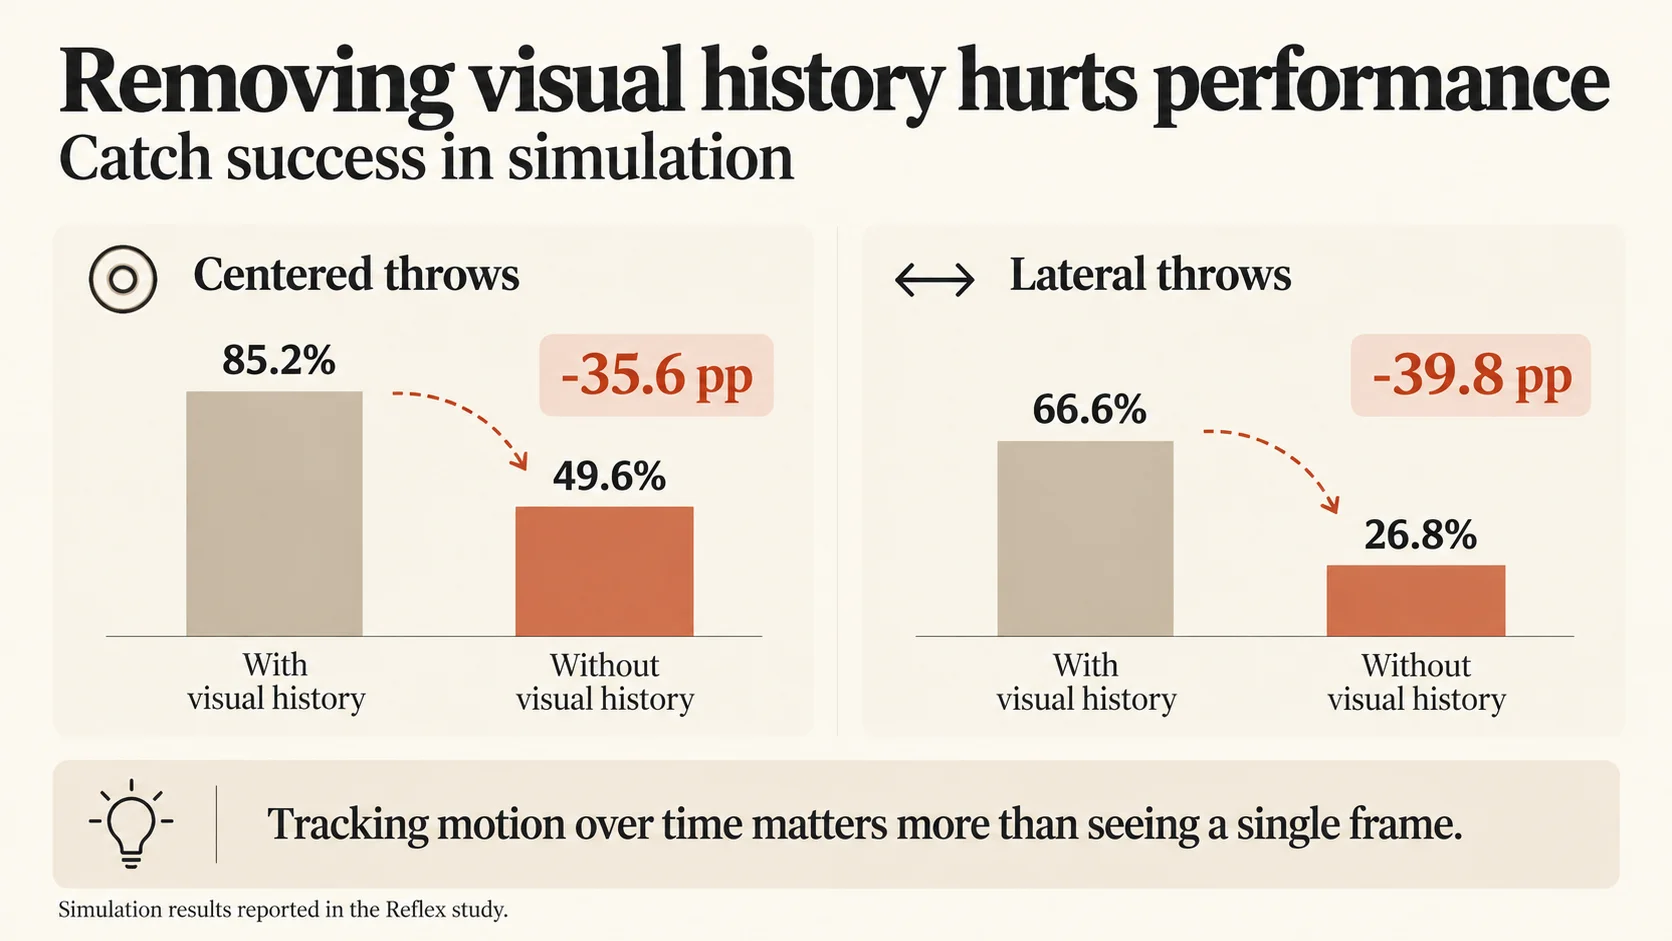
En simulación, cuando los investigadores eliminaron el historial visual y dejaron que el sistema trabajara solo con una imagen instantánea, la tasa de captura cayó de 85,2% a 49,6% en los lanzamientos centralizados.
En los lanzamientos desplazados lateralmente, la caída fue aún mayor: de 66,6% a 26,8%.
Son reducciones de 35,6 y 39,8 puntos porcentuales, respectivamente. El resultado muestra que reconocer la posición actual de la caja es insuficiente para ejecutar la tarea con la misma eficacia. El robot necesita seguir su desplazamiento y anticipar dónde ocurrirá el contacto.
En la evaluación principal en simulación, el sistema completo alcanzó 85,7% de éxito en 3.840 lanzamientos, un rendimiento cercano al 87,9% obtenido por una configuración que recibía información privilegiada sobre el objeto.
La proximidad entre los resultados sugiere que el modelo visual logró recuperar gran parte de la información necesaria para el control corporal. Sin embargo, esto no significa que la misma precisión se haya reproducido en las pruebas físicas.
Capturar la caja es solo parte del desafío
Los investigadores también demostraron una secuencia más compleja: el Unitree G1 capturaba una caja, caminaba cargando el objeto, lo entregaba a una persona y regresaba a la posición inicial.
Para realizar esa secuencia, Reflex se combinó con otro controlador responsable de la locomoción y de la entrega.
El resultado expuso una limitación importante. De los 20 intentos realizados, solo cinco completaron todas las etapas, una tasa de éxito del 25%.
La investigación también presenta restricciones estadísticas. Con solo 20 intentos por condición en los experimentos físicos, las tasas observadas presentan intervalos de incertidumbre considerables, que pueden alcanzar aproximadamente 20 puntos porcentuales hacia arriba o hacia abajo.
Otra dificultad está en la percepción visual a distancias mayores. En las pruebas simuladas, la precisión cayó significativamente con lanzamientos más largos y rápidos que los utilizados en el entrenamiento visual. Ampliar esos datos mejoró los resultados en simulación, pero esa mejora aún no se ha validado en el robot físico.
El trabajo permanece disponible como preprint, sin validación independiente identificada.
Reflex, por lo tanto, no demuestra que los humanoides ya puedan manipular objetos lanzados con confiabilidad general. Su resultado más relevante es otro: un robot logró combinar visión propia, predicción de trayectoria y movimientos coordinados de todo el cuerpo para reaccionar a un objeto en aproximadamente un segundo, una capacidad fundamental para interacciones físicas más dinámicas.