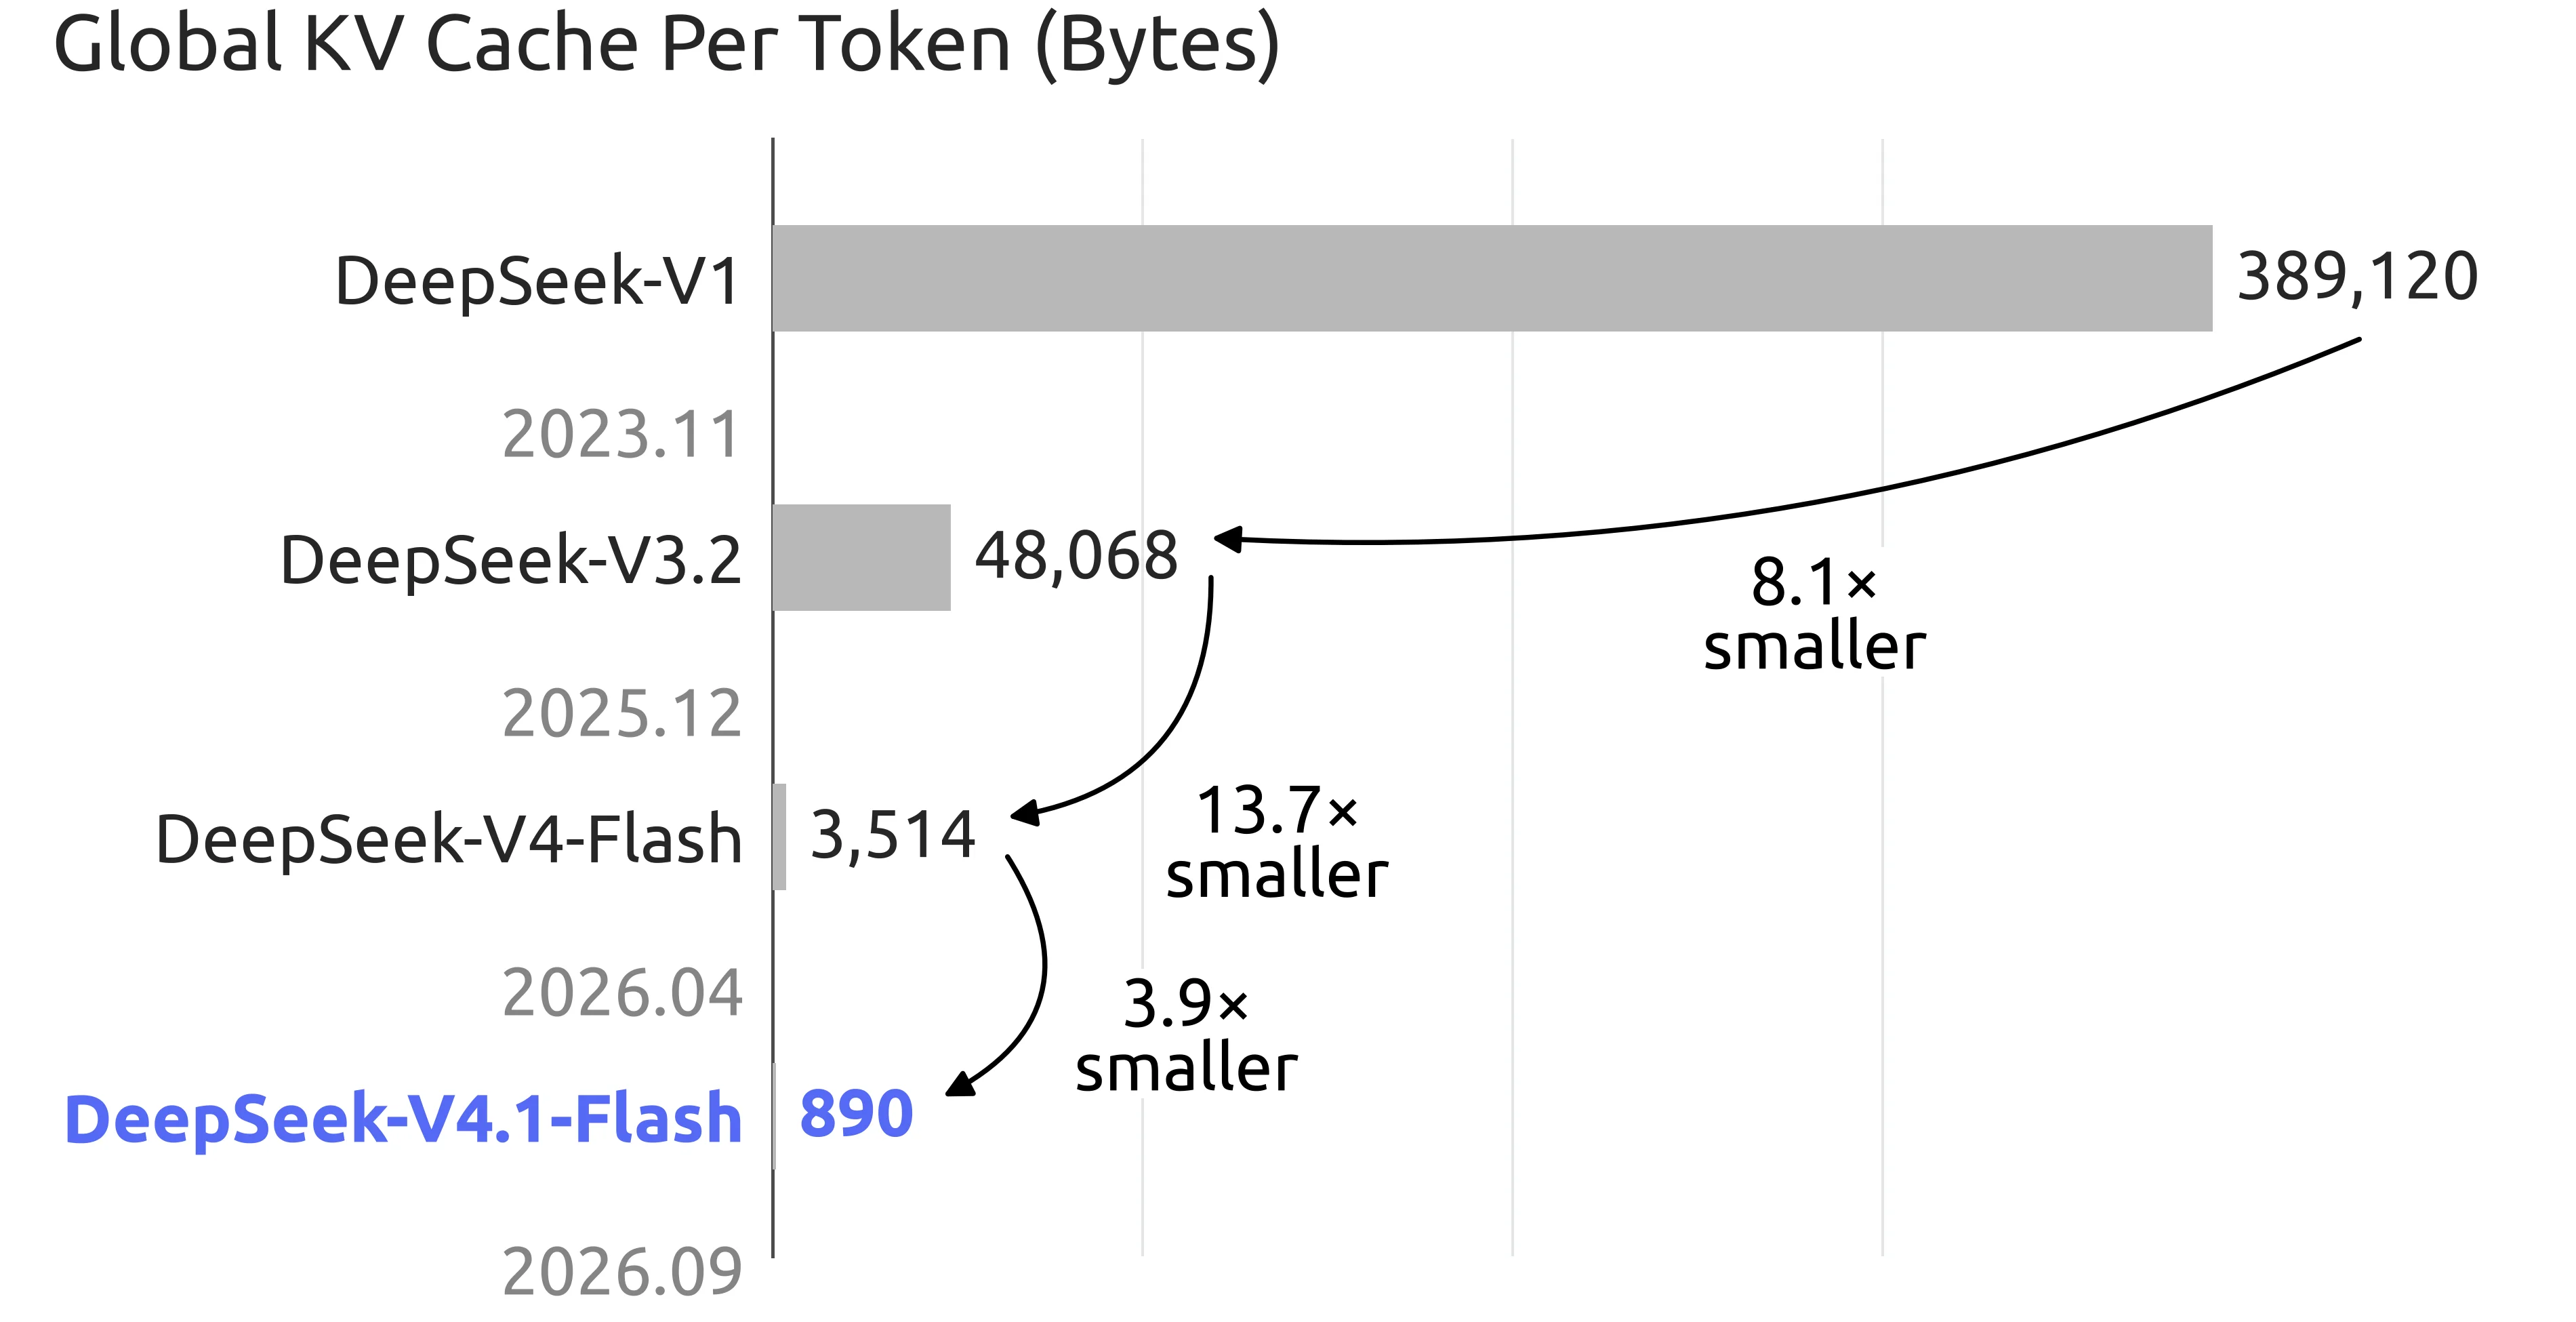
DeepSeek anunció el V4.1-Flash, el primer modelo de una nueva arquitectura de la empresa, con un rendimiento superior al V4-Pro en distintos benchmarks y una reducción significativa en el consumo de memoria. El nuevo modelo requiere alrededor de un cuarto de la HBM y un octavo del almacenamiento SSD utilizados por el KV cache de la generación anterior.
El V4.1-Flash utiliza arquitectura Mixture-of-Experts (MoE) con 552 mil millones de parámetros, pero activa solo 8 mil millones en el procesamiento de la entrada y 16 mil millones durante la generación de la respuesta. La propuesta es reducir el costo computacional sin comprometer el rendimiento.
El modelo también incorpora visión multimodal nativa y soporte para contextos de hasta 1 millón de tokens. Según DeepSeek, cambios en el preentrenamiento y en el postentrenamiento permitieron al Flash superar al V4-Pro en distintas evaluaciones.
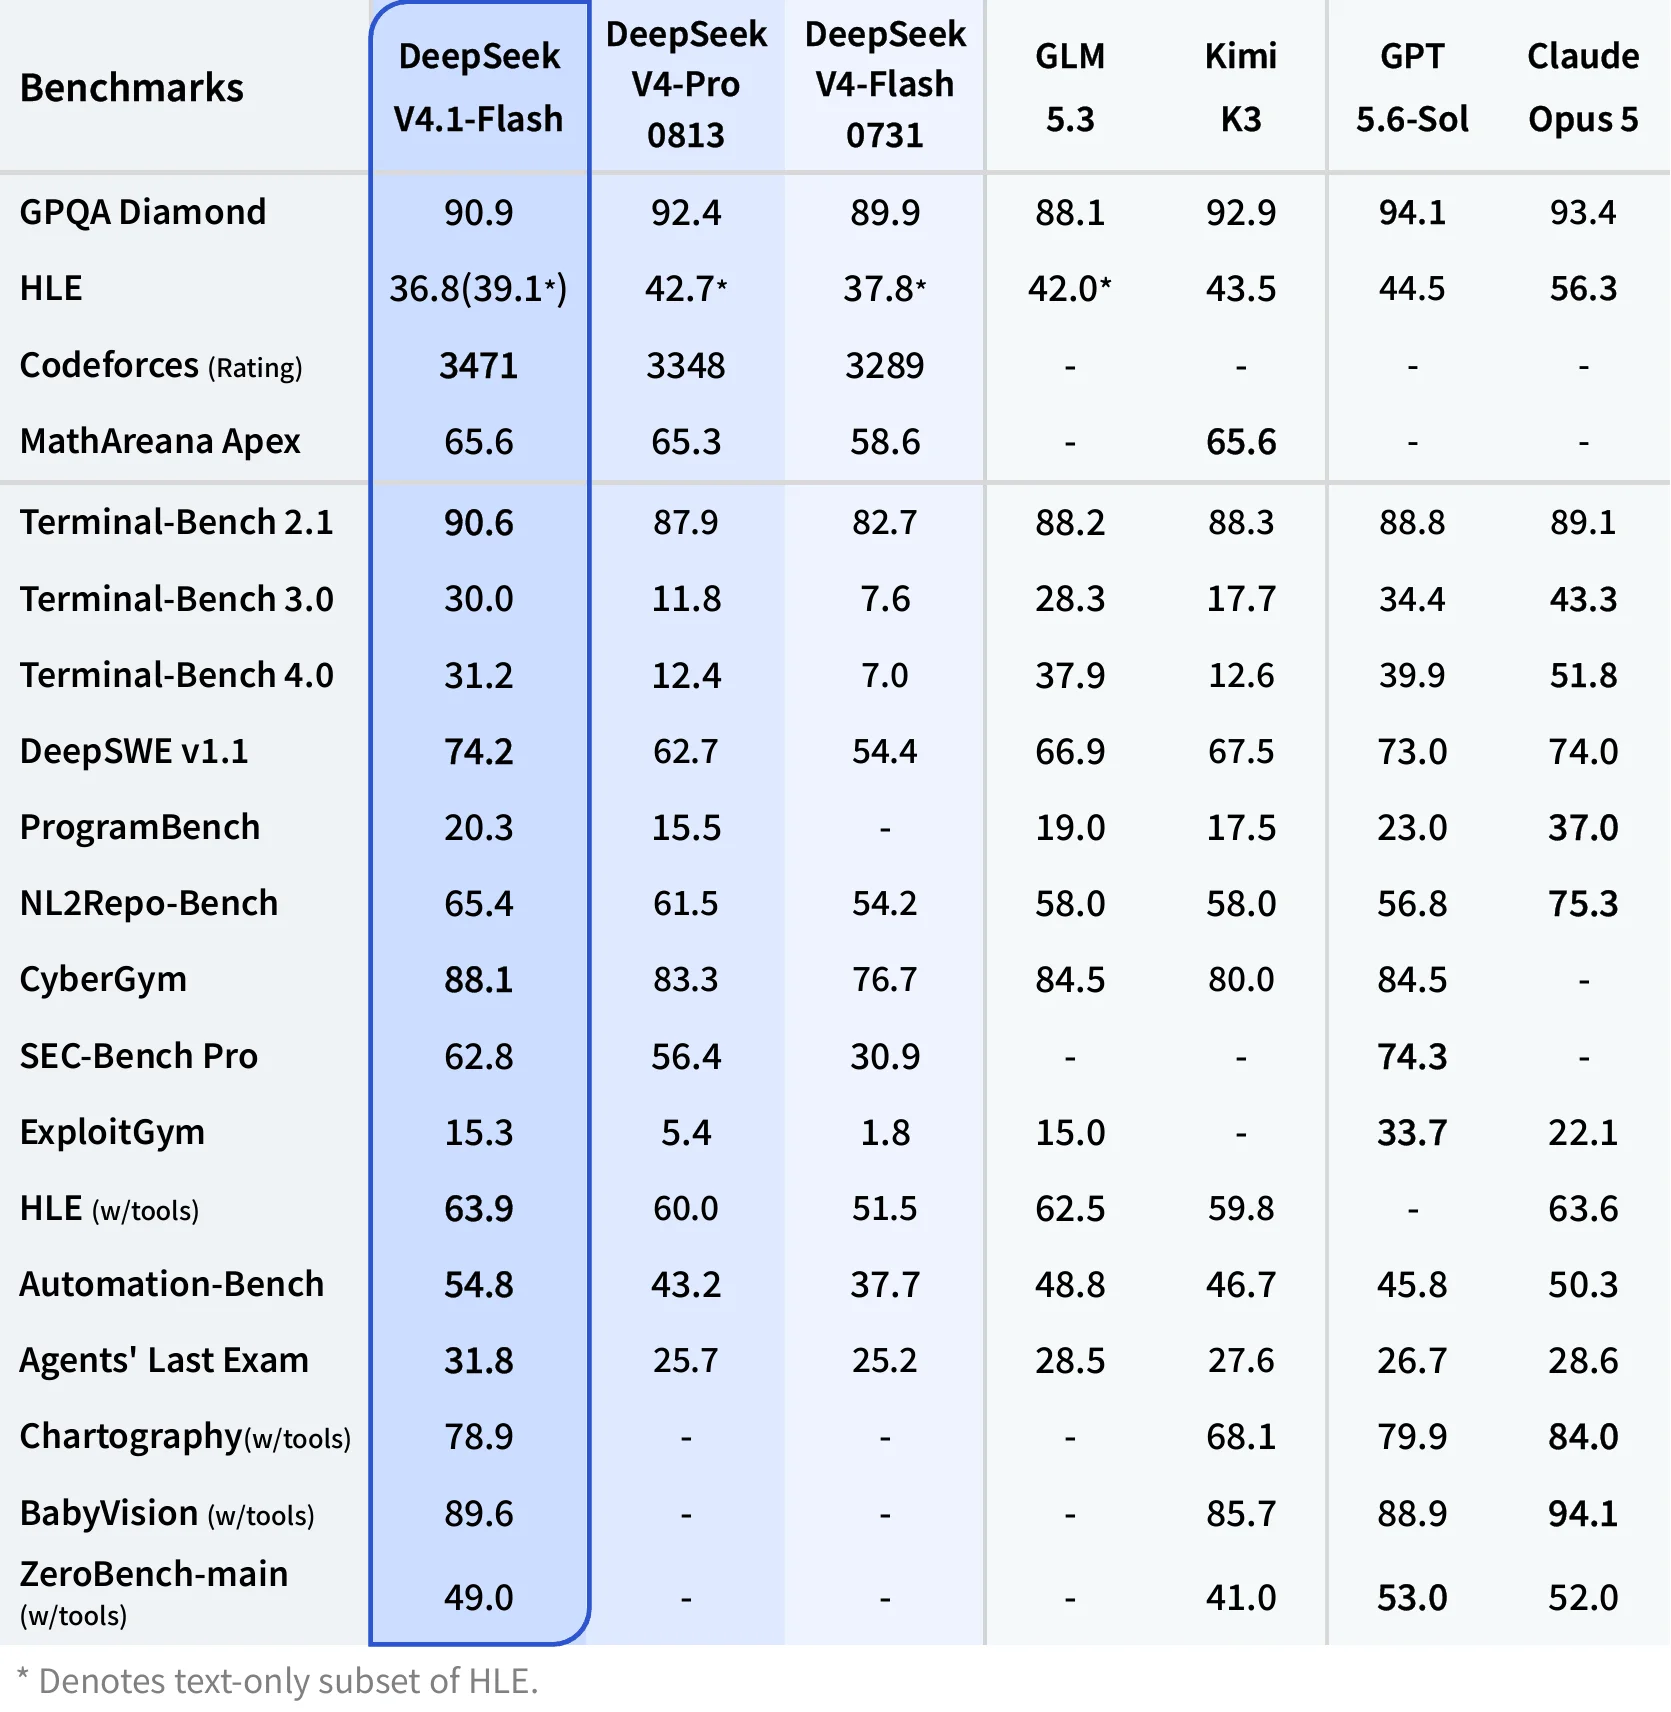
Flash sustituirá temporalmente al V4-Pro
A partir del 14 de septiembre, las solicitudes enviadas al identificador deepseek-v4-pro serán dirigidas al V4.1-Flash. El redireccionamiento continuará hasta el lanzamiento del futuro V4.1-Pro.
La decisión coloca temporalmente al nuevo Flash en el lugar del modelo Pro de la empresa, aunque pertenece a una línea orientada a una mayor eficiencia.
La nueva arquitectura también reduce la cantidad de memoria necesaria para mantener el KV cache, estructura usada para almacenar el contexto durante la inferencia. Esta ganancia es especialmente relevante en cargas con grandes volúmenes de tokens.
DeepSeek también redujo los precios de la API. El V4.1-Flash ya está disponible con el identificador deepseek-flash, y los pesos del modelo se liberaron para su uso fuera de la infraestructura de la compañía.


