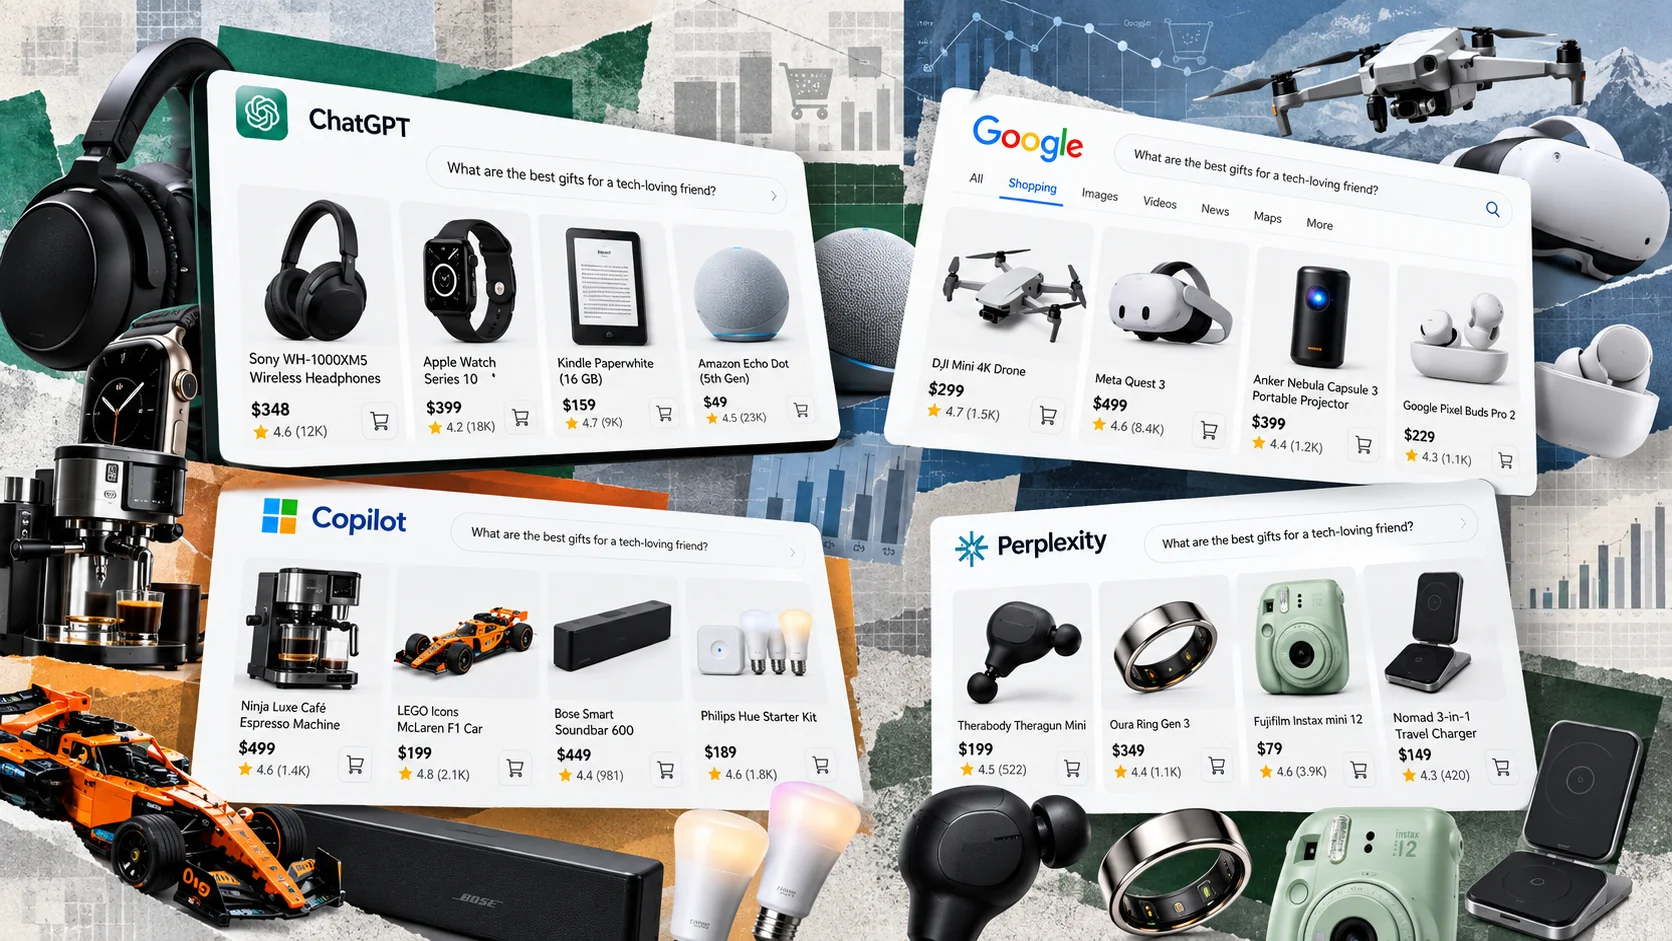
Uma pesquisa divulgada pela AEOsome Research em outubro de 2026 identificou grandes diferenças nas recomendações de compras do ChatGPT, Google AI Mode, Microsoft Copilot e Perplexity. Apenas 1,6% das perguntas feitas aos quatro assistentes resultaram na exibição de cartões de produtos em todas as plataformas.
O levantamento analisou 30.855 respostas, divididas entre dois experimentos realizados no primeiro semestre. A comparação principal reuniu 22.335 respostas sobre sete categorias de produtos, incluindo eletrônicos, beleza, saúde e artigos domésticos.
Os pesquisadores consideraram recomendações apenas os cartões estruturados que apresentavam nome do produto, preço e link para um comerciante. Menções a marcas no texto não entraram na contagem.
Nesse conjunto, o Google AI Mode apresentou cartões em 64,4% das respostas, seguido pelo Microsoft Copilot, com 44,5%, ChatGPT, com 28,5%, e Perplexity, com apenas 5%.
A diferença revela que a presença de produtos nas respostas depende fortemente da plataforma utilizada, embora os resultados também variem conforme o tipo de pergunta e o modelo responsável pelo atendimento.
Apenas 1,6% das perguntas exibiram produtos nos quatro assistentes
Entre as 5.583 perguntas respondidas por todas as plataformas, 21,9% não produziram cartões em nenhuma delas, enquanto 31,7% resultaram em recomendações estruturadas em apenas um assistente.
Mesmo quando duas plataformas exibiam produtos, as seleções raramente coincidiam. A sobreposição entre produtos específicos variou de 1% a 5%, conforme a combinação de assistentes analisada. Para marcas, o índice ficou entre 25% e 42%.
O estudo também identificou diferenças na estabilidade das respostas do ChatGPT. Ao repetir perguntas idênticas, os pesquisadores observaram que a presença ou ausência de cartões mudou em 42,4% dos pares de respostas.
Grande parte dessa oscilação esteve associada ao modelo utilizado. Quando o mesmo modelo respondeu às duas consultas, houve concordância em 90,2% dos casos. Quando o modelo mudou, a concordância caiu para 25,5%.
Essa diferença ajuda a explicar o resultado agregado do ChatGPT. O modelo GPT-5.3 mini, responsável por aproximadamente 60% das respostas coletadas, apresentou cartões em somente 3,7% das consultas. Já os modelos GPT-5.5 e GPT-5.3 registraram taxas de 65,3% e 72,2%, respectivamente.
Assim, a média de 28,5% não representa o comportamento uniforme do ChatGPT e precisa ser interpretada considerando a distribuição dos modelos durante os testes.
Os experimentos foram realizados nos Estados Unidos, em inglês, entre fevereiro e maio de 2026, utilizando interfaces web sem login. Os resultados não medem vendas ou conversões e não permitem determinar se o mesmo comportamento permanece nas versões atuais dos assistentes.
A AEOsome, que também comercializa serviços de visibilidade de produtos em sistemas de IA, publicou a metodologia e as limitações do levantamento. Os resultados apresentados não contam com reprodução independente identificada.