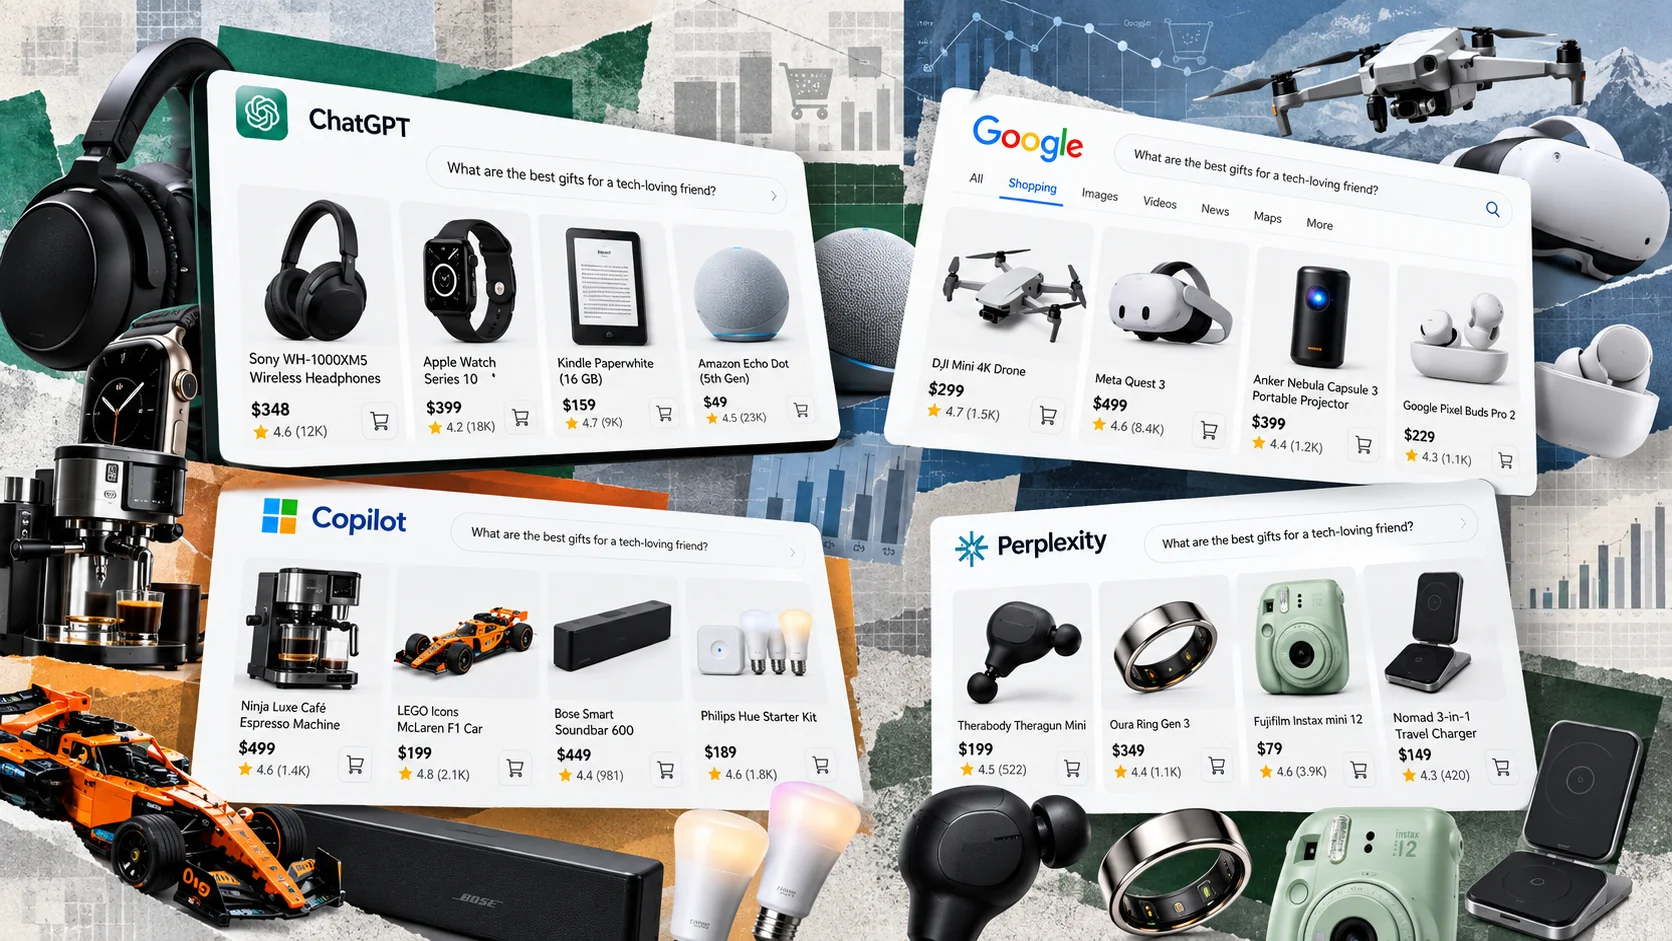
Una investigación difundida por AEOsome Research en octubre de 2026 identificó grandes diferencias en las recomendaciones de compras de ChatGPT, Google AI Mode, Microsoft Copilot y Perplexity. Solo el 1,6% de las preguntas formuladas a los cuatro asistentes dio como resultado la visualización de tarjetas de productos en todas las plataformas.
El estudio analizó 30.855 respuestas, divididas entre dos experimentos realizados en el primer semestre. La comparación principal reunió 22.335 respuestas sobre siete categorías de productos, que incluyen electrónica, belleza, salud y artículos domésticos.
Los investigadores consideraron recomendaciones solo las tarjetas estructuradas que presentaban nombre del producto, precio y enlace a un comerciante. Las menciones a marcas en el texto no entraron en el conteo.
En ese conjunto, el Google AI Mode presentó tarjetas en el 64,4% de las respuestas, seguido de Microsoft Copilot, con 44,5%; ChatGPT, con 28,5%; y Perplexity, con apenas 5%.
La diferencia revela que la presencia de productos en las respuestas depende en gran medida de la plataforma utilizada, aunque los resultados también varían según el tipo de pregunta y el modelo responsable de la atención.
Solo el 1,6% de las preguntas mostró productos en los cuatro asistentes
Entre las 5.583 preguntas respondidas por todas las plataformas, el 21,9% no generó tarjetas en ninguna de ellas, mientras que el 31,7% generó recomendaciones estructuradas en un solo asistente.
Incluso cuando dos plataformas mostraban productos, las selecciones rara vez coincidían. La superposición entre productos específicos varió del 1% al 5%, según la combinación de asistentes analizada. Para las marcas, el índice se situó entre el 25% y el 42%.
El estudio también identificó diferencias en la estabilidad de las respuestas de ChatGPT. Al repetir preguntas idénticas, los investigadores observaron que la presencia o ausencia de tarjetas cambió en el 42,4% de los pares de respuestas.
Gran parte de esa oscilación estuvo asociada al modelo utilizado. Cuando el mismo modelo respondió a las dos consultas, hubo concordancia en el 90,2% de los casos. Cuando el modelo cambió, la concordancia cayó al 25,5%.
Esa diferencia ayuda a explicar el resultado agregado de ChatGPT. El modelo GPT-5.3 mini, responsable de aproximadamente el 60% de las respuestas recopiladas, presentó tarjetas en solo el 3,7% de las consultas. Por su parte, los modelos GPT-5.5 y GPT-5.3 registraron tasas de 65,3% y 72,2%, respectivamente.
Así, el promedio de 28,5% no representa el comportamiento uniforme de ChatGPT y debe interpretarse considerando la distribución de los modelos durante las pruebas.
Los experimentos se realizaron en Estados Unidos, en inglés, entre febrero y mayo de 2026, utilizando interfaces web sin inicio de sesión. Los resultados no miden ventas ni conversiones y no permiten determinar si el mismo comportamiento se mantiene en las versiones actuales de los asistentes.
AEOsome, que también comercializa servicios de visibilidad de productos en sistemas de IA, publicó la metodología y las limitaciones del estudio. Los resultados presentados no cuentan con una reproducción independiente identificada.